11772 分
GPT-6 Sol 与 Luna:价格更低、智能体效率更高,但基准测试的解读也更复杂
OpenAI 表示,GPT-6 Sol 和 Luna 将 Astra 级能力扩展到速度更快、价格更低的层级,同时改进提示词缓存和 API 经济性。独立基准测试页面证实了部分分数和方法细节,但不断变化的排行榜以及依赖投入程度的成本意味着,购买者应在自己的工作流中验证实际性能。
阅读全文 →OpenAI 表示,GPT-6 Sol 和 Luna 将 Astra 级能力扩展到速度更快、价格更低的层级,同时改进提示词缓存和 API 经济性。独立基准测试页面证实了部分分数和方法细节,但不断变化的排行榜以及依赖投入程度的成本意味着,购买者应在自己的工作流中验证实际性能。
阅读全文 →Anthropic 表示,Opus 5.5 在典型工作负载下的成本降低了 40%,同时提升了编码与安全表现。其公布的价格支持这一说法的部分内容,但相互冲突的基准数据以及有限的独立证据,使实际节省幅度更不确定。
阅读全文 →Crypto Cellar Research 报告称,GPT-6 Astra 协助破解了一封自 2005 年以来一直未能分析的 1941 年恩尼格玛电报。所提出的密钥和明文与现存证据异常吻合,但这一说法尚未经过独立、可复现的自主密码分析验证。
阅读全文 →科林·布雷克认为,AI 生成的文字之所以常常不尽如人意,是因为读者无法获得提示撰写者所掌握的语境。一项匿名开发者调查显示,人们一旦察觉文章可能使用了 AI,信任感便可能受损;但现有证据只能支持一个更谨慎的结论:当文字已经由人完成构思和塑造后,AI 在检查、编辑和格式化方面或许最能发挥作用。
阅读全文 →FBI表示正在调查 fbijobs.gov 遭入侵及员工信息可能泄露的说法。该声明没有证实攻击者所称的影响范围,也没有确认被盗数据的具体内容。
阅读全文 →报道描述了 Apple News 中反复出现、类似诈骗的广告。近期注册的域名提供了警示信号,而非欺诈证据;同时,Apple 的捆绑订阅页面包含 News+,却没有承诺提供无广告版本。
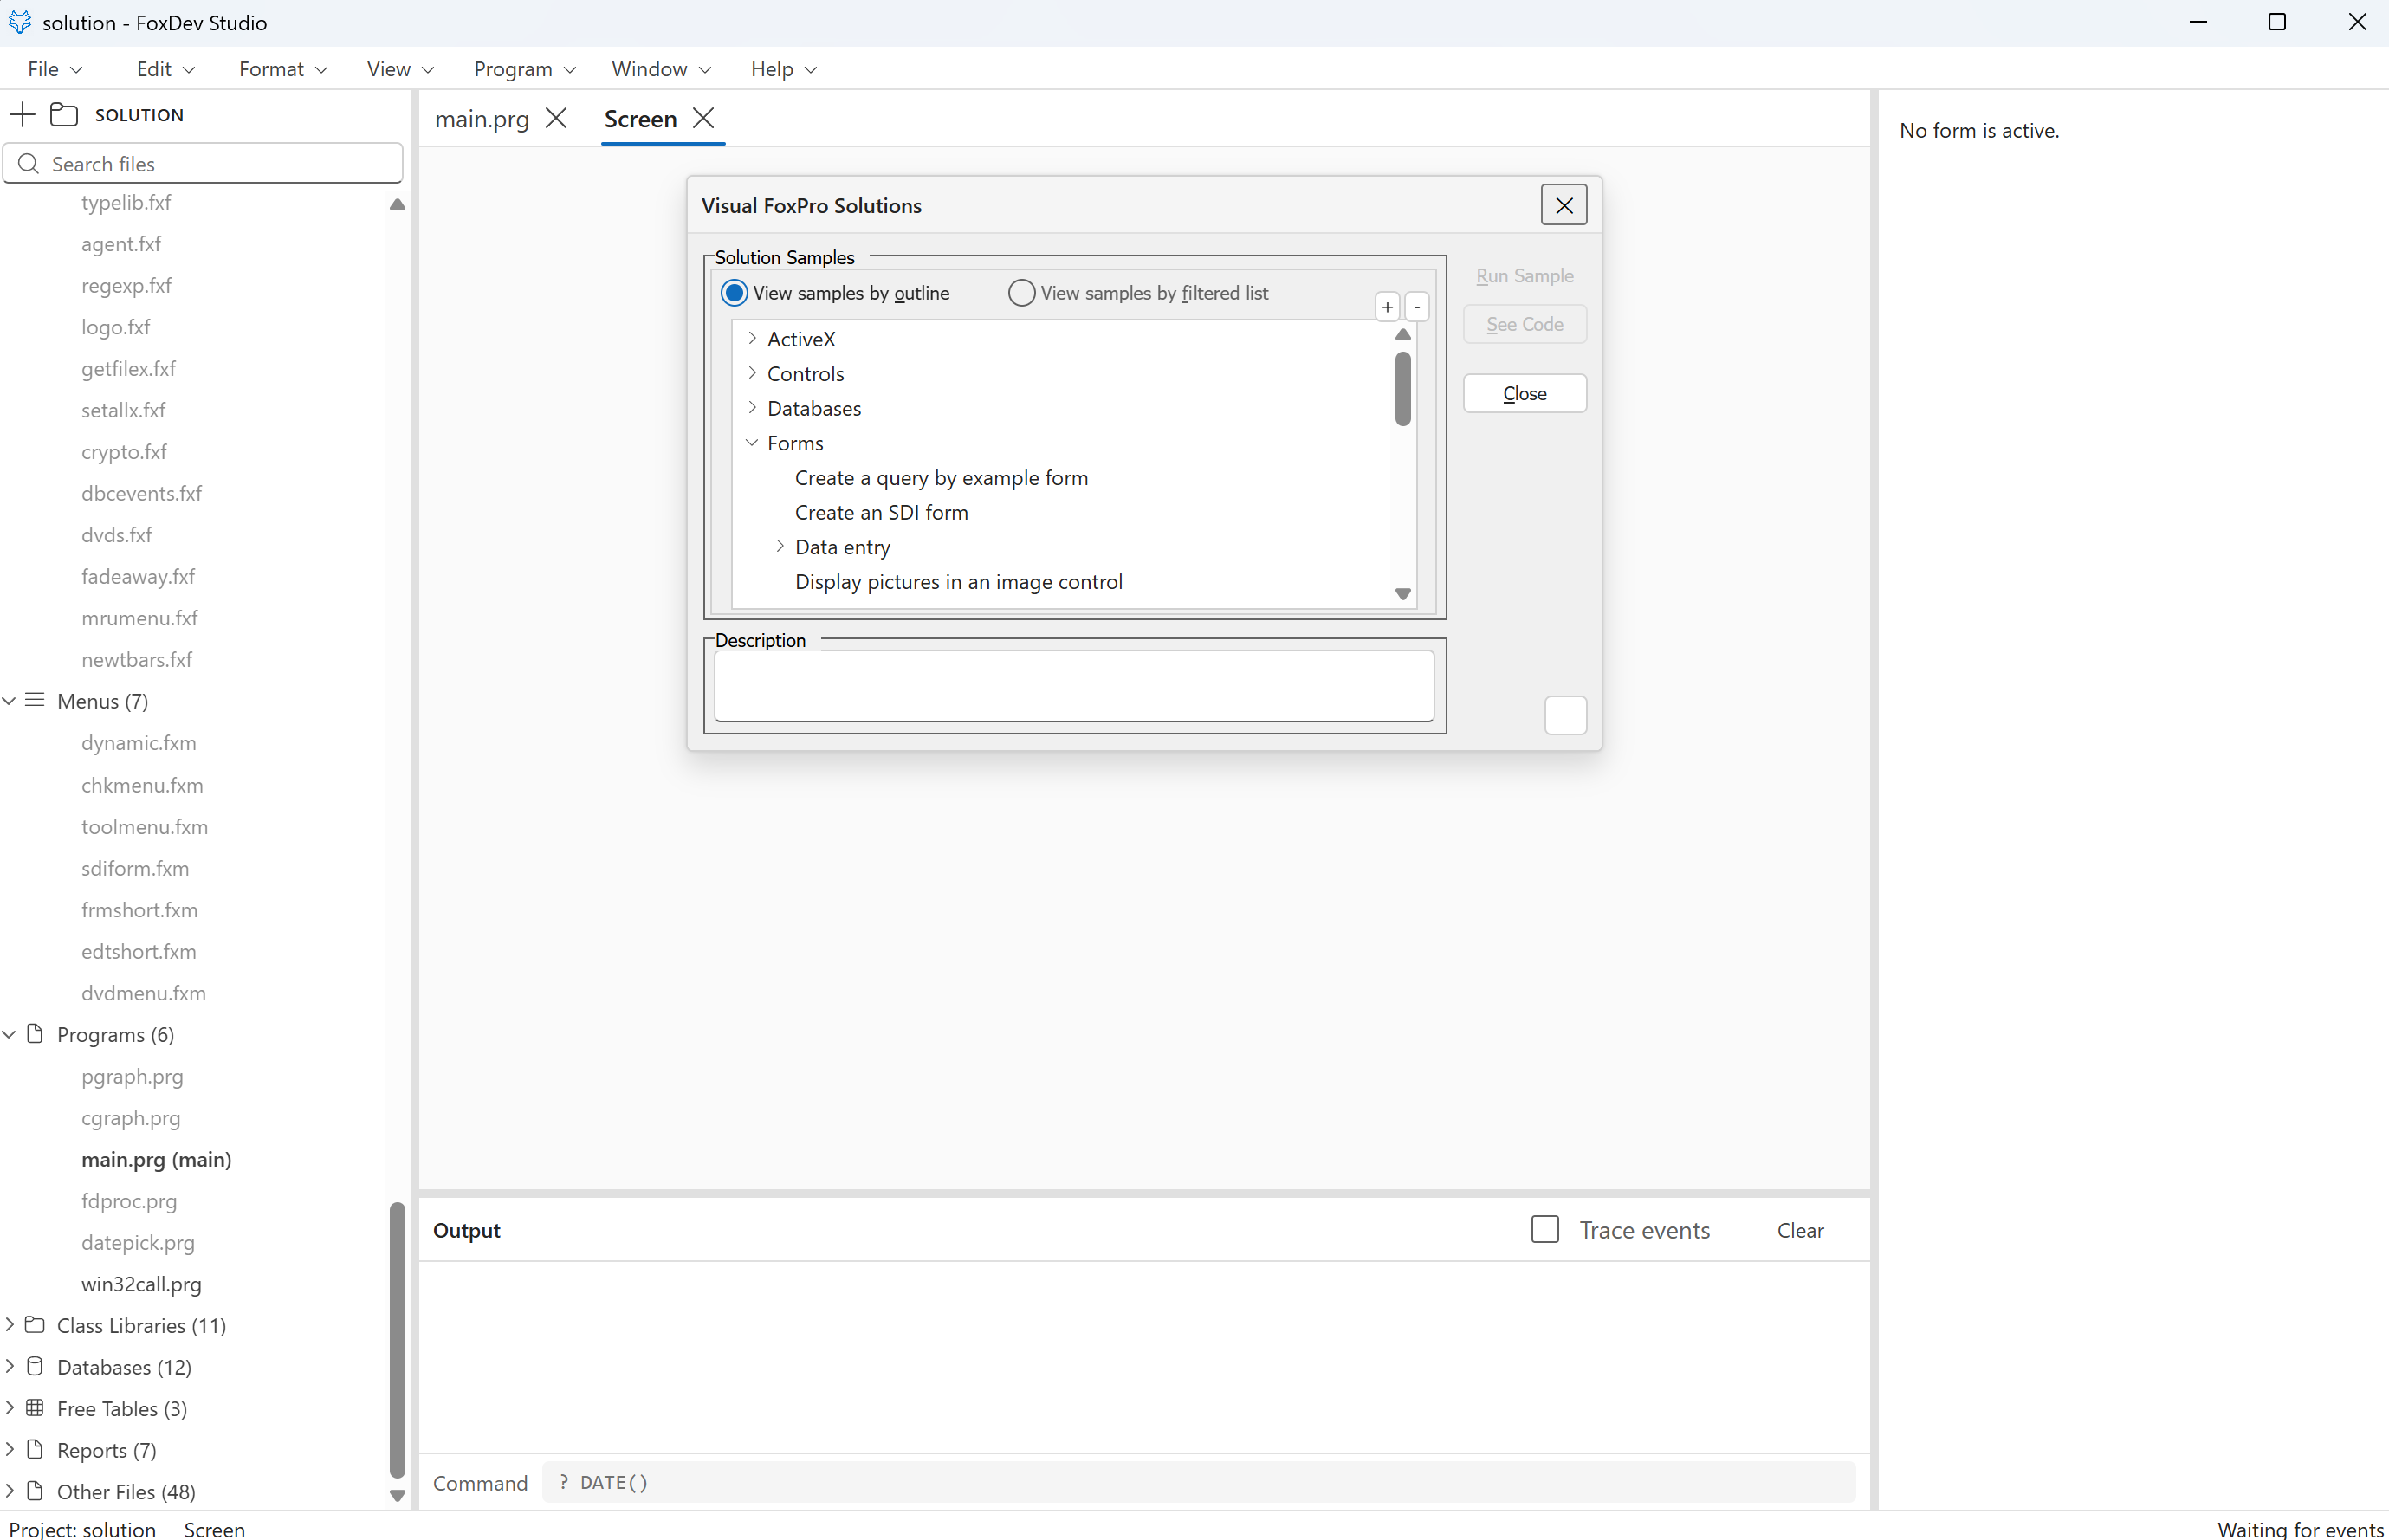
阅读全文 →FoxDev Studio 是由 FoxDevCommunity 社区构建的 Visual FoxPro 9 环境,可直接打开现有项目与数据,无需转换,同时加入 64 位执行能力和基于 WebAssembly 的运行时。它最有力的承诺是延续性;最明确的局限则是,其兼容性仍在对照微软多年前就已停止开发的产品进行衡量。
阅读全文 →brand.io的一篇文章主张,把用户无法看见或控制的隐藏信号称为“间谍标记”,而不是笼统地称作“水印”。Google将SynthID描述为不可感知的内容识别工具,相关技术论文则报告了大规模部署和鲁棒性测试。
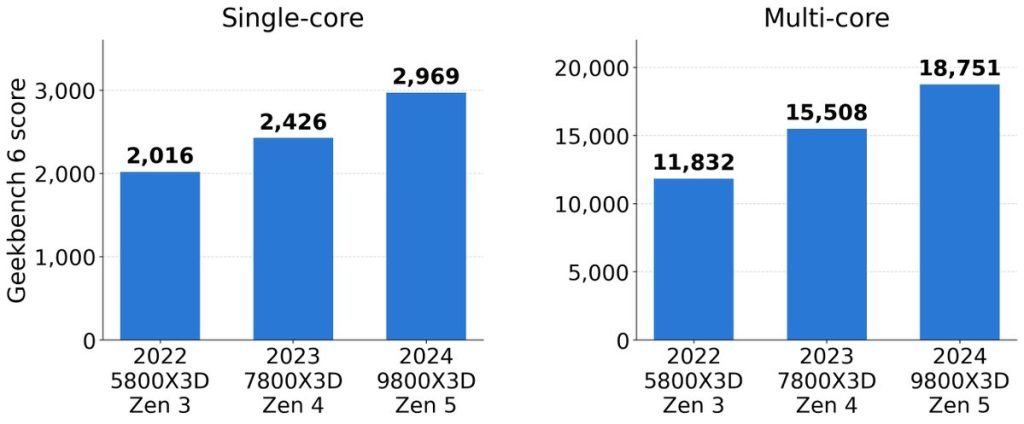
阅读全文 →Daniel Lemire 的 Geekbench 6 对比显示,从 5800X3D 到 9800X3D 的性能提升,与其说是时钟频率提升的关系较小,更多源于更宽的核心、更大的缓存、更多的执行资源以及更宽的向量单元。
阅读全文 →WordPress 公告 GHSA-7hp8-65ch-5whp 介绍了 CVE-2026-87902。这是一个无需身份验证即可触发的缺陷,但只有在特定主题、文件系统和 PHP 配置条件同时满足时,才可能演变为远程代码执行。从 WordPress 4.7 到 7.1 的每个受影响分支均已发布修复版本。
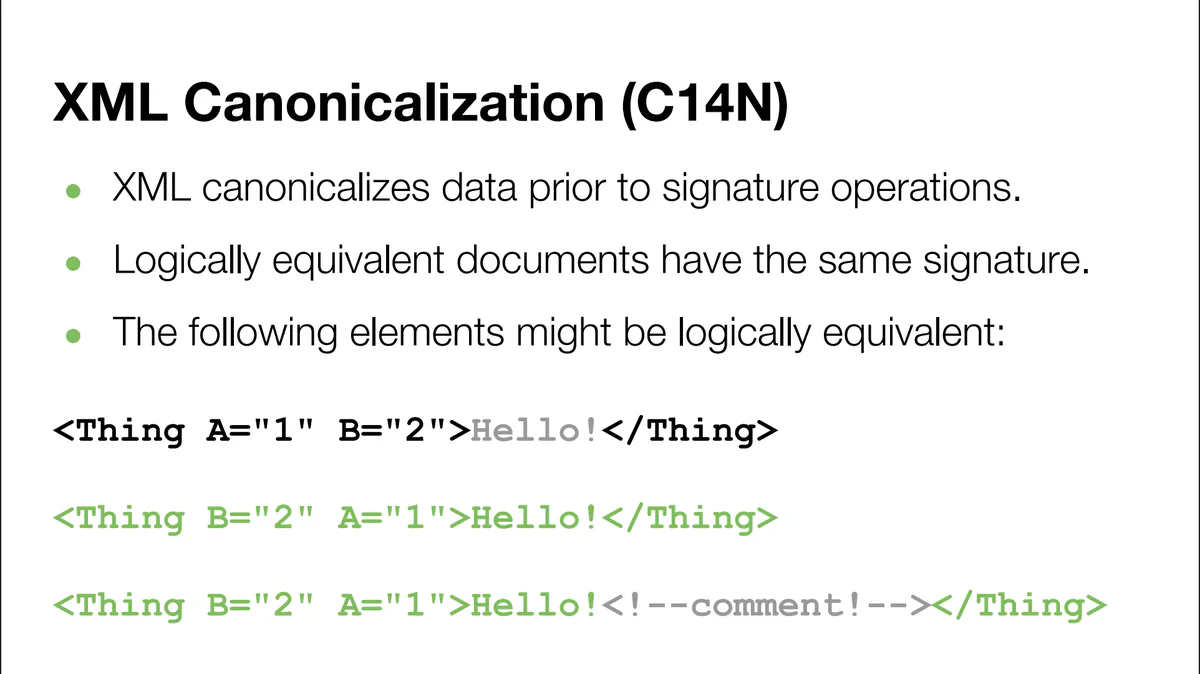
阅读全文 →Trail of Bits 认为,SAML 基于 XML 的设计、签名处理方式以及广泛的功能集合,会带来持续存在的安全与维护风险。实际启示并不是每一种 SAML 部署都存在缺陷,而是组织应当了解该协议的失效模式,并在评估替代方案时不要默认它们毫无风险。
阅读全文 →Vercel 的发布数据显示,TypeSafe 的概率决策模型在早期需求强劲,但这并不能证明 Jev 的架构具有新颖性、其准确率值得信赖,或 OpenAI 将会模仿它。更关键的问题在于,快速且结构化的分类能否成为人工智能系统中一项持久的能力。
阅读全文 →Anthropic 的 Max 套餐每月收费 100 或 200 美元,分别提供 Pro 每个会话额度的五倍或二十倍。套餐仍有上限,而使用容量增加并不代表模型更强。
阅读全文 →一名 macOS 用户报告称,系统升级后,一个可见的 Apple Intelligence 退出选项消失了,同时留下了 22.28 GB 的占用空间,由此提出了一个现实问题:隐藏在深处的控制项是否仍能构成有意义的同意机制?现有证据支持作者对其所见情况的描述,但不足以确定 Apple 的意图、全部网络行为,或每一项设置的技术含义。
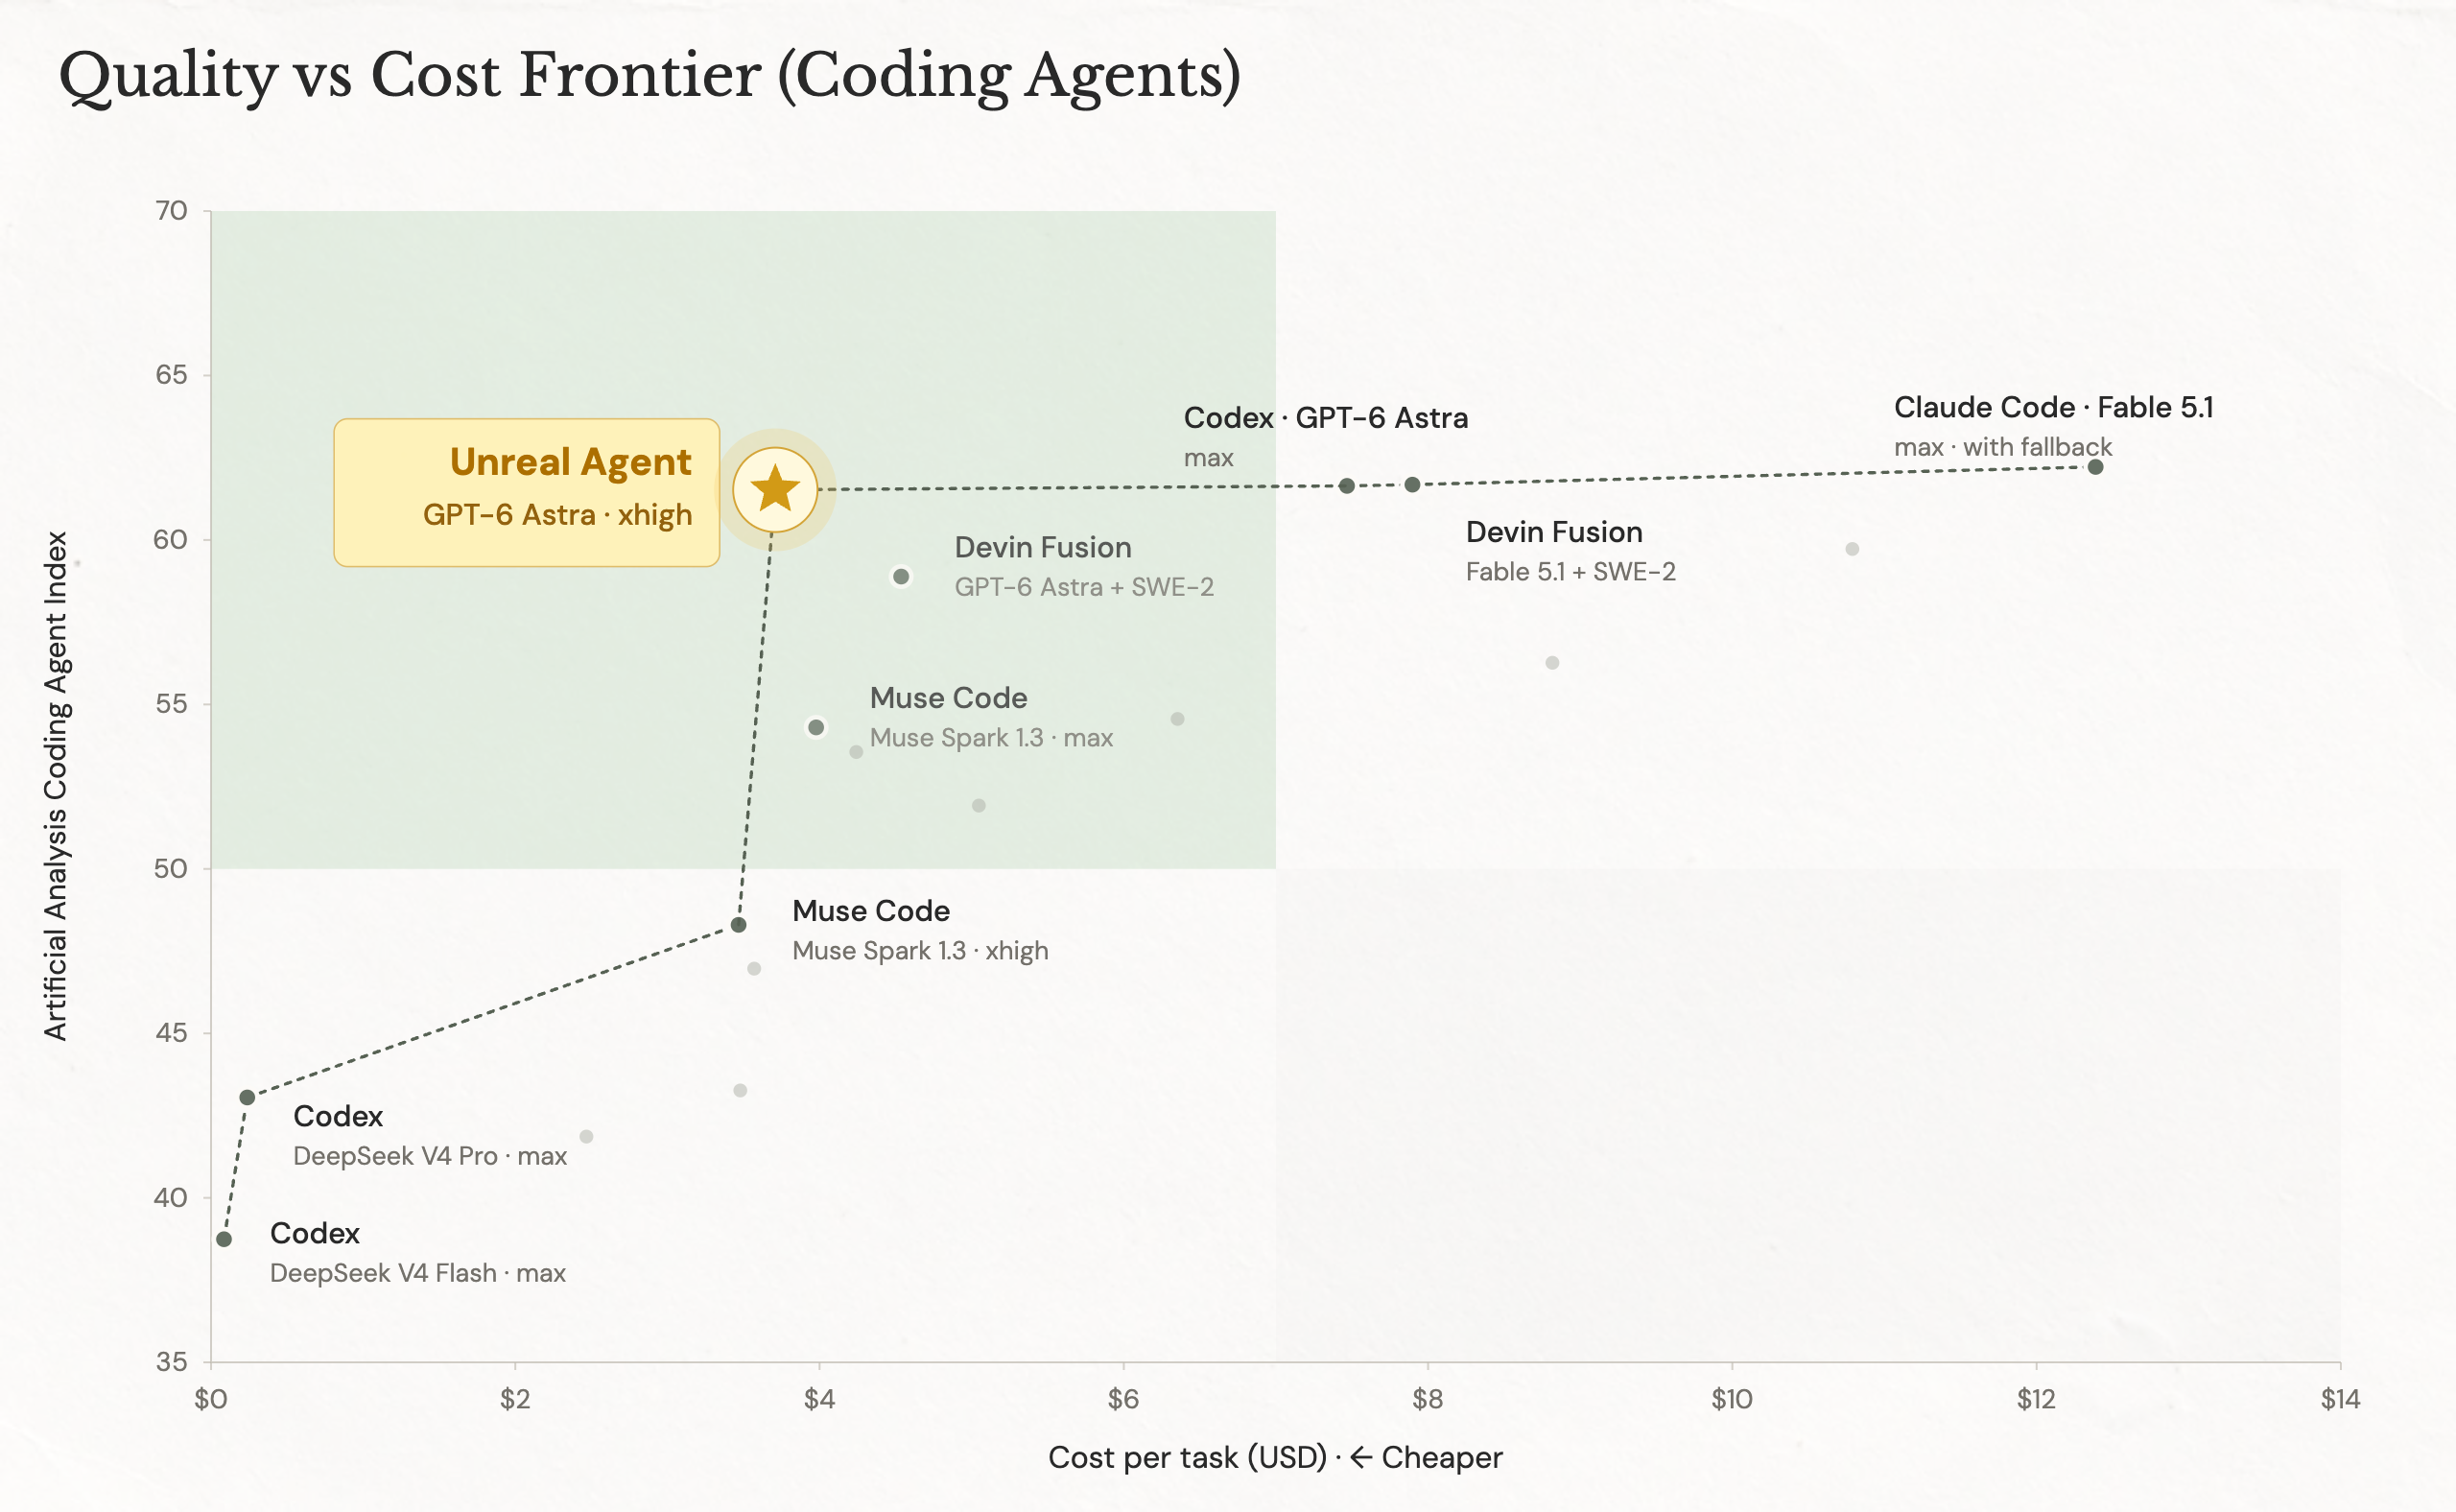
阅读全文 →Unreal Labs 表示,其 Go 语言工具框架允许工具在后台运行,同时模型仍可接收引导输入并启动其他工作,从而减少等待时间和令牌用量。该公司 2026 年 9 月 22 日公布的测试结果显示,在四项编程测试中,其成本低于 Codex 和 Pi,且通过率相近;但这些证据既不能证明普遍可节省 40% 的成本,也不能证明各比较系统采用了完全相同的模型和设置。
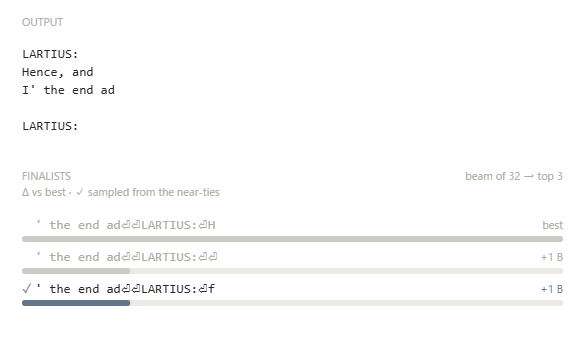
阅读全文 →一项基于 zlib 的实验通过根据压缩后的长度评估候选续写,将 gzip 的 DEFLATE 算法变成了简陋的文本生成器。结果表明预测与压缩之间存在等价关系,但由于上下文有限、按字节评分且输出未经编辑,这项实验并不能证明它已成为实用或经过学习的语言模型。
阅读全文 →Muni 传统周末活动将旧金山的公共交通历史转化为仍在运行的设备,而非静态展品。2026 年的活动汇集了从 1912 年的先驱车型到澳大利亚电车的多种车辆,而 162 号电车漫长的修复过程,则展现了保存公共交通历史所需的专业劳动、稀有部件和运营决策。
阅读全文 →Git 的下一个大版本预计将把 SHA-256 仓库设为默认,把引用存储切换为 reftable,并要求构建过程使用 Rust。现有证据支持这一方向,但迁移流程、平台影响和工具兼容性方面仍有一些重要问题尚未解决。
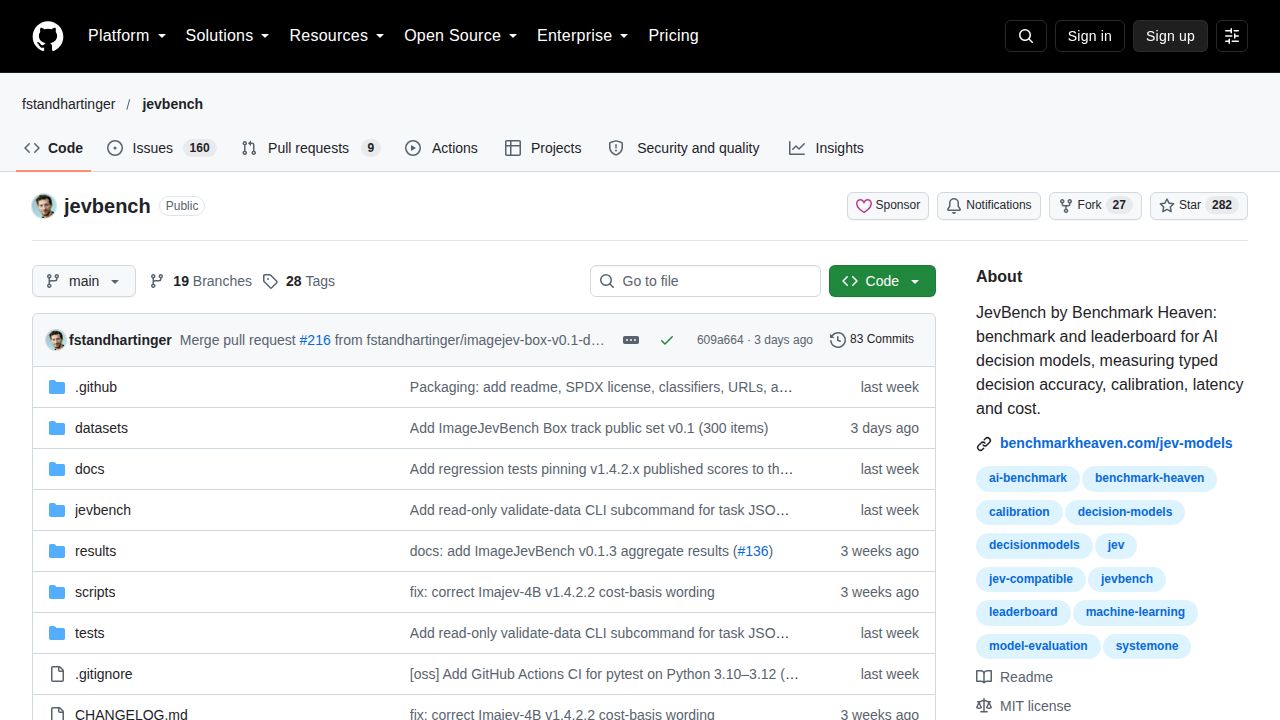
阅读全文 →JevBench v1.4.2将decider-4b v2排在第一,Jev 1.13.0排第二。维护者表示,新封存的308道题只公布汇总结果,并对公开题与封存题表现差距过大的系统扣分。
阅读全文 →Carson Gross 主张,智能体编程团队应将经过审阅的设计意图以 Markdown 形式持久保存在生成代码旁边,并据此派生测试。这一提议很有前景,但作者明确认为它仍是暂时性的方案;其主要未解决问题,是如何让描述代码的文字与代码本身保持同步。
阅读全文 →GeaStack 的示例仓库展示了一组由清单驱动、面向 Web、ESP32 和 GeaOS 目标的小型 TSX 应用。它本身并不能证明每个应用都会被编译成本地二进制,也不能证明所有 JavaScript 和 TypeScript 语义都能在不同目标之间原样工作。
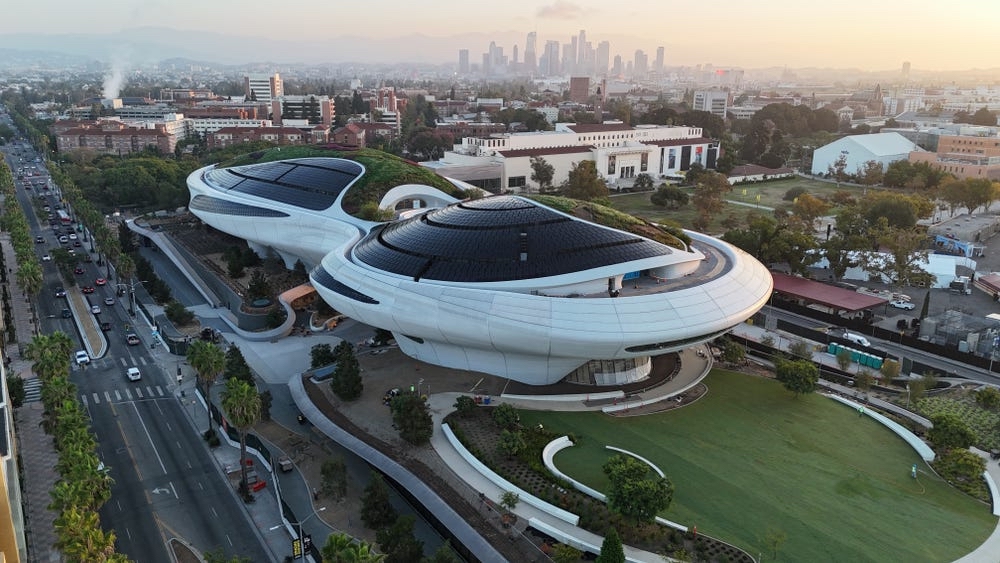
阅读全文 →乔治·卢卡斯位于洛杉矶的新博物馆,将古代雕塑、文艺复兴绘画、摄影、漫画、电影道具和大众娱乐纳入同一套馆藏。这种异常宽泛的策展主张,比建筑宛如科幻造物的外观更具深远意义;但仅凭一次建筑预览,仍无法判断这座博物馆作为公共机构将如何运作。
阅读全文 →柏拉图《斐德罗篇》中的一段论述批评文字,并不只是因为它是新生事物,而是因为静止的文字无法回答问题、适应读者,也无法防止自身遭到误解。其启示并非文字毫无价值,而是持久的文本最好与阐释、对话和审慎核验相结合。
阅读全文 →