从通常意义上说,gzip 无法生成散文。Nathan Barry 在 nathan.rs 上发表的一项小型实验表明,标准压缩算法仍然可以用来选择与给定语料库相似的文字。这一区别十分重要:该项目并没有赋予 gzip 学习得到的权重、神经网络,或当代语言模型所具备的广泛泛化能力。它揭示的是预测与无损压缩之间的等价关系,并围绕这种等价关系构建了一个条件生成器。
这项名为 GziPT 的实验使用 Python 的 zlib,而不是另行启动一个 gzip 进程。Barry 表示,两者都依赖 DEFLATE。DEFLATE 会在最近 32 KiB 的窗口中寻找重复的字节序列;当这样做比直接输出原始字节更节省空间时,它会用后向引用表示匹配项。因此,重复或密切呼应压缩器当前可见内容的续写,可能获得较短的编码。压缩后的长度由此成为评分依据:产生更小编码文件的候选文本,会被视为根据当前上下文更容易预测。
这种评分规则遵循一种标准的信息论关系。如果模型为某个符号赋予概率 p,那么最优编码大约会使用 −log₂(p) 比特来表示它。概率较高的符号所需比特更少,出人意料的符号所需比特更多。arXiv 论文《Language Modeling Is Compression》于 2023 年 9 月 19 日首次提交,并于 2024 年 3 月 18 日修订。论文指出,预测模型与无损压缩器可以相互转换。其摘要还表示,可以利用这种等价关系,从包括 gzip 在内的任何压缩器构建条件生成模型。这正是 Barry 试图验证的理论突破口。
评分并不等同于生成。选择即时压缩长度最低的下一个字节,效果往往很差,因为 gzip 报告的是整字节长度,这会造成大量并列结果,并掩盖评分信号。GziPT 改为对字节序列进行束搜索。它会用语料库中出现的字节扩展仍然保留的候选项,压缩每一段拟议的文本,保留压缩性最高的 beam_width 个部分续写,然后针对一定数量的字节重复这一过程。随后,它会提交最佳片段;如果设置了正的温度参数,也会从最终候选项中抽样,然后重新开始。
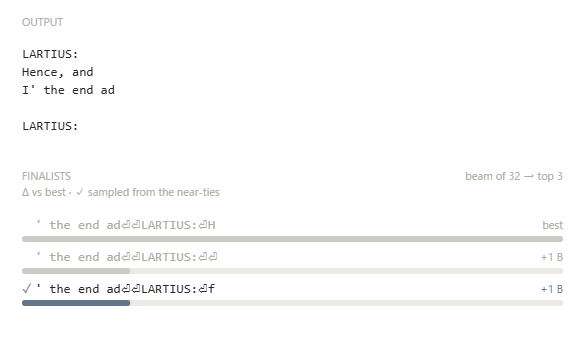
回放画面展示了GziPT如何按压缩后的长度给多个续写候选评分,并从优选结果中作出选择。原页面未说明图像的使用权。
上下文设计尤其能说明问题。Barry 表示,评分上下文由语料库窗口,加上提示词和已生成文本中最近的一小部分尾部组成。如果保留完整历史,字面重复会变得十分廉价,从而鼓励生成器陷入循环。限制尾部内容可以降低这种失败模式发生的概率,但也会削弱连贯性:生成器无法维持长篇论证、完整情节或一组约束条件。因此,它表现出的知识是局部且机械的,并不能证明 DEFLATE 已经获得了对语言的独立表征。
所附文章包含一段未经编辑的 200 字节续写,生成时先以 Tiny Shakespeare 作为语料进行预热,再输入提示词“MENENIUS:”。输出中出现了可以辨认的人名和戏剧片段,但并不构成连贯的对话。Barry 将这一结果形容为对文本有所了解,却又并非完全连贯。这一评价与样本相符,但它仍然是作者作出的定性判断,而不是基准测试结果。资料包没有提供困惑度、人工评分、与更强基线模型的比较,或对输出质量的受控研究。
论文自身的摘要指出,此前采用这种方法的一次尝试表现不佳,而 Barry 则报告称,束搜索显著改善了生成质量。不应把这些说法合并成“gzip 如今已经能够与神经语言模型竞争”的结论。该论文主要把大型基础模型作为压缩器进行评估,并分别报告了 Chinchilla 70B 的压缩结果;这些结果并不能验证 GziPT 生成的莎士比亚文本,也不能确立通用文本生成器之间的排名。
实际启示是概念性的。压缩提供了一种可观察、可量化的方法,用来判断某段续写是否符合上下文中已经存在的模式,而同一套机制也可以支持条件生成。同样重要的限制在于:压缩器奖励的是可压缩性,而不是真实性、实用性、原创性或语义理解。GziPT 展示了信息论与文本生成之间一座巧妙的桥梁,但现有证据只支持将其称为一项按压缩效果评分的实验,而不是通用语言模型。