科林·布雷克的核心批评,并不只是 AI 写出的文字听起来千篇一律。他认为,AI 文字往往缺少一种必要的视角,无法告诉读者什么最重要、哪些地方仍不确定,以及何处需要作出判断。一份由机器生成的设计文档可能详尽描述所有改动,却掩盖了提出这项改动的原因、哪些风险值得关注,以及作者希望获得什么样的反馈。结果,文字可能变得更长,信息量却并未增加。
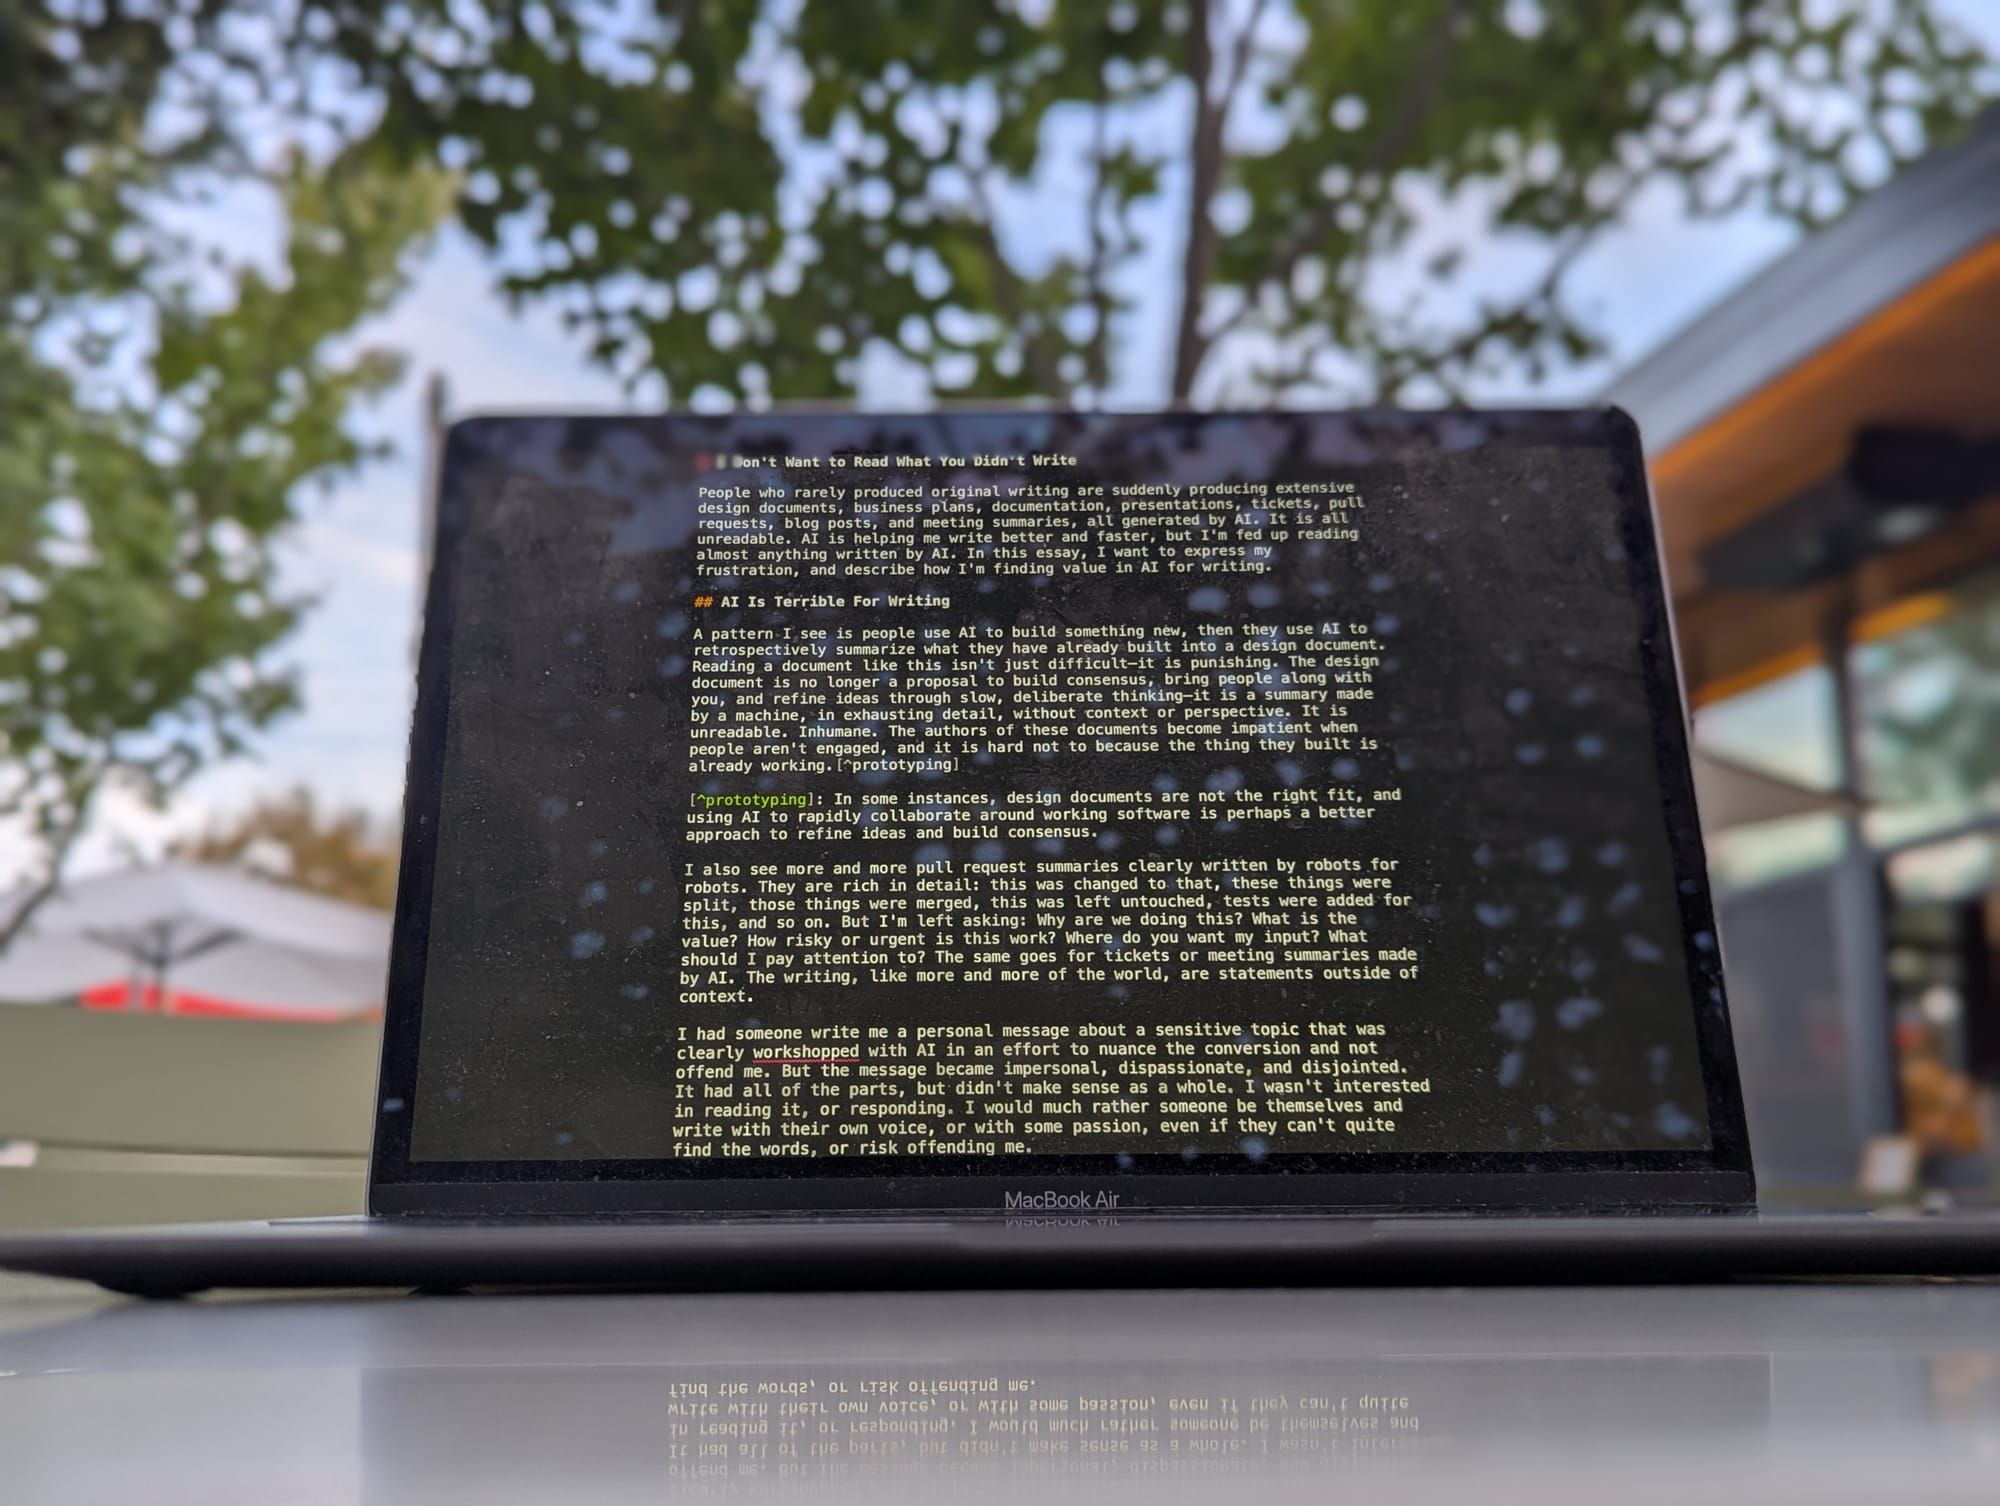
文章开篇介绍了科林·布雷克的观点:AI 写作经常省略必要的视角,因而无法解释一项改动为何重要,以及何处仍需作出判断。 来源及署名:blog.colinbreck.com。
这种语境鸿沟有助于解释,为什么文档的创建者可能觉得它很有用,而另一位读者却难以理解。提示撰写者提供了约束条件、原始材料、有意省略的内容和预期用途,因此能够还原输出背后的推理过程。接收者得到的却只有最终文本。由于无法接触那条私密的决策链,接收者可能不得不逐句审视,才能判断哪些细节相关、准确或具有实际影响。
这一区别在工程评审中尤为重要。拉取请求摘要即使列出了变更文件、重构内容和测试,仍可能没有指出风险最高的假设,或作者希望评审者帮助判断的关键决策。布雷克的观点意味着,作者应当优先说明目的、紧迫性、风险和希望获得的具体意见,而不是生成越来越冗长、面面俱到的描述。不过,现有证据并不能证明 AI 撰写的评审意见会导致改动被拒;它指出的是一种看似合理的沟通失误,并未衡量这种失误的发生频率,也没有衡量它对评审结果的影响。
读者的反应可能进一步凸显这种失误的代价。辛西娅·邓洛普对 668 名受访者开展的一项匿名调查显示,78% 的人表示,如果怀疑一篇技术文章由 AI 协助或独立撰写,他们会停止阅读;71% 的人表示,未来会避开该作者。调查还显示,98% 的人更喜欢作者自己的文字,包括其中的不完美之处,而不是经 AI 润色的版本。这些数字描述的是看到这项调查并作出回应的人群,未必代表开发者或技术读者整体:调查采用匿名方式,作者也明确指出,受访者人口统计特征没有任何保证。
因此,调查结果并不能证明每一篇由 AI 协助完成的文章都会遭到拒绝,也不能证明读者能够可靠地区分 AI 辅助与 AI 独立创作。它们确实表明,在这一受访者群体中存在一项相关的编辑风险:只要文字露出明显的 AI 痕迹,就可能在读者评估文章的核心洞见之前触发不信任。布雷克引用这项调查,是为了支持自己关于表达风格和注意力的更广泛论点;但调查本身衡量的是受访者声称会有何反应,而不是长期的阅读行为,也不是单篇文章的质量。
布雷克更倾向于有选择地使用 AI。在谈及自己撰写一篇学术论文的经历时,他说,正文由他亲自完成,而 AI 则用于根据源代码、配置、日志和指标核查技术陈述。他还用 AI 补全引用、简化含义不清的句子、查找拼写和语法错误、绘制技术图表,并发现一处记号错误。他表示,让 AI 根据同一批材料生成段落,价值始终较低,有时还会产生不准确的内容。这番陈述只是一位作者的个人经验,并非受控证据,不能证明这种工作流程会对所有写作者都有帮助;但它提供了一种具体替代方案,使人不必把最初的构思和写作也交给 AI。
西蒙·萨里斯将这一根本问题概括为注意力的丧失。他在《拒绝摘要》中主张,摘要可以加快简单知识的学习,却可能让人更难建立对复杂或创造性内容的理解。他的观点属于哲学层面的讨论,并非对不同写作方法的量化比较:压缩内容可能删去一个人形成持久心智模型所需的推理、感官细节和事物之间的联系。这支持了布雷克的警告——高效的文字并不自动等于有效的沟通——但并不能证明所有摘要,或所有 AI 辅助,都会造成同样的结果。
综合这两方面的观点,可以得出一项实用标准。作者可以让 AI 查找不一致之处、检验关键点是否清楚、准备引用,或把已经完成思考的草稿转换成另一种格式。然而,在把结果交给读者之前,作者应当补回缺失的语境:说明所作决定、指出证据、承认不确定性,并标明哪些地方仍需判断。目标不是让人类的文字听起来更不自然,而是确保由人继续对论点、重点和与读者之间的关系负责。