在评估编程智能体时,Unreal Labs 提出了一个容易被人忽视的问题:账单中有多少费用来自模型本身,又有多少来自决定模型何时思考、等待或调用工具的软件?该公司在 2026 年 9 月 22 日对 Unreal Agent 的介绍中表示,传统智能体循环会花费大量时间和令牌管理工具调用,而不是完成底层工作。
其给出的方案是一个异步工具框架。据 Unreal Labs 称,每次工具调用都会立即被记录为“进行中”,而执行则在后台继续。模型可以接收另一条引导消息、发出更多工具调用,或继续处理其他工作,而不必反复轮询任务是否完成。操作结束后,其结果会被追加到会话日志中,随后再次调用模型。该公司表示,这一设计既减少了等待,也降低了完成任务所需的模型调用轮数。
这只是关于该工具框架的主张,并不能证明每个采用它的智能体都会更便宜。Unreal Labs 将节省成本的原因归结为两项设计选择:相对精简的工具和提示词占用,以及模型调用之间更具实效的工具工作。已发布的 GitHub 仓库为其架构描述提供了实质性依据。其中提到一个仅追加的会话存储、一个协调器、一个不得阻塞事件循环的工具转换器,以及负责异步执行的操作管理器。仓库还描述了持久化、可序列化的操作与会话恢复机制,表明这一设计并非只打算用于内存中的演示,而是希望支持更广泛的场景。
基准测试结果解释了这一构想为何会引起关注,但需要仔细解读。在 Terminal-Bench 4.0 中,Unreal Agent 与 Codex 的通过率均为 57.9%;在报告的测试中,Unreal Agent 的成本为 1,428 美元,Codex 为 2,350 美元。Pi 的通过率为 55.0%,成本为 1,827 美元。在 SWE-Atlas Codebase QnA 中,Unreal Agent 的通过率达到 65.8%,成本为 936 美元;相比之下,Codex 的通过率和成本分别为 63.3% 与 1,303 美元,Pi 则分别为 64.0% 与 1,033 美元。这些数字支持的只是一个更有限的结论:在这些测试运行中,这一具体实现的支出低于列出的基线系统,同时取得了相近或略高的实测通过率。
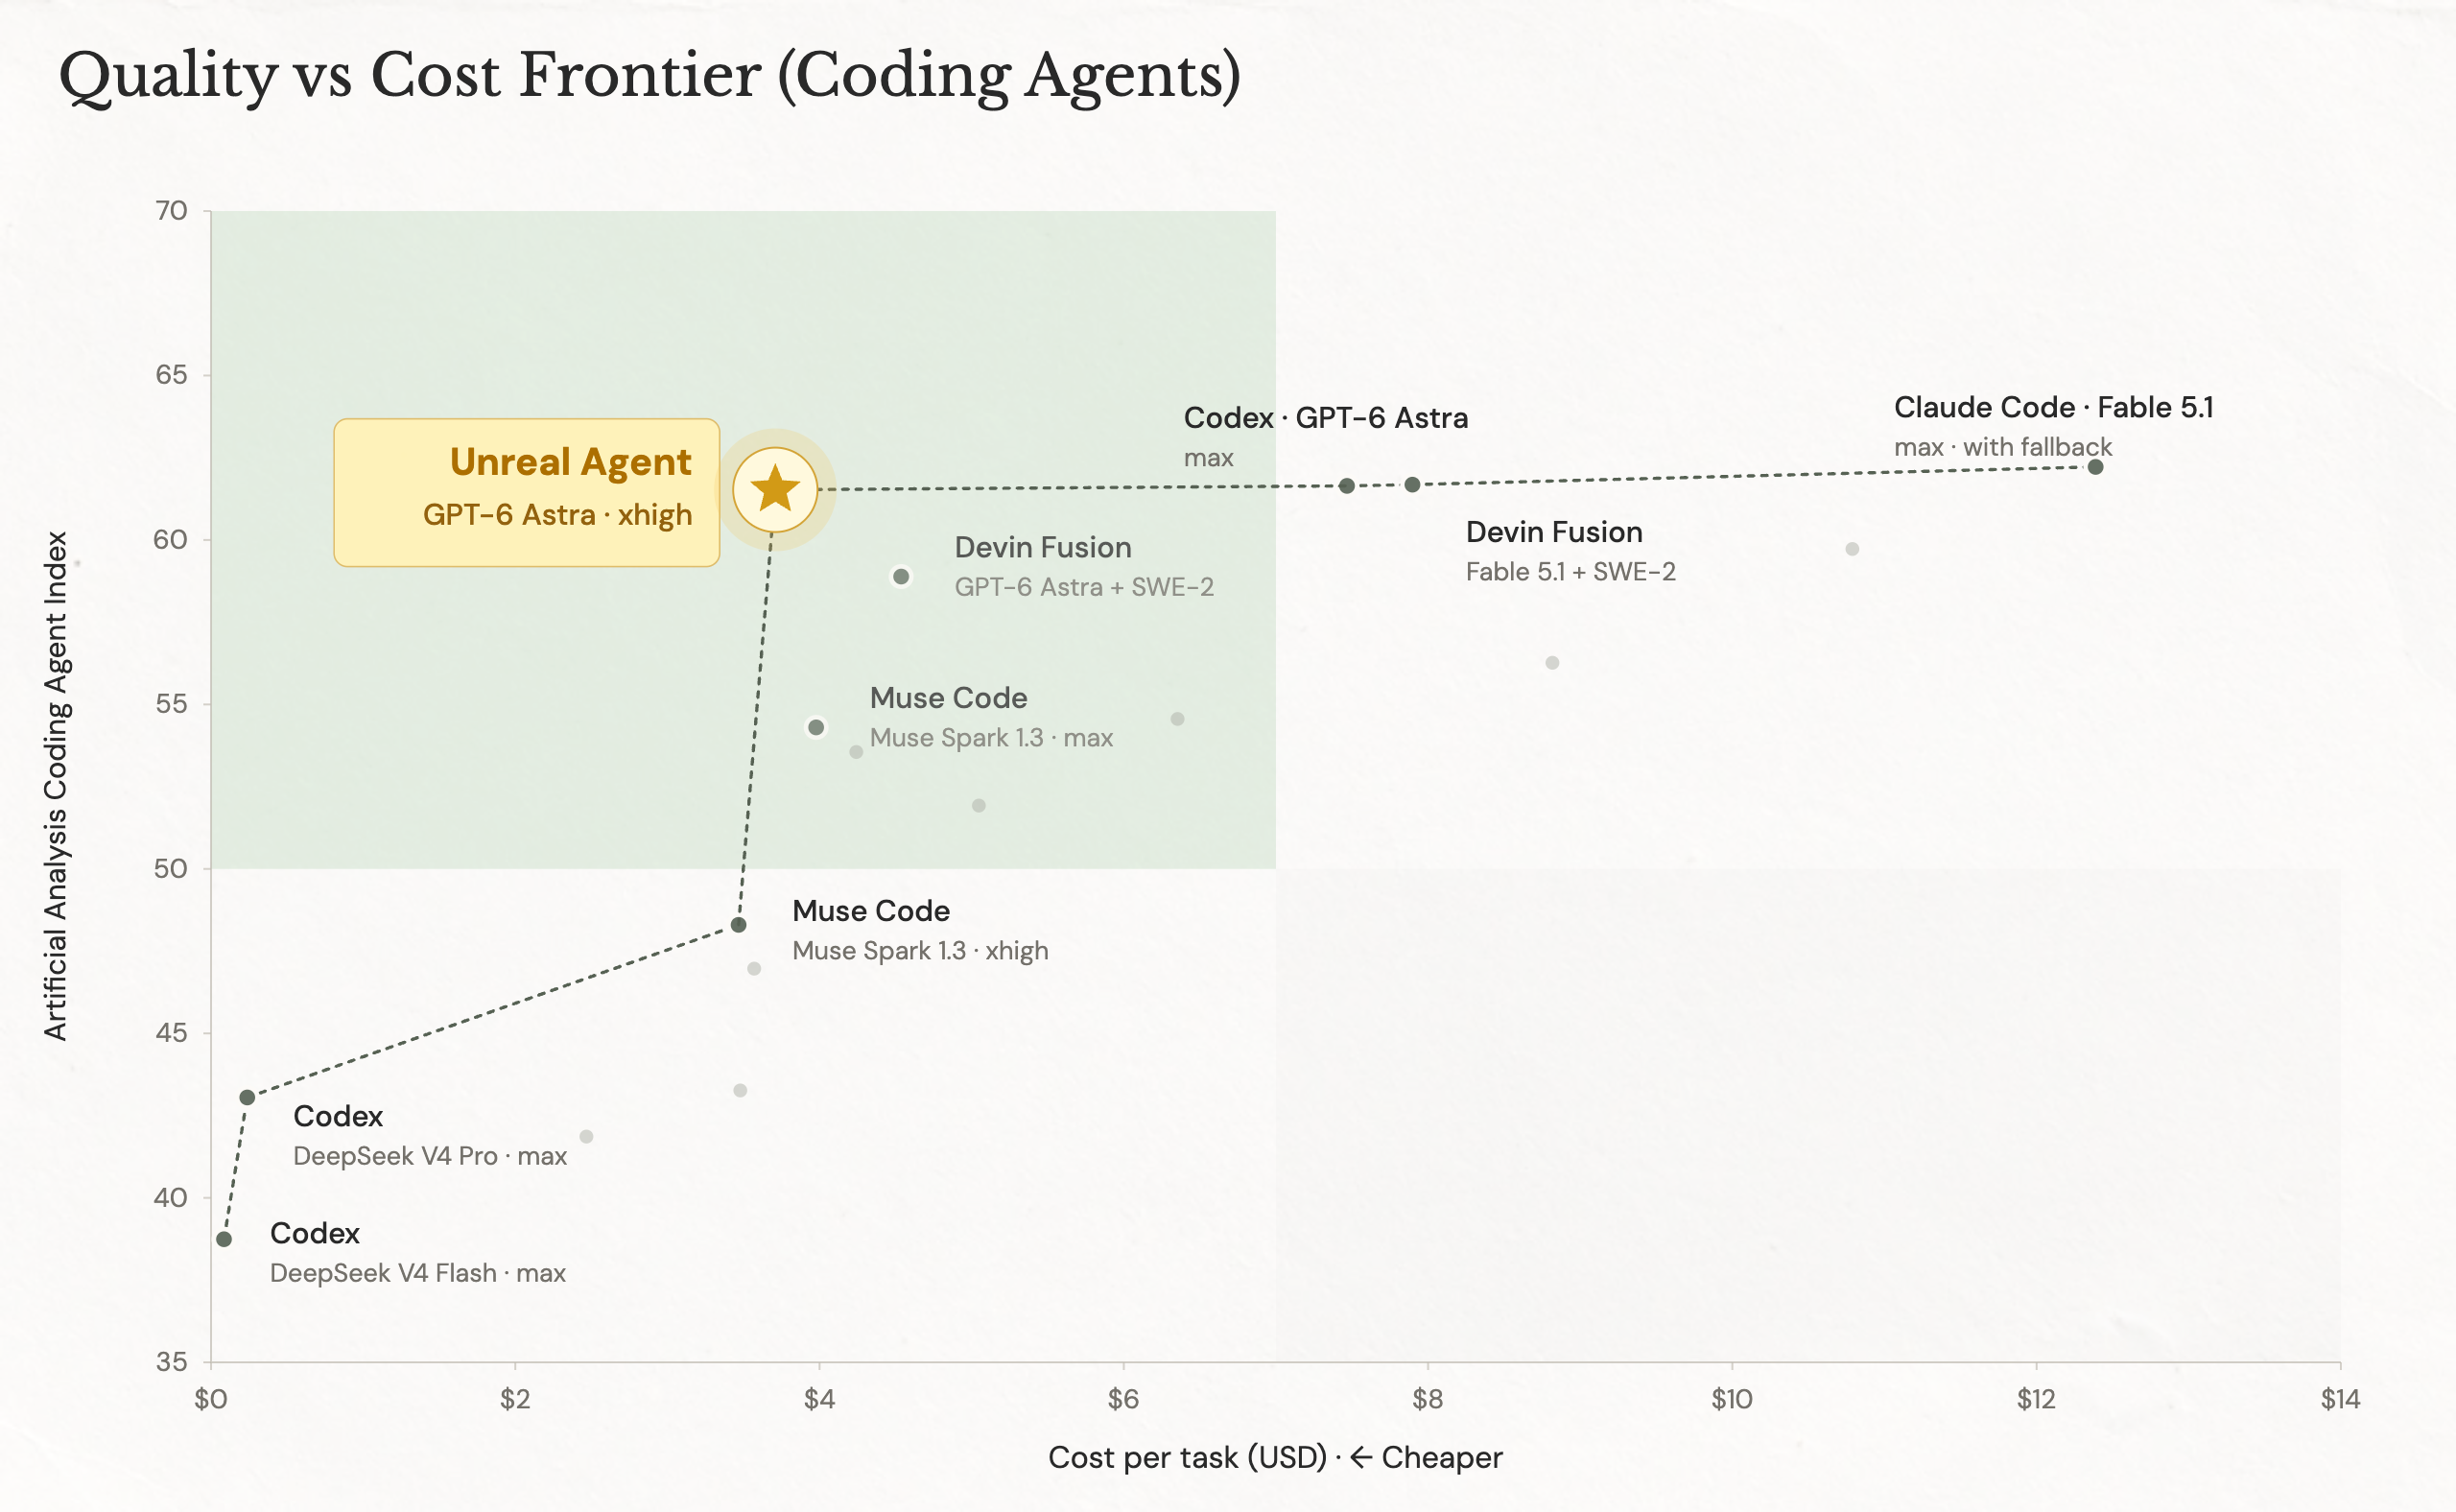
该图表呈现了文章的基准测试证据:Unreal Agent 的成本通常低于列出的 Codex 和 Pi 基线,同时取得了可比的实测通过率。
其他已报告的测试也呈现出类似趋势。在 DeepSWE 1.1 中,Unreal Agent 的通过率为 72.4%,成本为 1,367 美元;Codex 的通过率和成本分别为 69.0% 与 1,633 美元,Pi 则分别为 69.6% 与 1,584 美元。在 Agents’ Last Exam · ALE-CLI 中,其完全通过率为 30.0%,成本为 217 美元;相比之下,Codex 的完全通过率和成本分别为 29.0% 与 292 美元,Pi 则分别为 29.0% 与 262 美元。主页面指出,通过率上的小幅差异可能源于基准测试本身的波动,因此不应将这些结果解读为质量优势显著且始终一致的证明。
最重要的限制在于可比性。页面称,Unreal Agent 使用 GPT-6 Astra,并将推理投入设为 xhigh,同时把 Codex 标记为排行榜基线;但现有材料没有提供足够的配置细节,无法确定所有比较都使用了相同的底层模型、推理设置、工具集、上下文策略和执行预算。ALE-CLI 的运行也不在 Harbor 上进行,而其他已报告的基准测试则是在 Harbor 上运行的。因此,这些表格只能证明 Unreal Agent 在已测试配置下取得了有利结果,并不能将成本差异单独归因于异步执行。
因此,该公司关于相较 Codex “最多节省 40%”、相较 Pi “最多节省 20%”的标题式主张,最好被视为发布方报告的上限,而不是一般性的性能保证。它与表格中的若干数据相符,但这组材料并不能证明存在一项单一且受控的实验,让所有竞争工具框架都在完全相同的条件下重新运行。选择生产级智能体的读者仍需要针对相关代码仓库、工具、审批策略、延迟目标和故障模式自行测试。
仓库还说明了这一架构不会自动解决的问题。它将验证、取消、提供商错误、会话恢复、操作状态以及由宿主选择的工具列为彼此独立的责任。这种划分可能让系统更易于适配,但也意味着部署团队仍须负责沙箱边界、凭据、代理、工具注册表以及远程操作的行为。Unreal Labs 表示,依赖环境约束和细粒度访问控制,比仅依赖工具框架钩子更稳健;这是该公司的工程立场,而不是针对所有安全模型的独立证据。
对于考虑自行定制实现的团队,还存在一个额外的互操作性注意事项。Unreal Labs 报告称,Responses API 文档没有充分说明应如何将运行中的结果与最终结果表示为两个工具调用输出项。在使用 OpenAI 以外的某些模型和推理提供商时,该设计遭遇了拒绝请求;公司还表示,在这些情况下,`function_call_output` 的状态字段似乎没有发挥作用。因此,现有证据支持其测试中确实存在兼容性问题,但不能据此声称所有提供商的表现都相同。
对从业者而言,实际问题并不是异步工具听起来是否优雅,而是相互独立的操作能否安全重叠执行,长时间运行的设置任务能否被取消或恢复,以及模型能否获得足够的结构化状态来作出下一步决策。Unreal Agent 已发布的架构设计在组件层面直接回应了这些运维问题,而基准测试表则提供了初步的成本与质量信号。它们并不能证明该智能体在已报告的编程测试之外,具备生产级可靠性、安全性或成本节省。