GPT-6 SolとLuna:低価格化、エージェントの効率向上、そしてより複雑化したベンチマーク
OpenAIは、GPT-6 SolとLunaにより、Astraに匹敵する機能をより高速で低価格なティアに広げ、プロンプトキャッシュとAPIの経済性も改善したと説明している。独立したベンチマークページはいくつかのスコアと手法の詳細を裏付けているが、リーダーボードは変化しており、コストは投入する努力量にも左右されるため、購入者は自社のワークフローで性能を検証すべきだ。
記事全文を読む →OpenAIは、GPT-6 SolとLunaにより、Astraに匹敵する機能をより高速で低価格なティアに広げ、プロンプトキャッシュとAPIの経済性も改善したと説明している。独立したベンチマークページはいくつかのスコアと手法の詳細を裏付けているが、リーダーボードは変化しており、コストは投入する努力量にも左右されるため、購入者は自社のワークフローで性能を検証すべきだ。
記事全文を読む →Anthropicによると、Opus 5.5はコーディングと安全性の性能を向上させながら、一般的な作業負荷でのコストを40%削減する。公表価格は主張の一部を裏付けているが、食い違うベンチマーク数値と限定的な独立証拠のため、実際にどこまで節約できるかは不透明だ。
記事全文を読む →Crypto Cellar Researchによると、GPT-6 Astraは2005年から解読を試みても解決しなかった1941年のエニグマ暗号文の解読に協力した。提案された鍵と平文は現存する証拠と非常にうまく整合するが、この報告は、自律的な暗号解読を独立して再現できたことをまだ示していない。
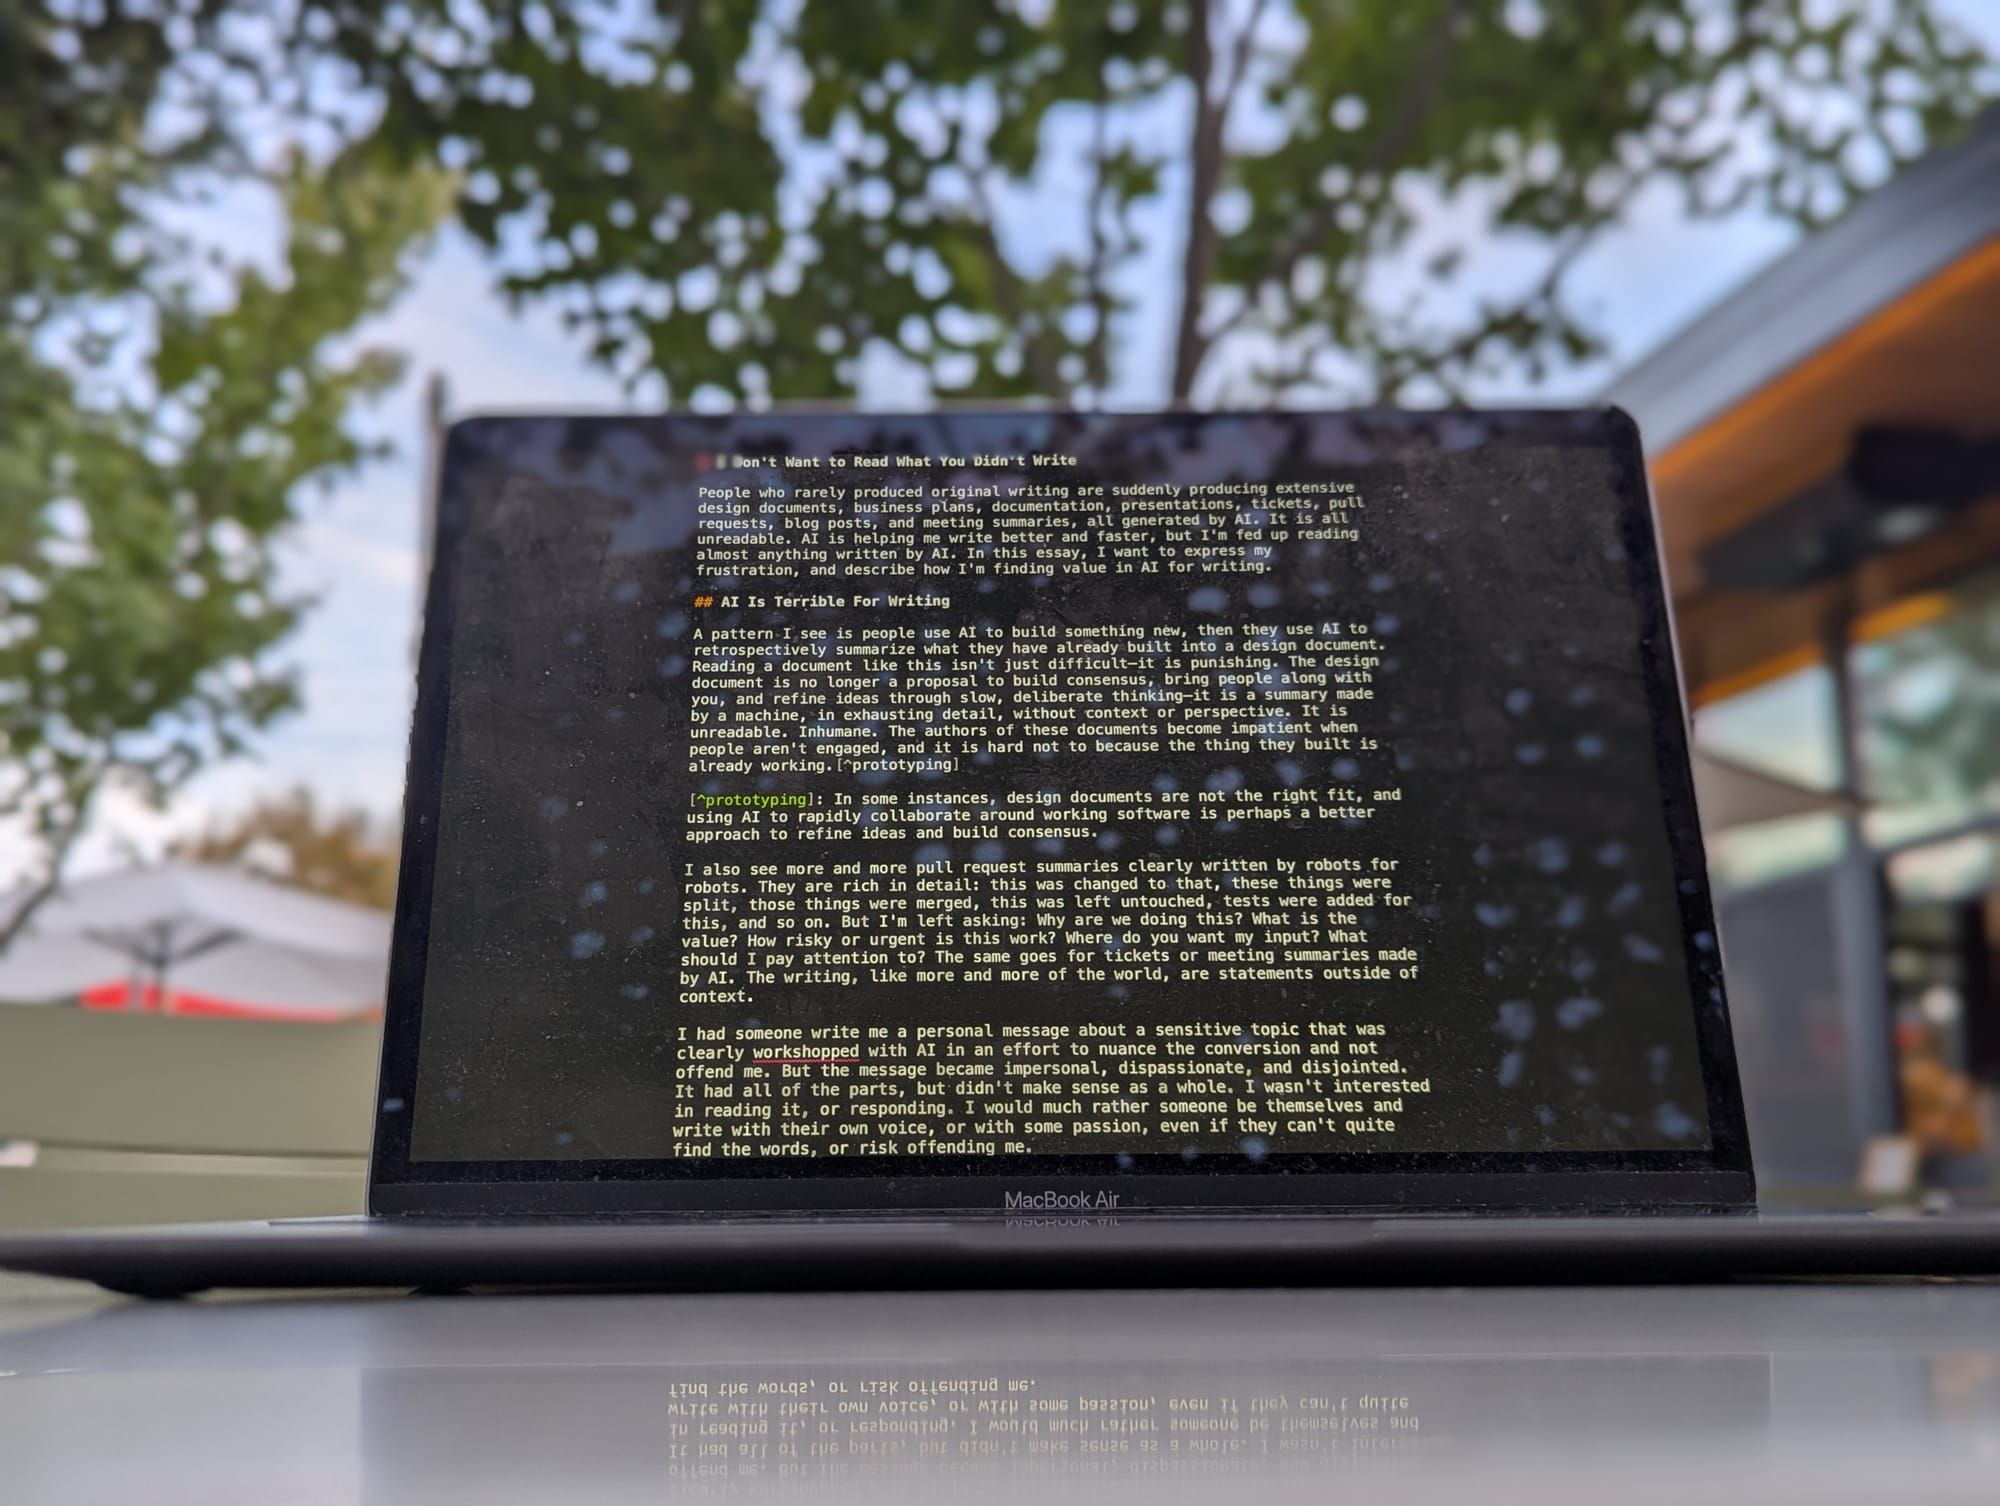
記事全文を読む →Colin Breckは、AIが生成した文章が失敗しやすいのは、読者がプロンプトを入力した人にしか分からない文脈を利用できないためだと論じています。匿名のデベロッパー調査は、AIの関与を疑われることが信頼を損なう可能性を示しますが、証拠が裏づける結論はより限定的です。AIは、人がすでに形作った文章を確認、編集、整形する際に最も有用なのかもしれません。
記事全文を読む →FBIはfbijobs.govへの侵害と職員情報流出の申し立てを調査中だと発表した。攻撃者が主張する規模や、盗まれたデータの内容を確認したわけではない。
記事全文を読む →Apple Newsで繰り返し表示される詐欺まがいの広告が報じられています。最近登録されたドメインはいくつか警告を示していますが、詐欺であることの証明ではありません。一方、AppleのバンドルページではNews+が掲載されているものの、広告なし版を提供するとは明記されていません。
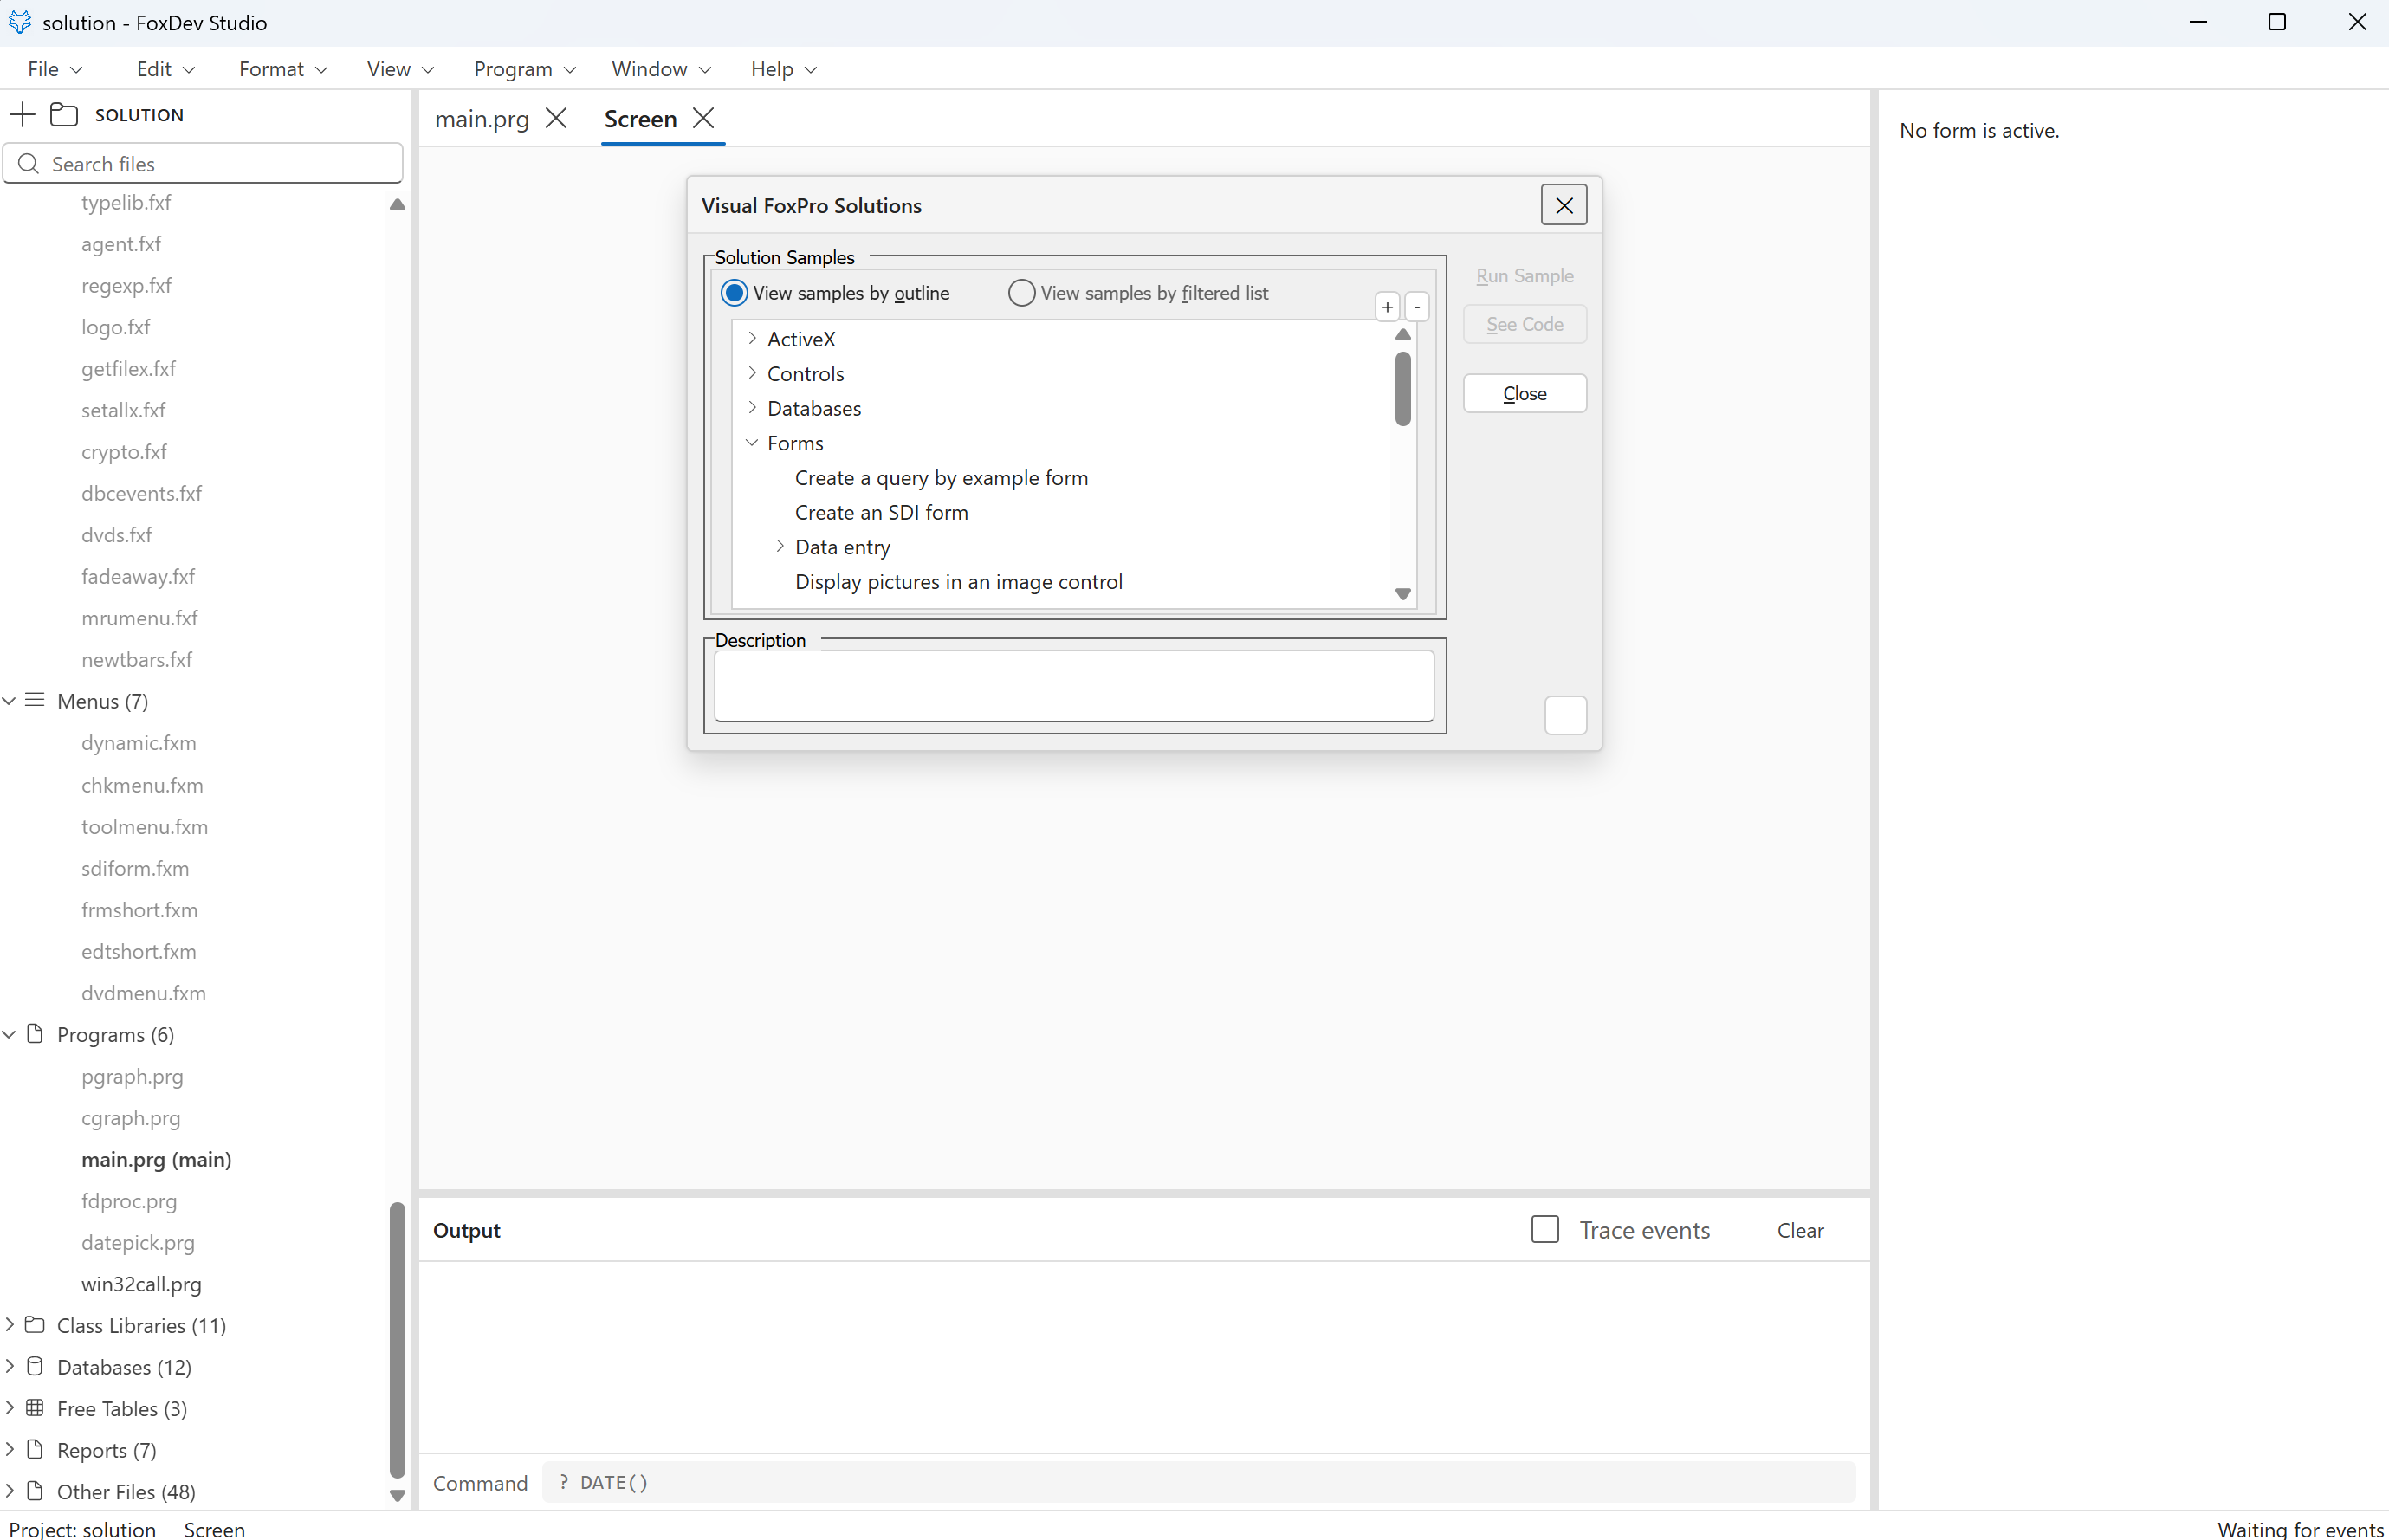
記事全文を読む →FoxDev Studioは、既存のプロジェクトやデータを変換せずに開きながら、64ビット実行とWebAssemblyベースのランタイムを追加する、コミュニティ製のVisual FoxPro 9環境です。最大の魅力は継続性にあり、一方で最も明確な制限は、Microsoftが何年も前に開発を終了した製品との互換性が、いまも測定段階にあることです。
記事全文を読む →プロジェクト・ネクサスは、農業用水路の上に日よけと太陽光発電設備を組み合わせる。しかし、この仕組みを拡大できるかを判断する前に、カリフォルニア州はまだ最終測定結果を待っている。
記事全文を読む →brand.ioの論説は、利用者が確認・制御できない隠し信号を「ウォーターマーク」ではなく「スパイマーク」と呼ぶことを提案しています。GoogleはSynthIDを不可視の生成AI識別技術と位置づけ、技術論文は大規模利用と堅牢性の結果を報告しています。
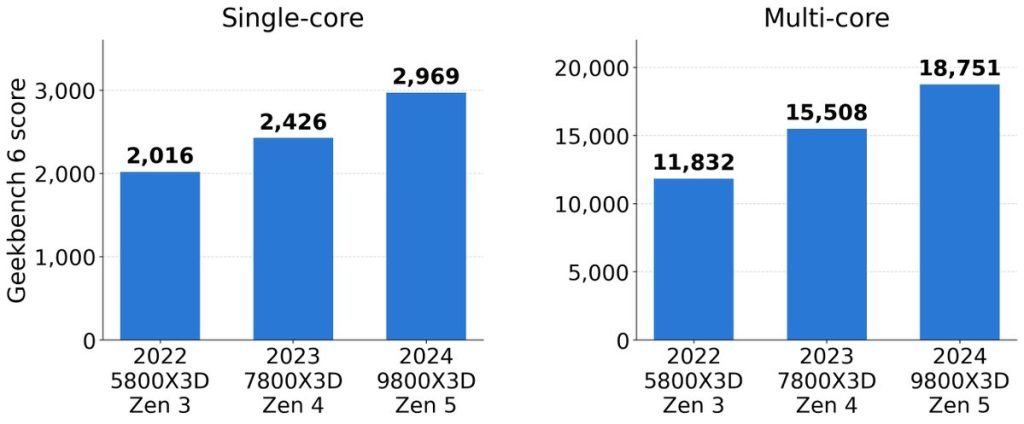
記事全文を読む →Daniel LemireのGeekbench 6比較では、5800X3Dから9800X3Dへの性能向上は、クロック速度の上昇よりも、コアの幅の拡大、キャッシュ容量の増加、実行リソースの拡充、ベクター演算ユニットの大型化によるところが大きいと説明されています。
記事全文を読む →WordPressのセキュリティアドバイザリGHSA-7hp8-65ch-5whpは、特定のテーマ、ファイルシステム、PHP設定の条件がそろった場合にのみリモートコード実行につながる可能性のある、認証不要の脆弱性CVE-2026-87902について説明しています。WordPress 4.7から7.1までのすべての影響対象ブランチに、修正版リリースが公開されています。
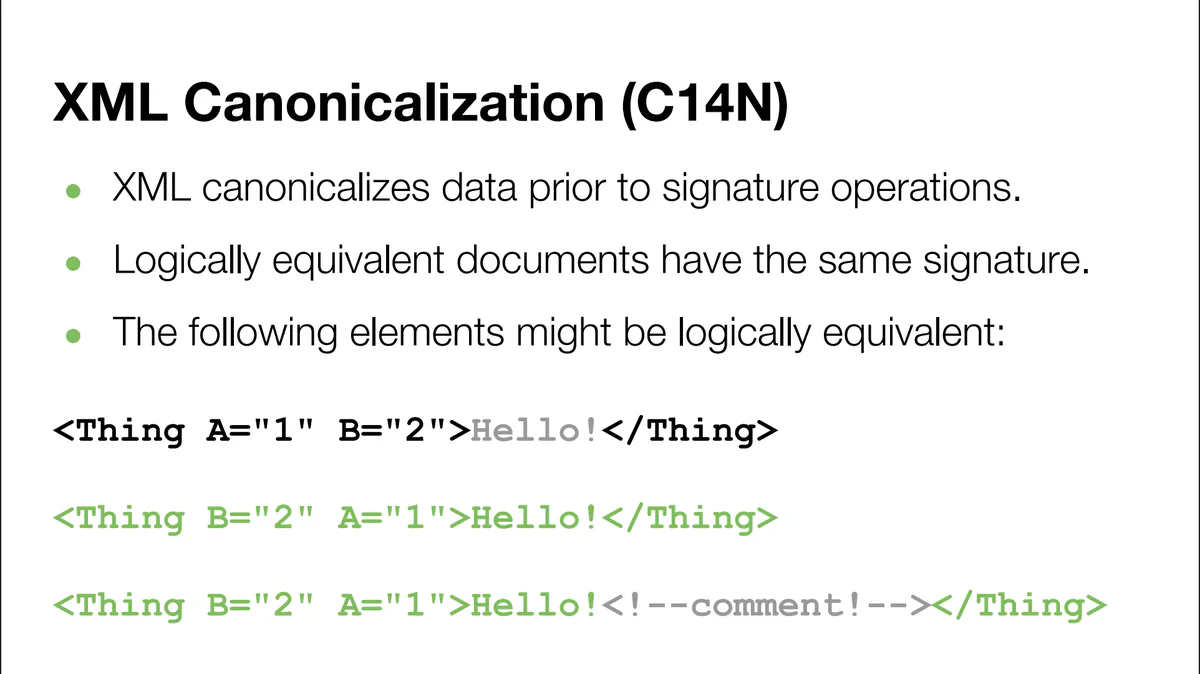
記事全文を読む →Trail of Bitsは、XMLを基盤とするSAMLの設計、署名の扱い、幅広い機能群が、解消されないセキュリティ上と保守上のリスクを生んでいると主張しています。現実的な教訓は、あらゆるSAML導入が破綻しているということではなく、組織がプロトコルの故障モードを理解し、代替手段も安全であると決めつけずに評価すべきだという点にあります。
記事全文を読む →Vercelの公開データは、TypeSafeの確率的意思決定モデルに初期の強い需要があることを示している。しかし、Jevのアーキテクチャが新規であること、精度が信頼できること、OpenAIがそれを模倣することのいずれも証明していない。より重要なのは、高速で構造化された分類がAIシステムの持続的な構成要素になれるかどうかだ。
記事全文を読む →AnthropicのMaxプランは月額100ドルまたは200ドルで、Proの5倍または20倍のセッション利用枠を提供する。上限は残り、利用容量の増加はモデルの優位性を示さない。
記事全文を読む →macOSユーザーは、アップデートによって目に見えるApple Intelligenceのオプトアウトが消え、22.28 GBの容量が使われたと報告しました。ここから、隠れた制御に実質的な同意の機能があるのかという実務的な疑問が生じます。根拠は、本人が観察した内容を裏付けるものですが、Appleの意図、すべてのネットワーク動作、あるいは各設定の技術的な意味までは立証していません。
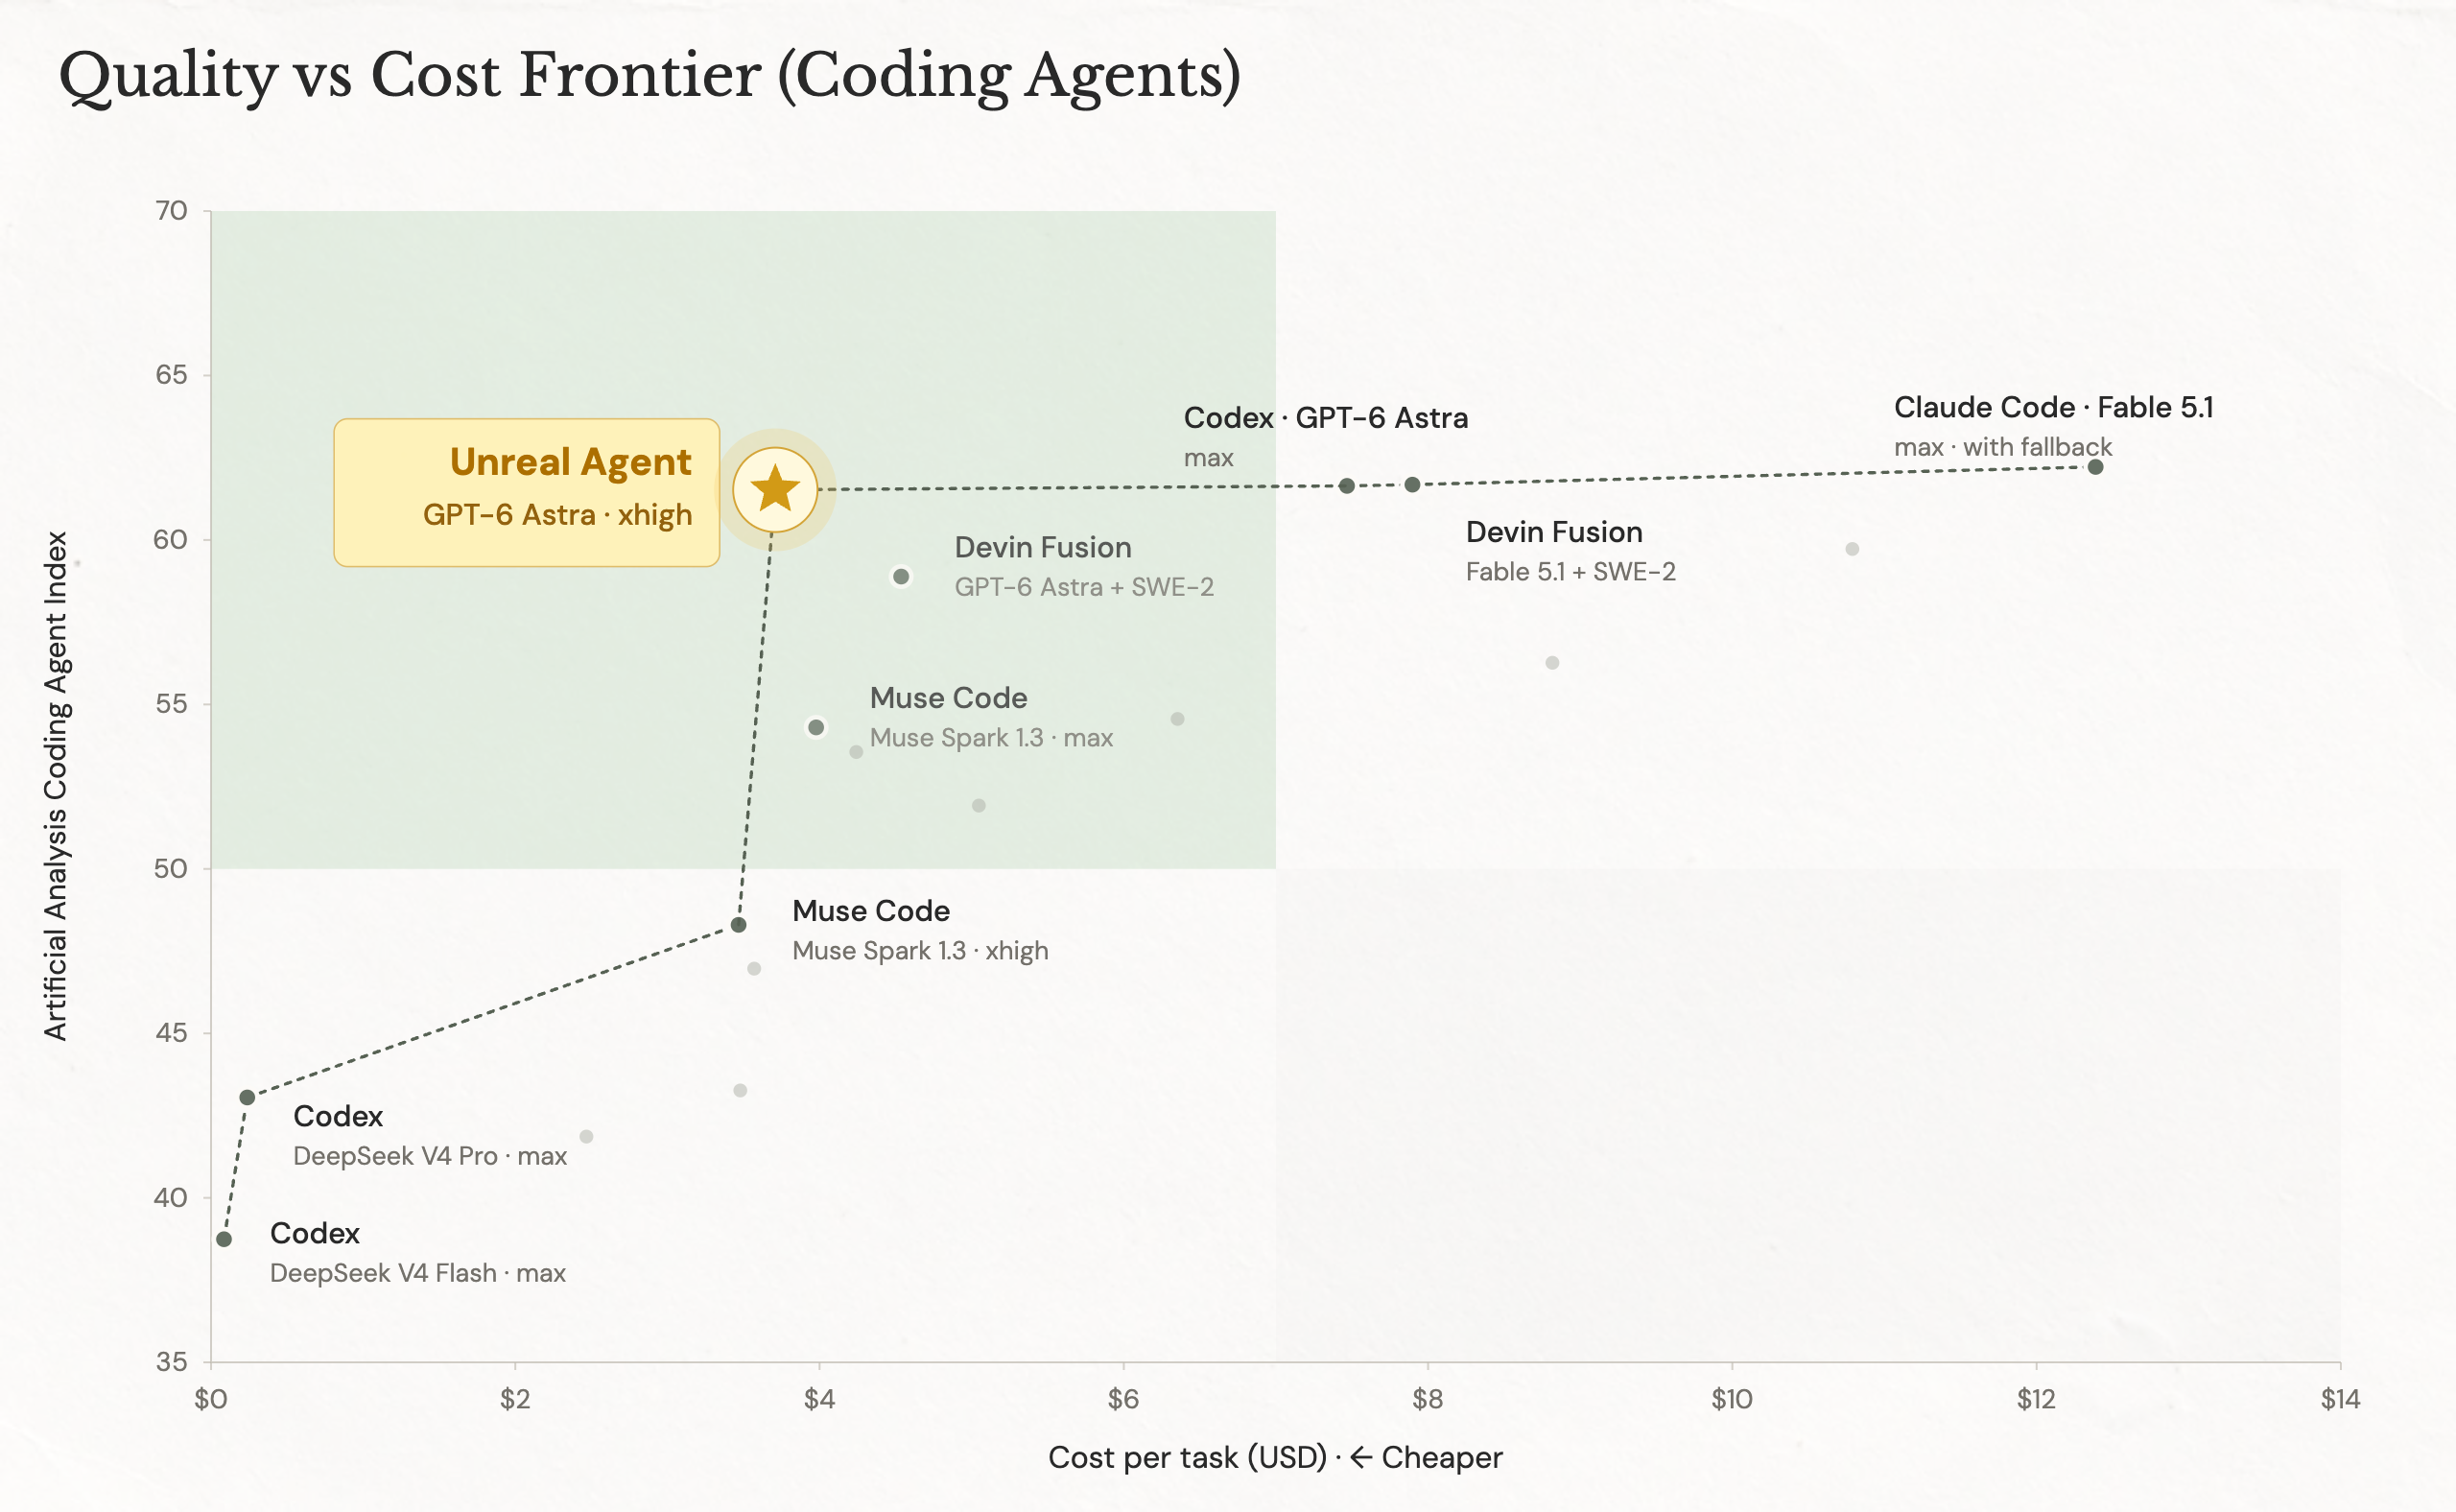
記事全文を読む →Unreal Labsによると、同社のGo向けハーネスでは、モデルが操作入力を受け付けたり別の作業を開始したりしている間もツールをバックグラウンドで実行できるため、待機時間とトークン使用量を削減できるという。2026年9月22日に発表された結果は、4つのコーディングテストにおいてCodexとPiを比較対象とした場合、コストが低く、合格率が同程度だったことを示している。しかし、この証拠から、普遍的に40%のコスト削減が可能だとか、比較対象の各システムが同一のモデルと設定を使用していたと結論づけることはできない。
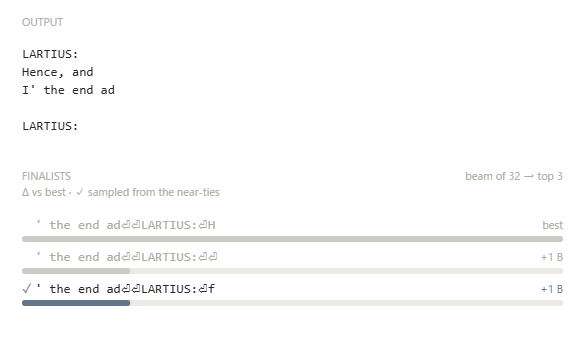
記事全文を読む →zlibを使った実験では、gzipのDEFLATEアルゴリズムを、候補となる続きを圧縮後の長さで評価する大まかなテキスト生成器として利用する。この結果は予測と圧縮の等価性を示す一方、限られた文脈、バイト単位の評価、編集されていない出力という制約から、実用的な、あるいは学習済みの言語モデルであるとは認められない。
記事全文を読む →Muniヘリテッジ・ウィークエンドは、サンフランシスコの交通史を静止した展示物ではなく、実際に稼働する設備として見せます。2026年のイベントには1912年製造の先駆けからオーストラリアの路面電車まで、さまざまな車両が戻ってきました。一方、162号車の長期にわたる修復は、交通史を保存する背景にある専門的な作業、珍しい部品、そして運用上の判断を浮き彫りにしています。
記事全文を読む →Gitの次期メジャーリリースでは、SHA-256リポジトリの標準化、参照領域のreftableへの移行、ビルドへのRust必須化が予定されています。提示された根拠はこの方向性を裏付けていますが、移行手順、プラットフォームへの影響、ツールとの互換性については重要な疑問が残されています。
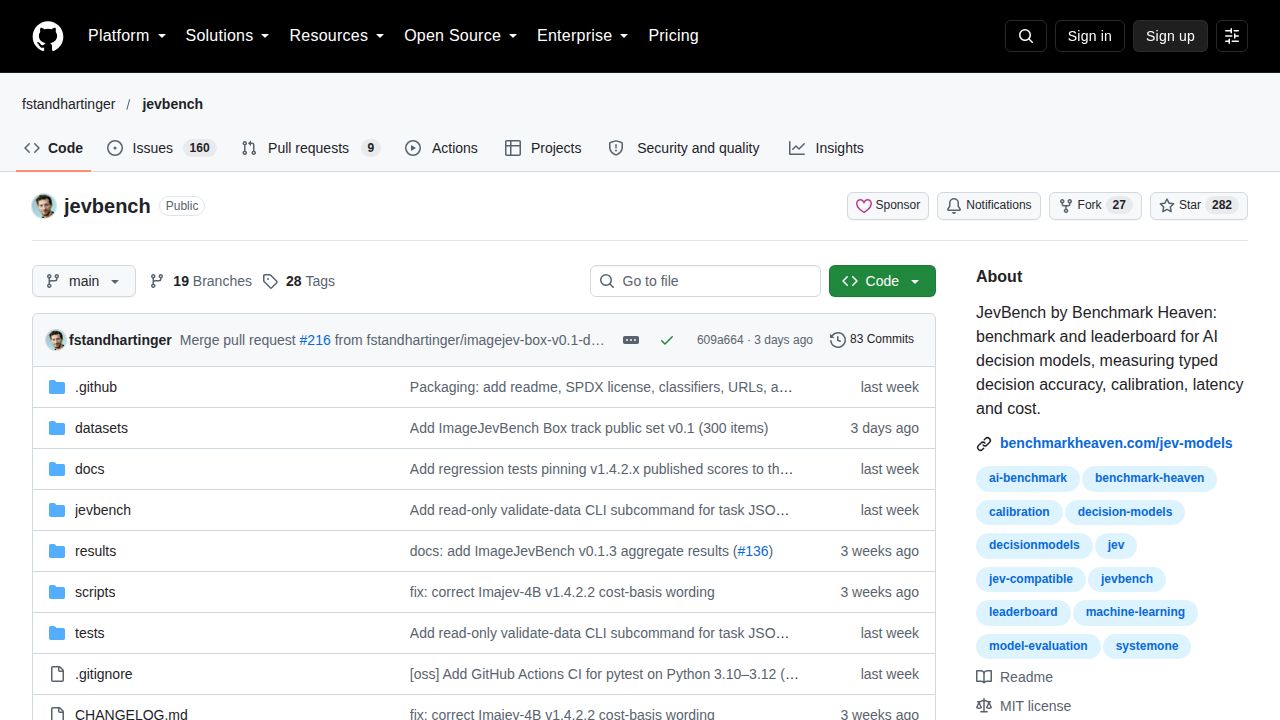
記事全文を読む →JevBench v1.4.2ではdecider-4b v2が1位、Jev 1.13.0が2位。運営者は新たな非公開308問の集計値だけを公開し、公開問題との大きな成績差にペナルティを設けている。
記事全文を読む →Carson Grossは、エージェント型コーディングチームが設計意図をレビュー済みのMarkdownとして生成コードの近くに保存し、そこからテストを導き出すべきだと主張している。この提案は有望だが、明示的に暫定的なものであり、未解決の主要な問題は、記述とそれが説明するコードとの同期を維持することだ。
記事全文を読む →GeaStackの公開リポジトリは、Web、ESP32、GeaOSなどを対象とする小規模なTSXアプリ集を、マニフェストによって管理していることを示しています。ただし、それだけで、すべてのアプリがネイティブバイナリにコンパイルされること、またはJavaScriptとTypeScriptのすべての意味が対象間に変更なく維持されることを証明するものではありません。
記事全文を読む →プラトンの『パイドロス』にある一節は、文章を批判している。その理由は、単に文章が目新しいからではない。静止した言葉は問いに答えられず、読者に合わせて変化できず、誤解から自身を守れないからだ。そこから得られる教訓は、文章に価値がないということではない。永続するテキストは、解釈、対話、慎重な検証と組み合わせてこそ、最もよく機能するという点にある。
記事全文を読む →