Unreal Labsが提起しているのは、コーディングエージェントを評価する際には見過ごされやすい疑問だ。請求額のうち、どの程度がモデル自体に由来し、どの程度が、モデルに考えるタイミング、待機するタイミング、ツール呼び出しのタイミングを決めさせるソフトウェアに由来するのか。同社が2026年9月22日に公開したUnreal Agentの紹介記事では、従来のエージェントループでは、基礎となる作業そのものよりも、ツール呼び出しの管理にかなりの時間とトークンを費やしていると主張されている。
同社が提案する答えは、非同期ハーネスである。Unreal Labsによると、すべてのツール呼び出しは即座に「進行中」として記録され、その実行はバックグラウンドで続けられる。モデルは、完了を何度もポーリングして待つ代わりに、別の操作入力を受け付けたり、追加のツール呼び出しを発行したり、ほかの作業を進めたりできる。処理が完了すると、その結果がセッションログに追加され、モデルが再度呼び出される。同社によれば、この仕組みによって、待機時間とタスク完了に必要なモデルのターン数の両方が削減されるという。
これはハーネスに関する主張であり、それを使用するすべてのエージェントが安価になると証明するものではない。Unreal Labsは、コスト削減の要因を2つの設計上の選択に求めている。1つ目は、ツールとプロンプトの範囲を比較的狭く抑えること、2つ目は、モデル呼び出しの間により有用なツール処理を行わせることだ。公開されているGitHubリポジトリには、このアーキテクチャの説明を具体的に裏づける資料が掲載されている。そこでは、追記専用のセッションストア、コーディネーター、イベントループをブロックしてはならないツール翻訳機能、そして非同期実行を担当するオペレーションマネージャーが示されている。また、永続的で直列化可能な操作とセッション回復についても説明されており、この設計が単なるインメモリのデモを超えて拡張されることを意図していることがうかがえる。
ベンチマーク結果は、この考え方がなぜ注目を集めたのかを示しているが、慎重に読む必要がある。Terminal-Bench 4.0では、Unreal AgentとCodexはいずれも合格率57.9%を記録した一方、報告されたテスト全体のコストは、Unreal Agentが1,428米ドル、Codexが2,350米ドルだった。Piは合格率55.0%、コスト1,827米ドルだった。SWE-Atlas Codebase QnAでは、Unreal Agentが936米ドルで合格率65.8%に達したのに対し、Codexは63.3%で1,303米ドル、Piは64.0%で1,033米ドルだった。これらの数値が裏づけるのは、より限定された結論、すなわち、この実装は報告された各テストにおいて、掲載済みの比較対象より低コストで、同等またはやや高い測定合格率を達成した、という点までである。
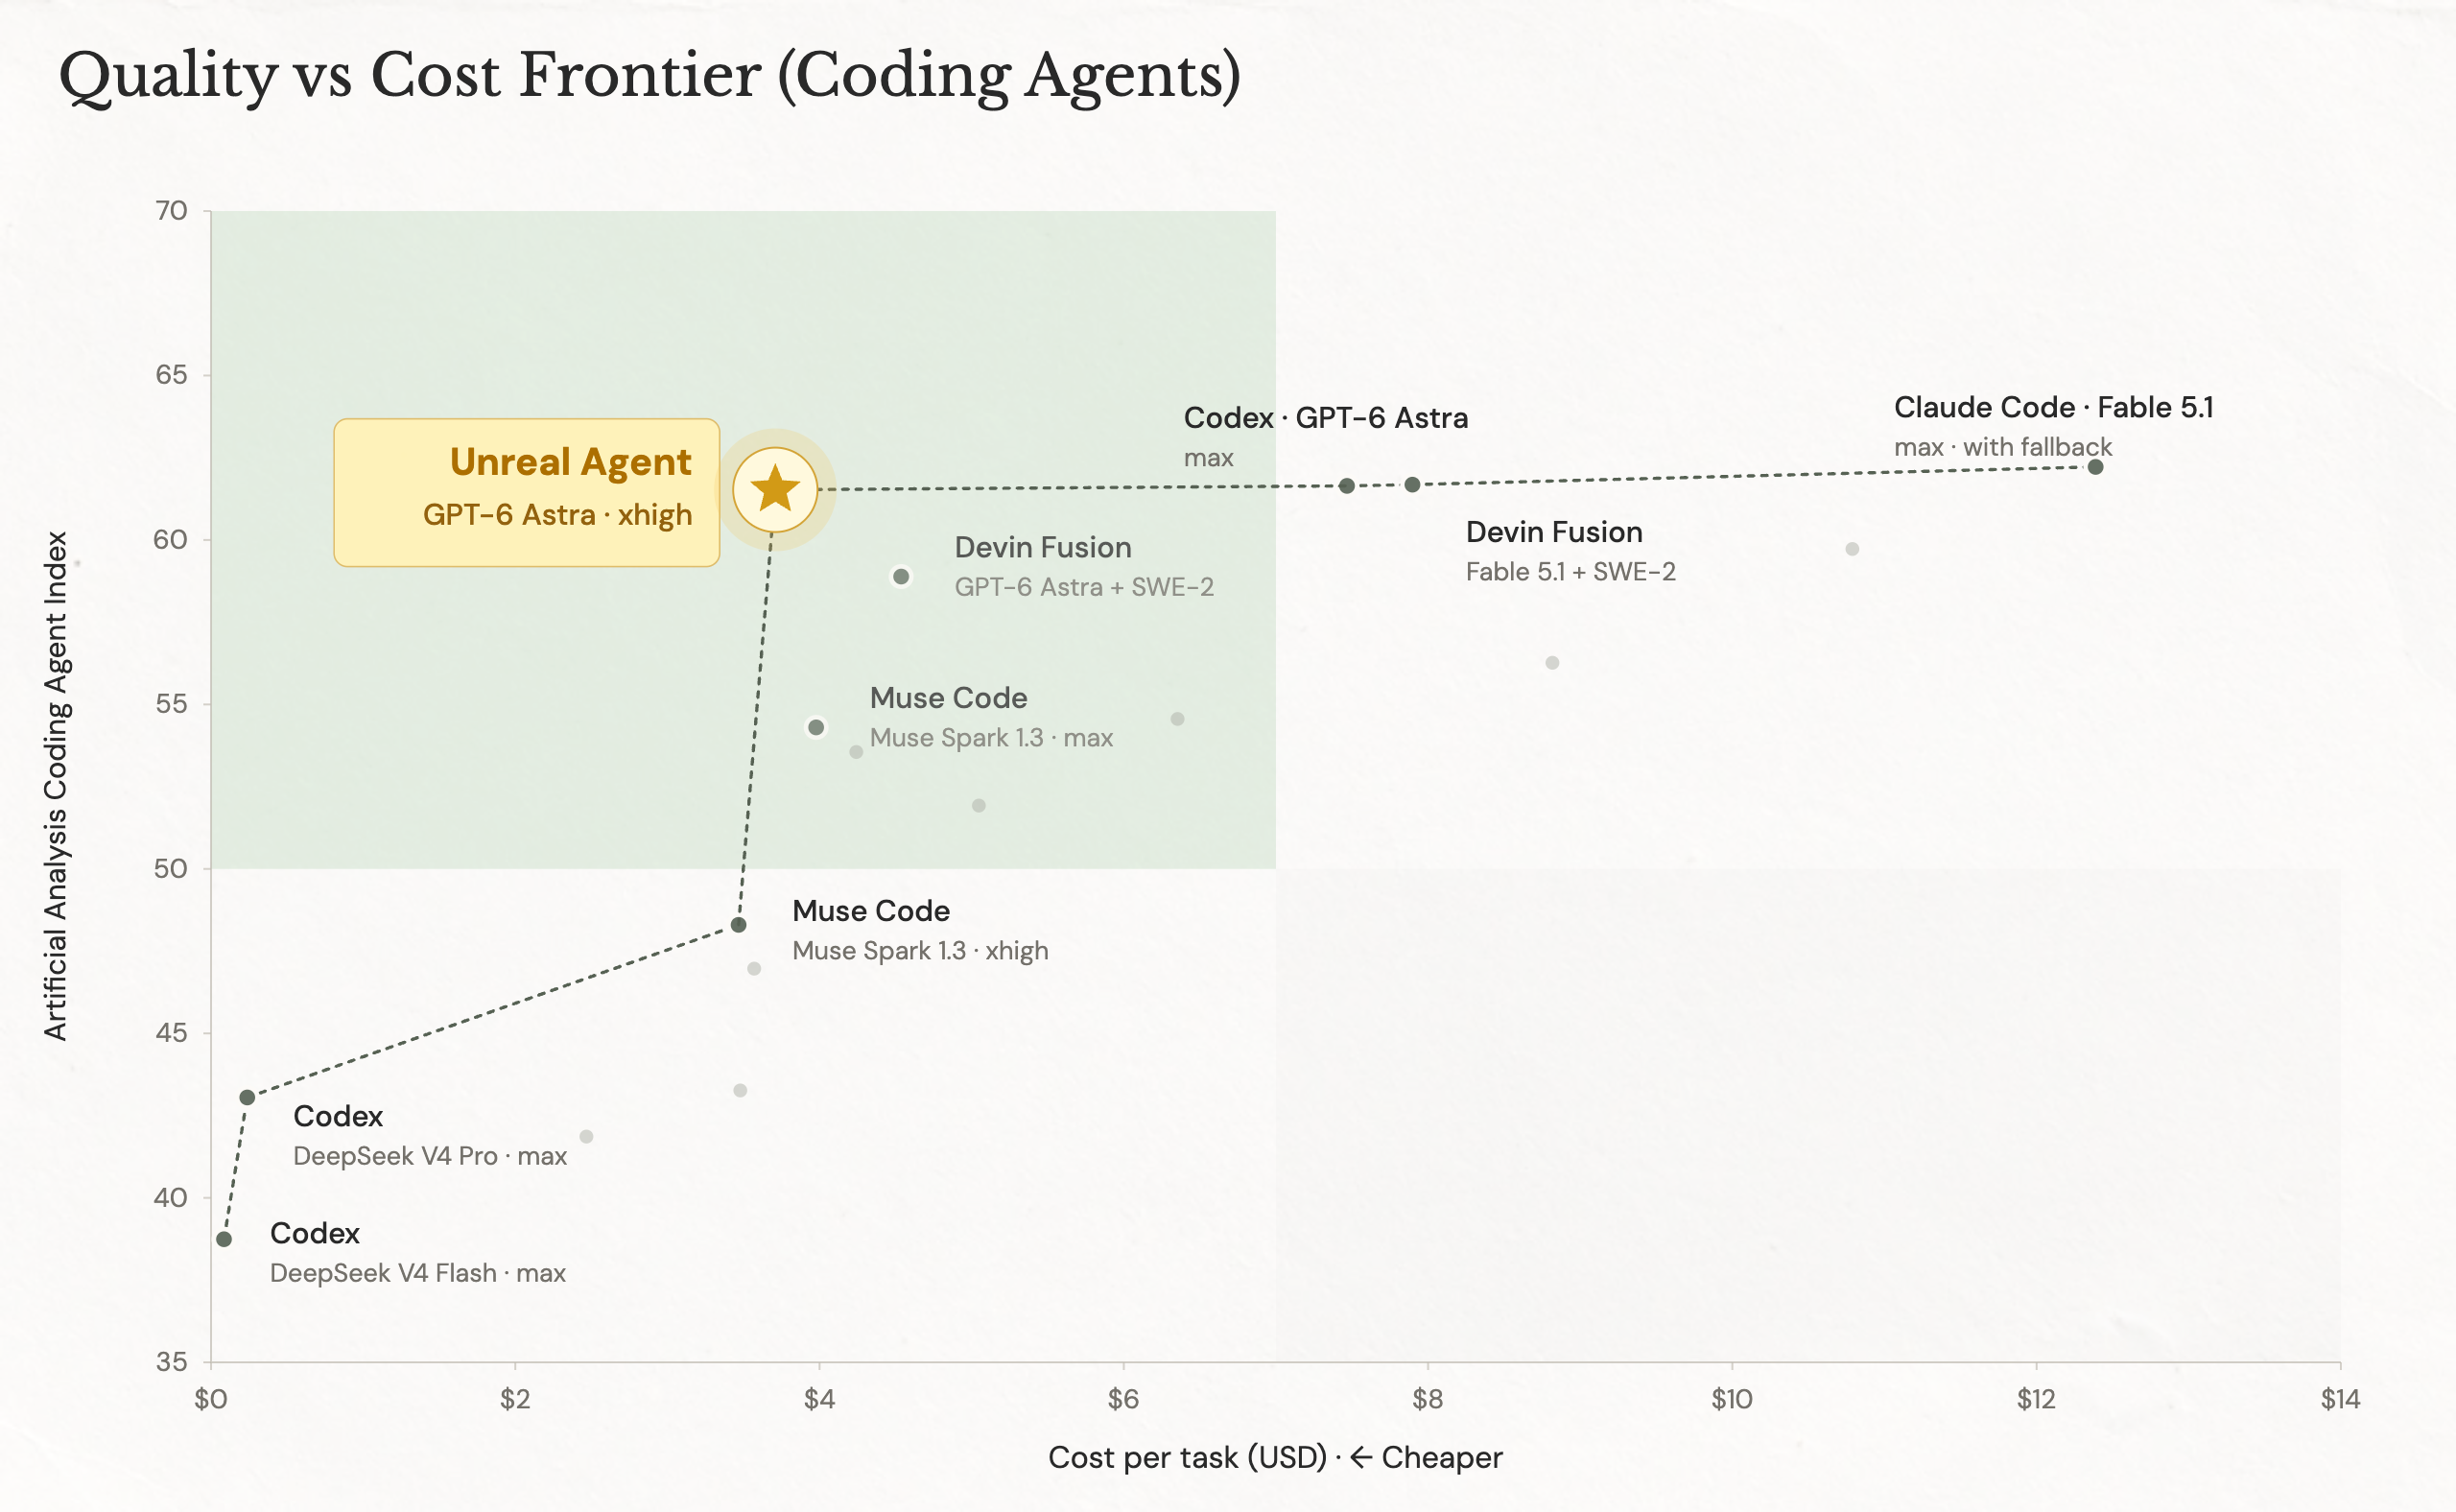
この図は記事内のベンチマーク証拠を示しており、Unreal Agentは一般的に、掲載済みのCodexとPiのベースラインより低コストでありながら、同等の測定合格率を達成している。
同じ傾向は、ほかの報告済みテストでも続いた。DeepSWE 1.1では、Unreal Agentが1,367米ドルで合格率72.4%を記録したのに対し、Codexは69.0%で1,633米ドル、Piは69.6%で1,584米ドルだった。Agents’ Last Exam · ALE-CLIでは、完全合格率が30.0%、コストが217米ドルで、Codexは29.0%で292米ドル、Piは29.0%で262米ドルだった。主要ページでは、合格率の小幅な差はベンチマークのばらつきを反映している可能性があると説明されており、この結果を大規模かつ一貫した品質上の優位性を証明するものとして読むべきではない。
最も重要な限界は、比較可能性である。このページでは、Unreal AgentがGPT-6 Astraを推論努力レベルxhighで実行していると説明され、Codexはリーダーボード上のベースラインとして記載されている。しかし、提供された資料には、すべての比較で基礎となる同一のモデル、推論設定、ツールセット、コンテキストポリシー、実行予算が使用されたことを確認できるほど十分な設定情報が含まれていない。さらに、ALE-CLIの実行は、ほかの報告済みベンチマーク実行と異なり、Harbor上では行われていない。したがって、この表が示すのは、Unreal Agentのテスト済み構成における有利な結果であって、非同期実行がコスト差の唯一の原因であると切り分けて証明するものではない。
したがって、Codex比で「最大40%」、Pi比で「最大20%」の削減を実現するという同社の見出しの主張は、一般的な性能保証ではなく、公開者が示した上限値として扱うのが最も適切である。この主張は表中の複数の数値とは整合するが、提示された資料は、すべての競合ハーネスを同一条件で再実行した単一の管理された実験を立証するものではない。本番環境向けエージェントを選ぶ読者は、依然として、対象となるリポジトリ、ツール、承認ポリシー、レイテンシー目標、障害モードを自分でテストする必要がある。
リポジトリはまた、このアーキテクチャが自動的に解決しない事項も明らかにしている。検証、キャンセル、プロバイダーエラー、セッション回復、操作の状態、ホストが選択するツールは、それぞれ別の責務として説明されている。この分担によってシステムは適応しやすくなる可能性がある一方、デプロイを担当するチームは、サンドボックスの境界、認証情報、プロキシー、ツールレジストリ、リモート操作の動作に責任を負うことになる。Unreal Labsは、環境上の制約と細かいアクセス制御は、ハーネスのフックだけに依存するよりも堅牢だと述べている。これは同社の技術的な見解であり、あらゆるセキュリティモデルについての実証済み証拠ではない。
独自実装の検討を進めるチームには、相互運用性に関する追加の注意点もある。Unreal Labsによると、実行中の結果と最終結果を2つのツール呼び出し出力項目として表す仕様は、Responses APIのドキュメントでは十分に定義されていなかった。OpenAI以外の一部のモデルや推論プロバイダーでは拒否が発生し、同社によると、そうしたケースでは`function_call_output`のstatusフィールドが機能していないように見えたという。したがって、提供された証拠は、同社のテストにおいて実際の互換性の懸念が存在することを裏づけるものの、すべてのプロバイダーが同じように動作すると主張するものではない。
実務者にとって実用的な疑問は、非同期ツールが概念的に優美に聞こえるかどうかではない。独立した操作を安全に重複実行できるか、長時間実行されるセットアップ作業をキャンセルまたは回復できるか、そしてモデルが次の判断を下すのに十分な構造化された状態を受け取れるかである。Unreal Agentの公開設計は、これらの運用上の問題にコンポーネントレベルで直接対応している一方、ベンチマーク表はコストと品質に関する初期の手がかりを提供するにすぎない。報告されたコーディングテストの範囲を超えたワークロードにおいて、本番環境での信頼性、セキュリティ、コスト削減を実現すると証明するものではない。