gzipは通常の意味で文章を生成できない。Nathan Barry氏がnathan.rsで公開した小規模な実験は、標準的な圧縮アルゴリズムであっても、与えられたコーパスに似た文章を選ぶことには使えると示している。この区別は重要だ。このプロジェクトはgzipに、学習済み重み、ニューラルネットワーク、現代の言語モデルに結び付けられる幅広い汎化能力を与えるものではない。予測と可逆圧縮の等価性を明らかにし、その等価性に基づいて条件付き生成器を組み立てているのだ。
GziPTと名付けられたこの実験では、別のgzipプロセスを起動せず、Pythonのzlibを使う。Barry氏によると、両者はDEFLATEに依存している。DEFLATEは直近32 KiBの範囲内で繰り返されるバイト列を探し、生のバイト列を出力するよりも安くなる場合には、その一致を後方参照として表す。したがって、圧縮器がすでに見ている素材を反復する、あるいは強く反映する続きは、短い符号化を得られる可能性がある。その圧縮後の長さが得点になる。符号化されたファイルが小さくなる候補ほど、現在の文脈から予測しやすいとみなされる。
この評価規則は、情報理論における標準的な関係に基づく。モデルが記号に確率pを割り当てる場合、最適な符号はそれにおよそ−log₂(p)ビットを使う。起こりやすい記号ほど必要なビット数が少なく、驚くべき記号ほど多くなる。2023年9月19日に初めて投稿され、2024年3月18日に改訂されたarXiv論文「Language Modeling Is Compression」は、予測モデルと可逆圧縮器が相互に変換可能だと説明している。その概要はまた、等価性を利用すれば、gzipを含む任意の圧縮器から条件付き生成モデルを構築できると述べている。Barry氏が検証するのは、まさにこの理論上の余地だ。
評価することと生成することは同じではない。直ちに圧縮後の長さが最小になる次の1バイトだけを毎回選ぶ方式は、良好な結果を出せない。gzipは整数バイト単位の長さしか報告しないため、同点が多く生まれ、信号が見えにくくなるからだ。そのためGziPTは、バイト列に対してビームサーチを用いる。生存した候補をコーパス内に見つかるバイトで延長し、提案された各範囲を圧縮し、圧縮しやすい部分的な続きをbeam_width個だけ残して、それを指定バイト数にわたって繰り返す。その後、最良の範囲を確定するか、正のtemperatureが設定されている場合は最終候補の中から標本抽出してから、処理をやり直す。
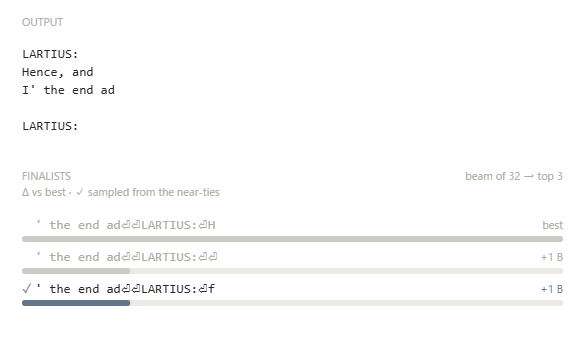
再生画面では、GziPTが複数の続き候補を圧縮後の長さで評価し、上位候補から選ぶ様子が分かる。
文脈の設計は特に示唆に富む。Barry氏によると、評価に使う文脈は、コーパスの範囲と、プロンプトおよび生成済み文章の直近の部分だけを組み合わせたものだという。履歴全体を利用可能にすると、文字どおりの反復が安くなるため、生成器がループに陥りやすくなる。直近の部分に制限すればその失敗モードを抑えられるが、一貫性も制限される。生成器は長い論証、筋書き、あるいは一連の制約を維持できない。そのため、見かけ上の知識は局所的かつ機械的なものにすぎず、DEFLATEが言語の独立した表現を獲得した証拠にはならない。
提供された記事には、Tiny Shakespeareで初期化し、「MENENIUS:」というプロンプトを与えた後に生成された、編集済みの200バイトの続きが1件含まれている。出力には見覚えのある名前や演劇的な断片が含まれるが、一貫した会話にはなっていない。Barry氏は、この結果について、文章について何かを知っているが、正確には一貫していないと表現している。この評価はサンプルと整合するが、あくまで著者による定性的評価であり、ベンチマーク結果ではない。この資料には、パープレキシティ、人間による評価、より強力なベースラインとの比較、出力品質を管理された形で検討した調査は含まれていない。
論文自身の概要は、このアプローチを使った過去の試みは成績が悪かったと述べている一方、Barry氏はビームサーチによって生成品質が大幅に向上したと報告している。これらの記述を、gzipが 神経言語モデルと競合するようになったという主張にまとめてはならない。論文は大規模基盤モデルを主として圧縮器として評価し、Chinchilla 70Bについても個別の圧縮結果を報告している。しかし、それらの結果はGziPTのシェイクスピア出力を検証するものでも、汎用テキスト生成器間の順位を確立するものでもない。
実践的な教訓は概念的なものだ。圧縮は、ある続きが文脈にすでに存在するパターンに適合するかどうかを、観察可能で定量的に問う方法を与える。同じ仕組みは条件付き生成も支えられる。一方で、圧縮器が報酬とするのは圧縮しやすさであり、真実性、有用性、独創性、意味理解ではない。GziPTは情報理論と生成をつなぐ巧妙な架け橋を示しているが、証拠が支持するのは、これを汎用言語モデルではなく、圧縮得点による実験と呼ぶことだ。