Claude Max 增加使用额度,并不能证明模型更聪明
Anthropic 的 Max 套餐每月收费 100 或 200 美元,分别提供 Pro 每个会话额度的五倍或二十倍。套餐仍有上限,而使用容量增加并不代表模型更强。
阅读全文 →Anthropic 的 Max 套餐每月收费 100 或 200 美元,分别提供 Pro 每个会话额度的五倍或二十倍。套餐仍有上限,而使用容量增加并不代表模型更强。
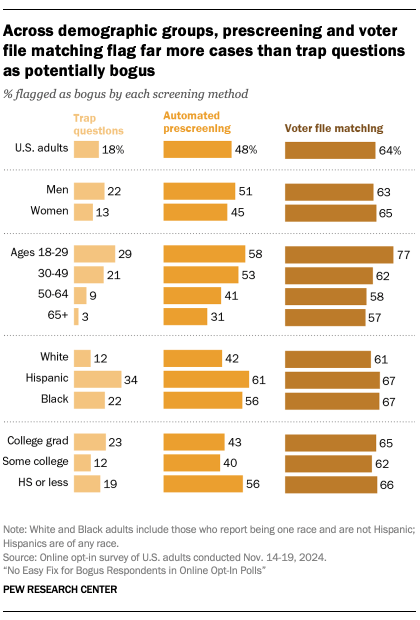
阅读全文 →皮尤研究中心的一项实验发现,常见筛选方法可以改善某些调查质量指标,但没有任何一种方法能在不误删有效回答的情况下可靠剔除欺诈受访者。选民档案匹配作为清理工具的表现尤其差。
阅读全文 →Stripe将内部助手 Kai 描述为连接公司知识与可复用智能体工具的平台。合作伙伴的案例补充了架构细节,但采用效果和安全性尚未经过独立审计。
阅读全文 →FBI表示正在调查 fbijobs.gov 遭入侵及员工信息可能泄露的说法。该声明没有证实攻击者所称的影响范围,也没有确认被盗数据的具体内容。
阅读全文 →Google的新款 Gemini 3.8 语音模型支持定制声音、逐句指导和双人场景。Google公布了基准成绩与同意保护措施,但针对这次发布的独立证据仍有限。
阅读全文 →随着人工智能系统开始产生日益复杂且影响深远的数学见解,研究界正面临一项严峻挑战:如何保持人类的理解力与能动性。Amit Sahai 在 Terence Tao 的博客上发表的一篇客座文章指出,社会必须优先培养一支由数学家组成的“可部署智力储备”队伍,以解读并验证这些突破性成果。
阅读全文 → terrytao.wordpress.com
第 59 届 ACM 计算理论研讨会 (STOC 2027) 宣布了投稿流程的重大变革,包括强制要求公开预印本、提交视频演示,以及针对生成式人工智能工具使用的新披露要求。
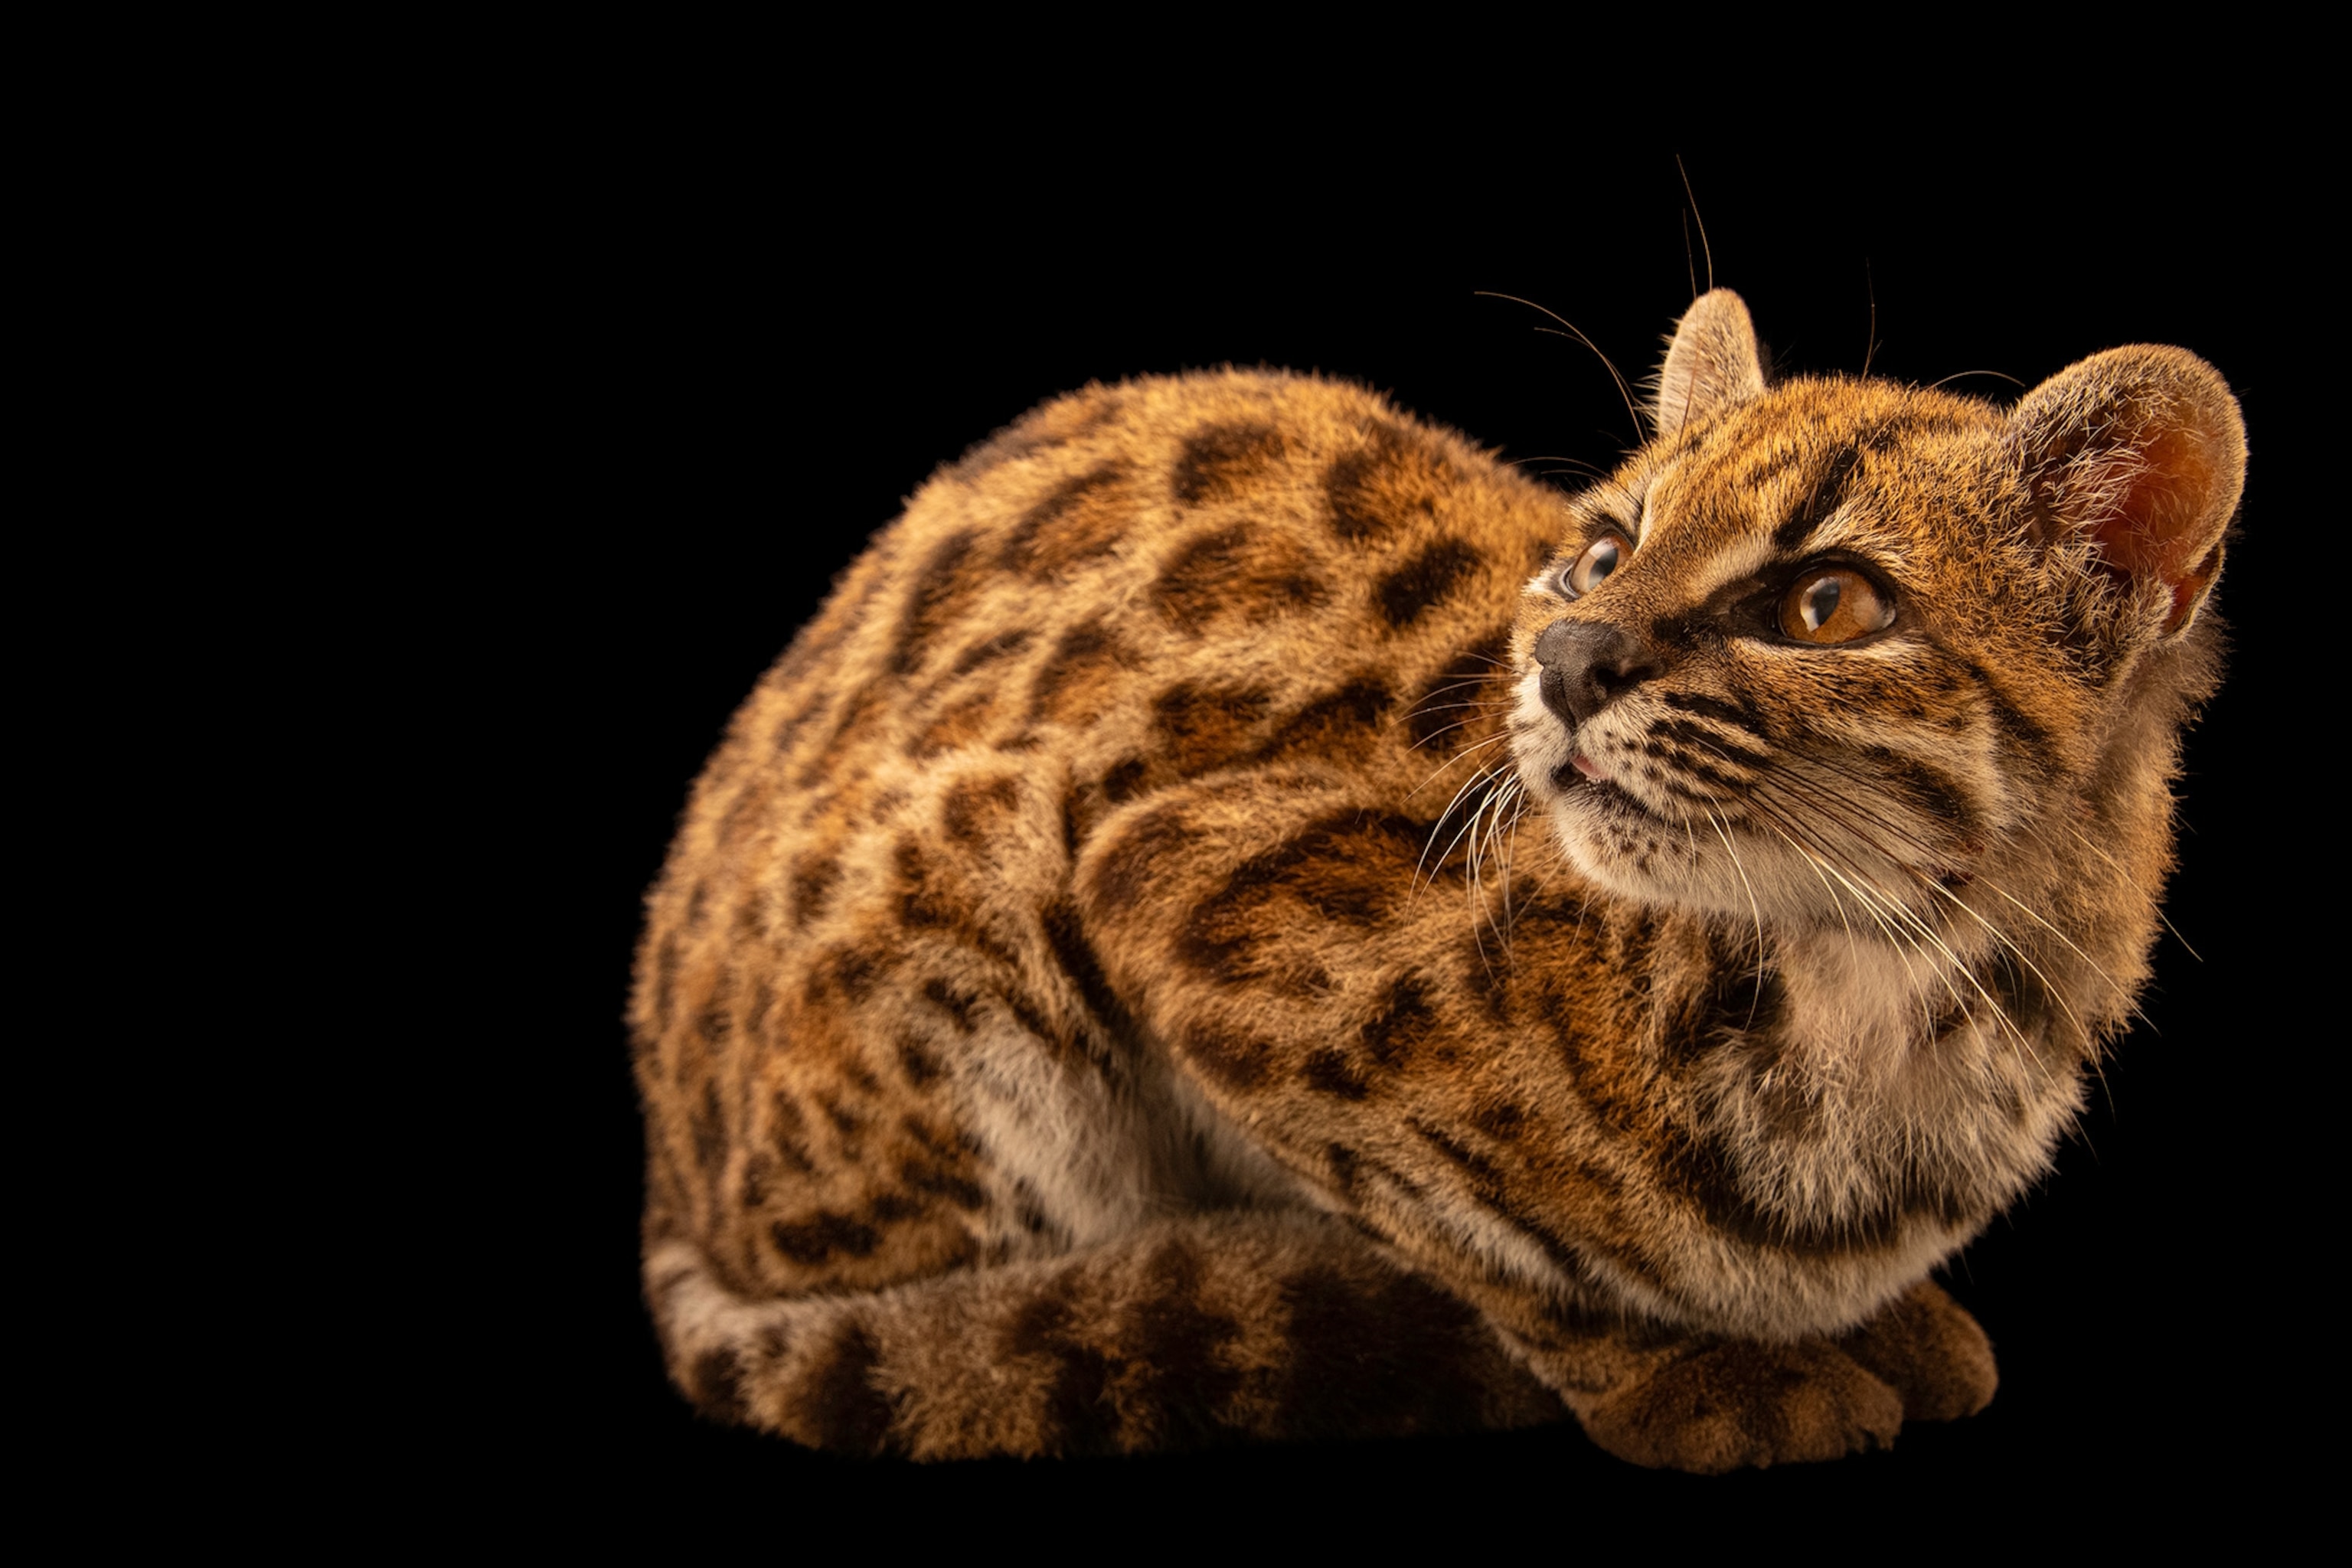
阅读全文 →研究人员正式确认了Leopardus tilcayo,这是一种原产于玻利维亚永加斯森林的小型斑点野猫,标志着一个多世纪以来首次发现新的猫科动物物种。
阅读全文 →一项名为“母巢之战基准测试”(Brood War Bench)的新基准,旨在测试当前大语言模型作为自主智能体在经典即时战略游戏《星际争霸:母巢之战》中的能力,结果揭示了它们在长期规划与执行方面存在显著局限。
阅读全文 →发表在《自然-神经科学》上的最新研究表明,在前脑和后脑的胚胎发育过程中,它们源自两个独立且平行的祖细胞群,这可能为研究神经系统疾病提供新的实验室模型。
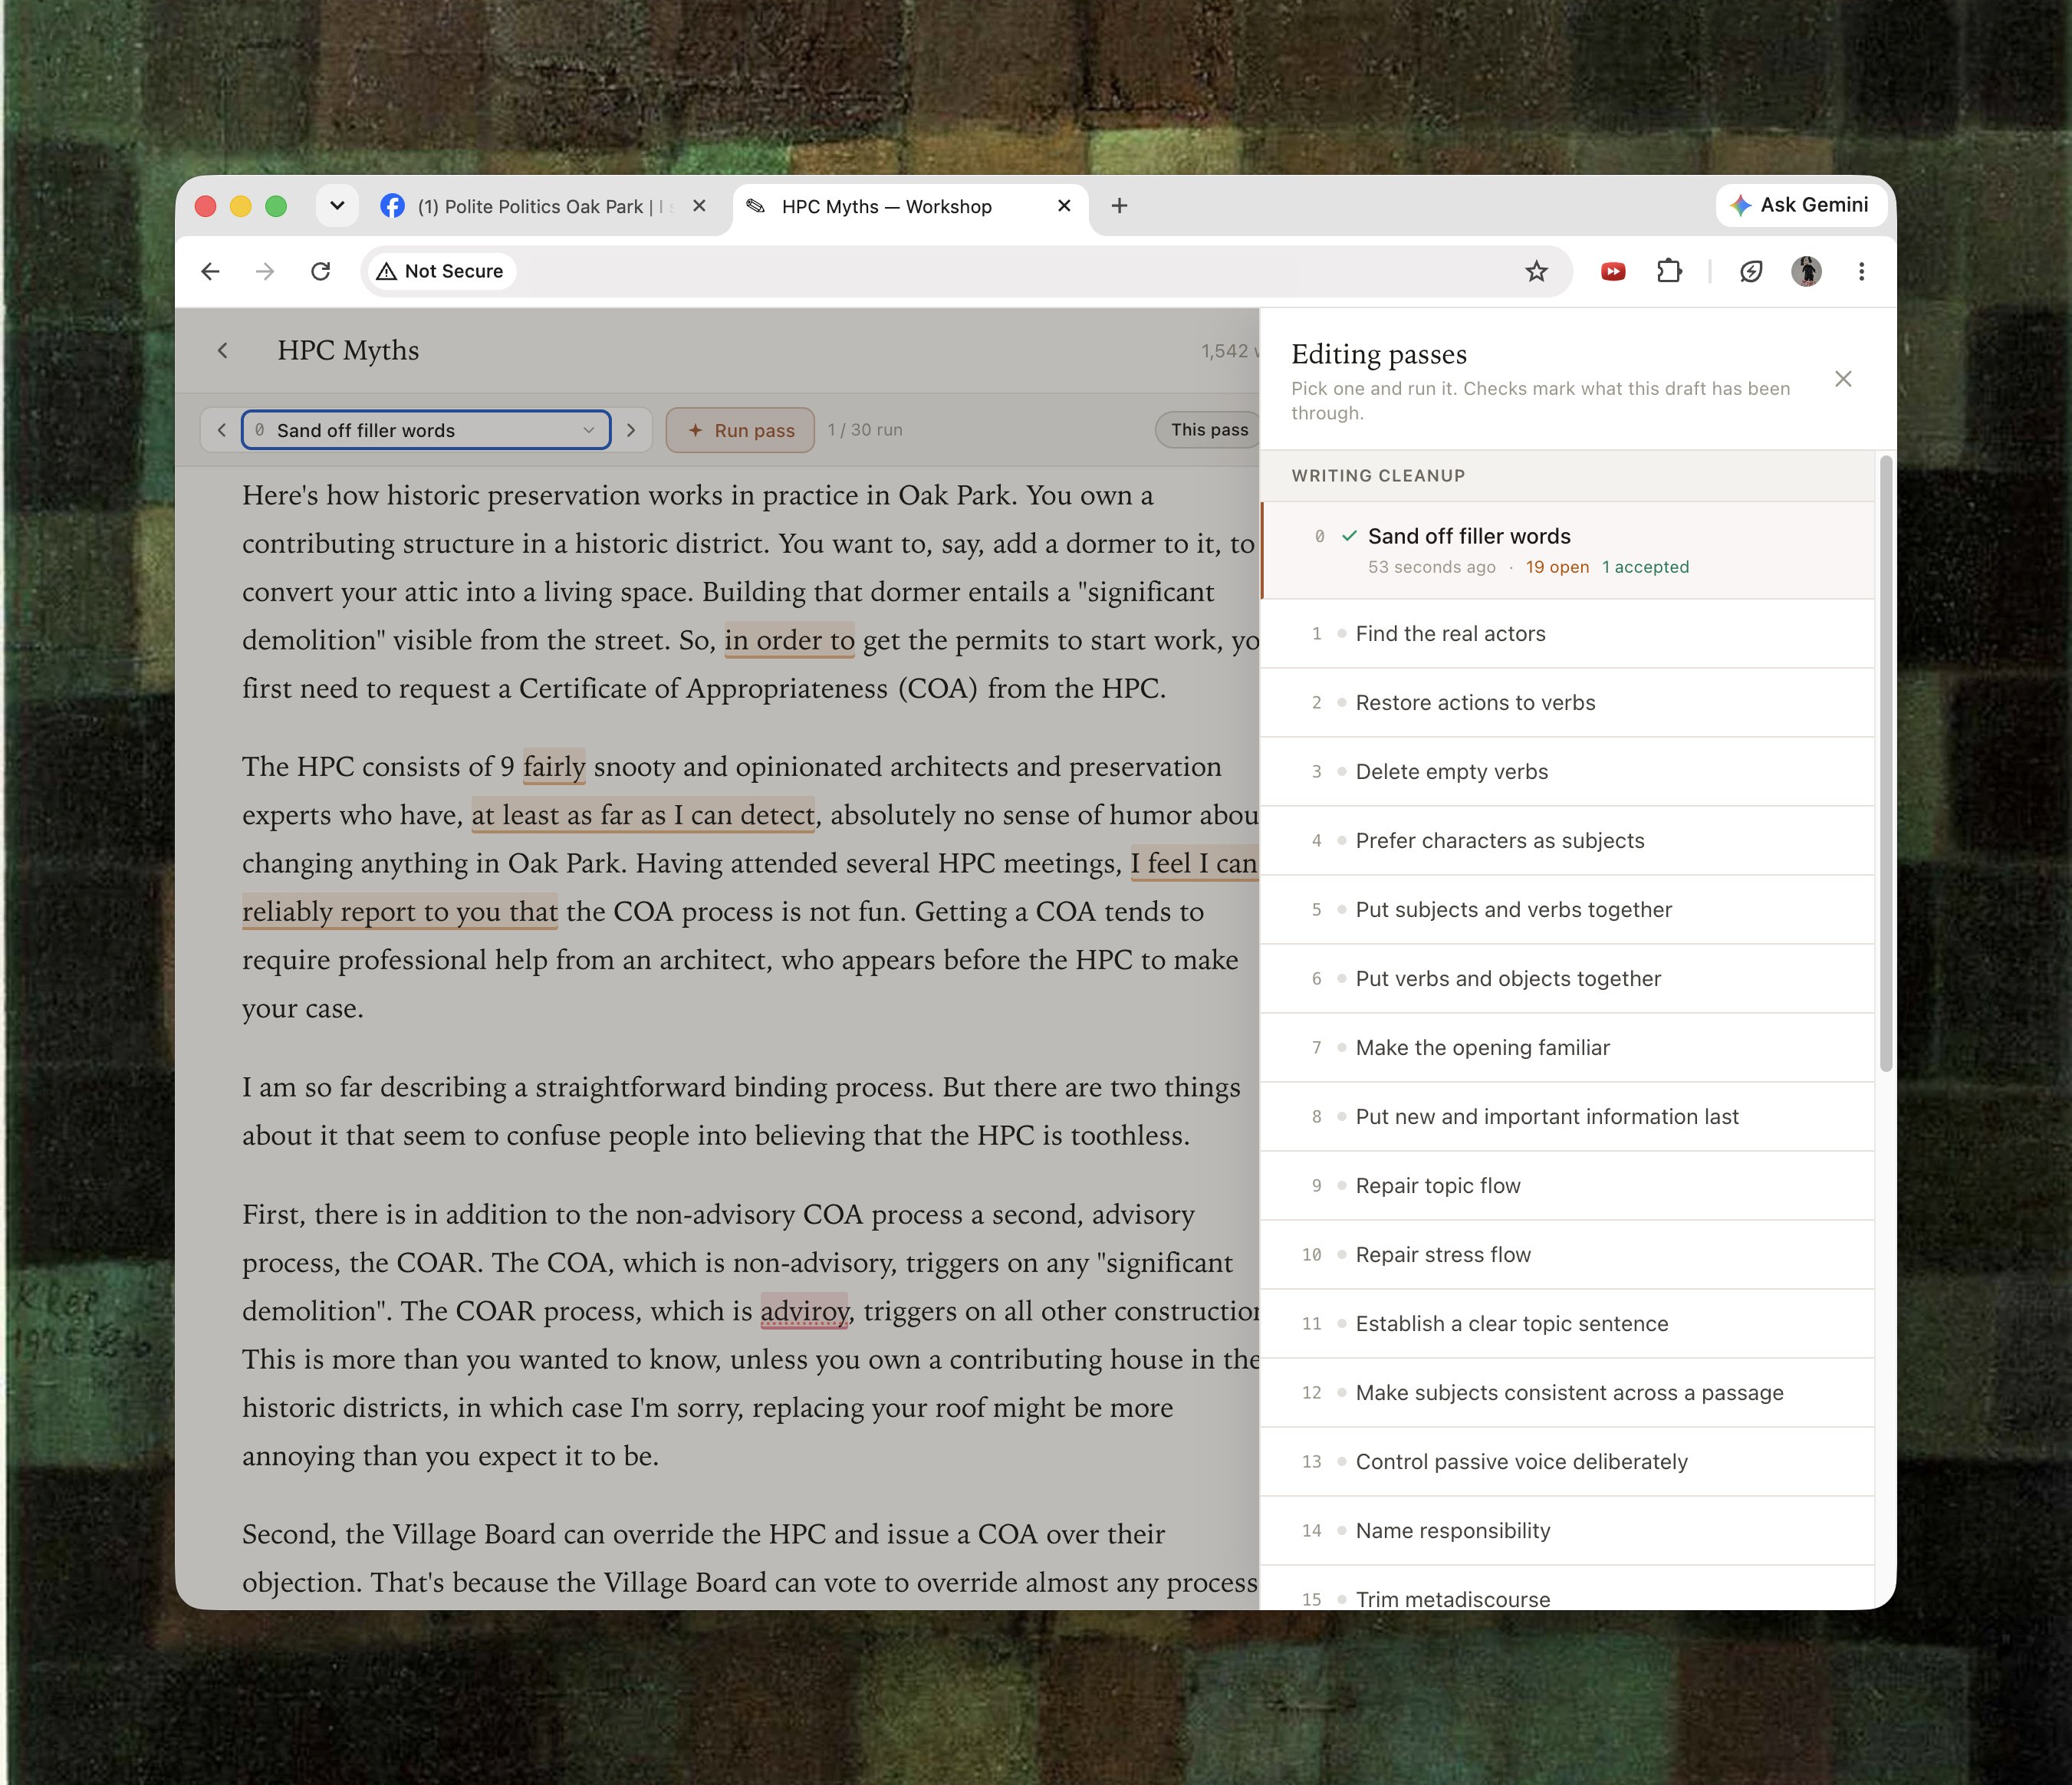
阅读全文 →为了在保持个人风格的同时将大型语言模型(LLM)作为有效的写作助手,作者应将模型视为校对者而非代笔者。通过严格避免使用模型建议的措辞并禁用人工智能的鼓励性反馈,作者可以利用LLM识别结构缺陷和风格不一致之处,而不至于陷入生成平庸的机器文本。
阅读全文 →数学家陶哲轩与特邀撰稿人格兰特·桑德森认为,数学界应当在传统的证明生成研究之外,正式认可并奖励那些阐明数学发现“为何”与“如何”的“动机性解释”工作。
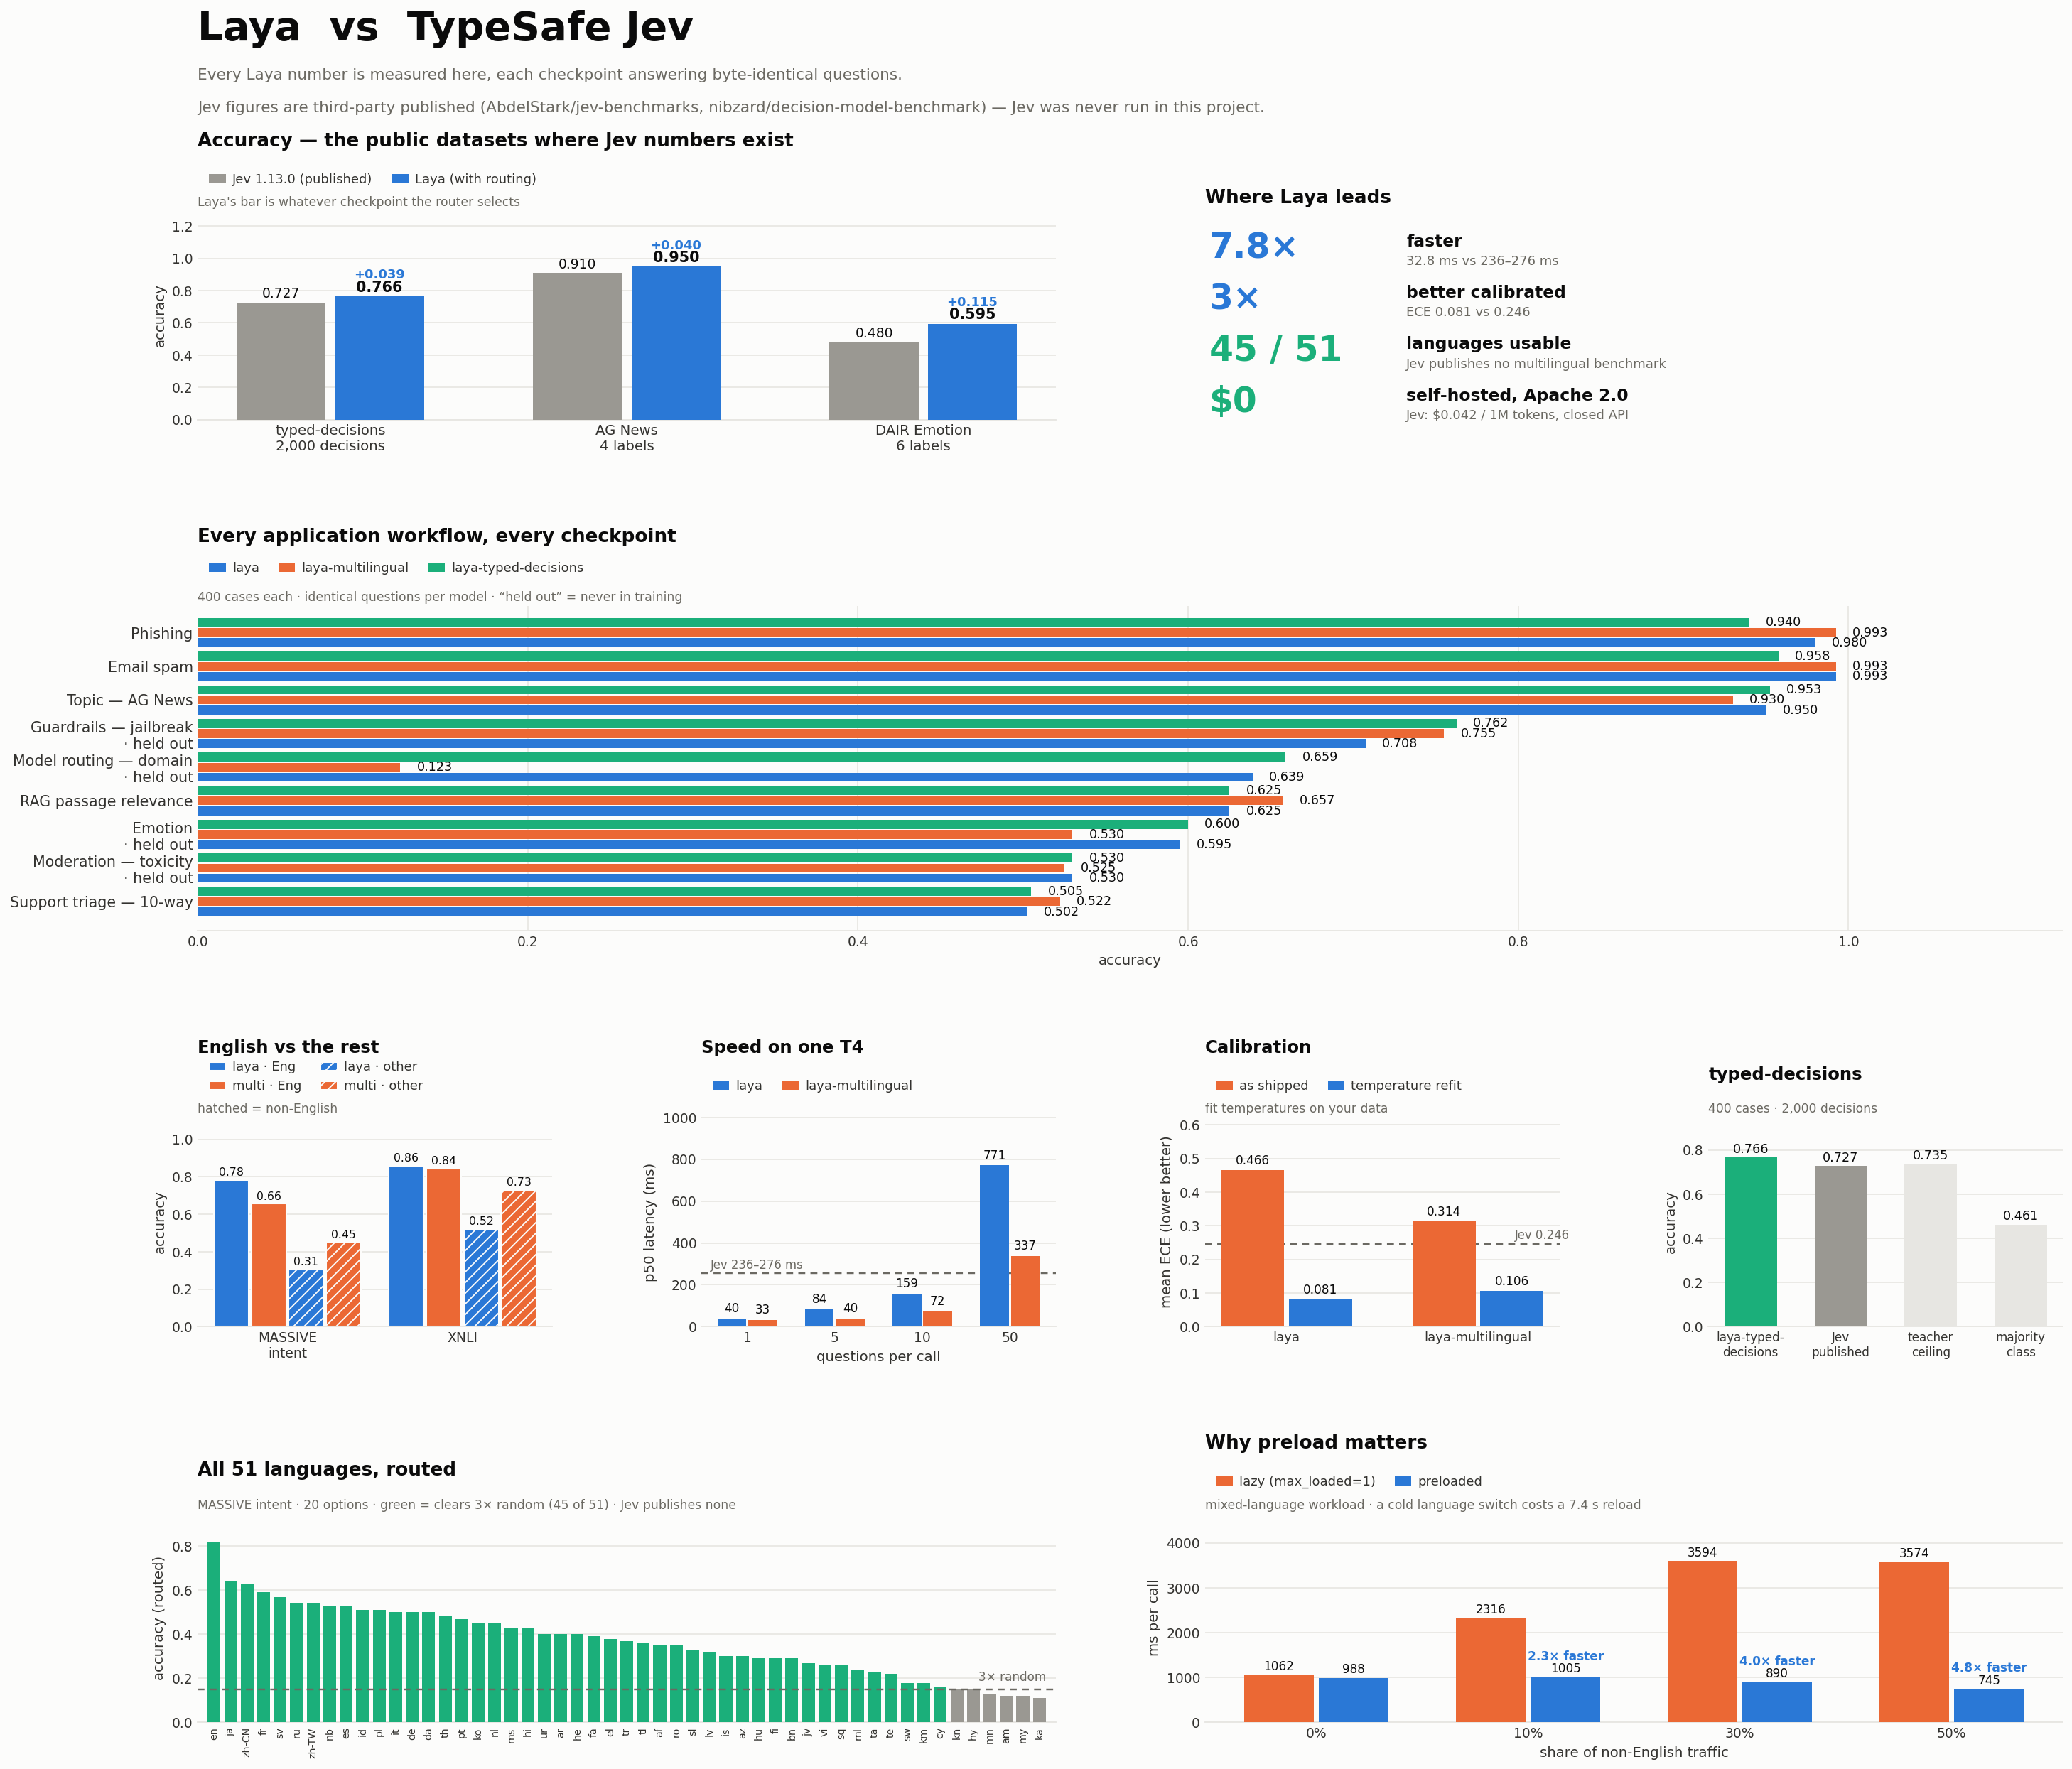
阅读全文 →terrytao.wordpress.comLaya 是一款全新的开源非自回归决策引擎,旨在取代生成式大语言模型,以处理路由、分类和分流等结构化任务。通过利用强化学习和双向编码器,它能在 35 毫秒内提供经过校准的概率输出,为专有黑盒模型提供了一种透明且高速的替代方案。
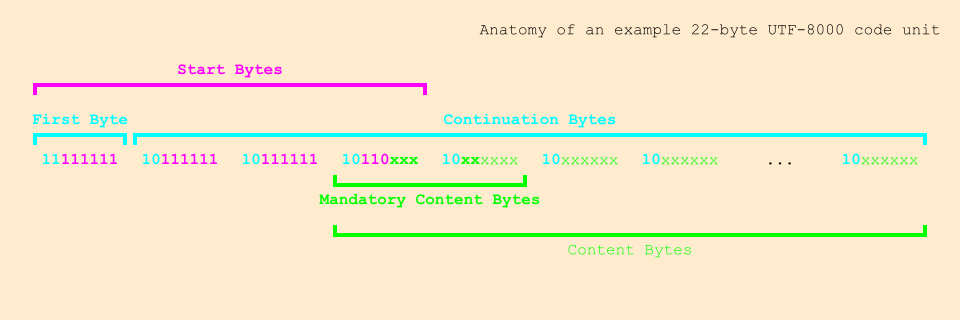
阅读全文 →UTF-8000是对标准UTF-8字符编码的一项提议扩展,它通过引入一种跨多个字节分段起始位的机制,允许使用任意长度的代码单元,从而在理论上实现了对无限码点范围的表示。
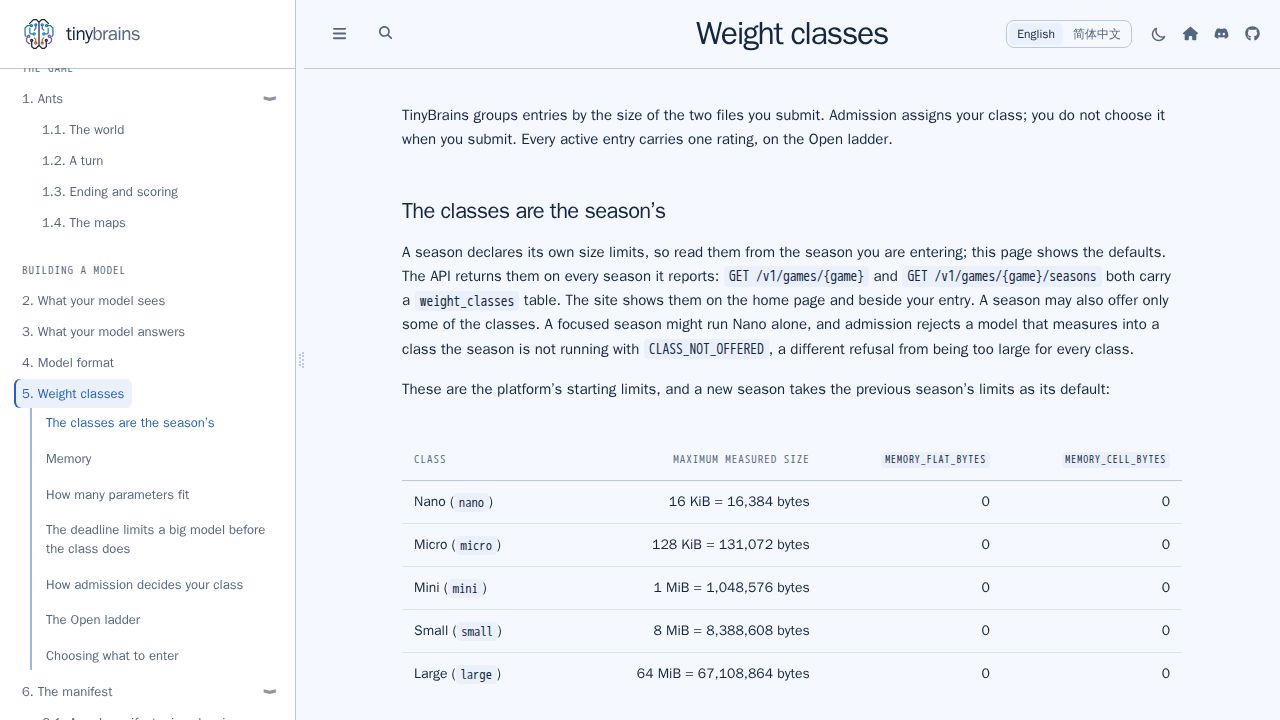
阅读全文 →TinyBrains 是一个全新的竞技平台,旨在挑战开发者构建能够玩策略游戏的小型高效神经网络。参赛作品根据文件大小分为不同权重级别,并通过一对一比赛来评估性能。
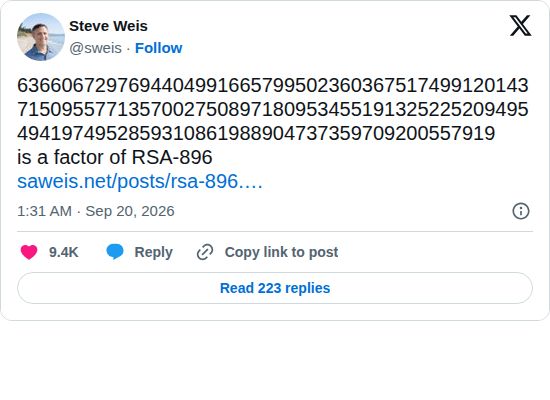
阅读全文 →Stephen Weis利用Claude将CADO-NFS算法移植到GPU上,通过调用2048个GPU组成的集群,在十天内利用闲置算力成功分解了RSA-896挑战数。
阅读全文 →