现代人工智能流水线通常依赖生成式大语言模型(LLM)来处理电子邮件分流、网络钓鱼检测或工单路由等简单的结构化任务。这种方法引入了显著的延迟,因为模型必须流式传输标记,并且在幻觉和数学校准方面存在挑战。Laya 是一款新发布的开源决策引擎,通过采用“系统 1”架构解决了这些低效问题——这是一种非自回归方法,无需生成自由文本即可提供即时的、反射式的决策。Laya 的运行基于三个核心原语:用于从标准准则中进行选择的“choice”、用于将输入置于序数准则上的“score”,以及用于直接布尔概率预测的“noul”。由于模型仅输出数字和概率,它消除了对正则表达式或 JSON 解析的需求,并防止了生成式模型中常见的幻觉现象。该系统在标准硬件上的推理速度约为每个问题 33 毫秒,显著优于传统的生成式 LLM 工作流。为了处理多样化的输入,Laya 包含一个内置路由器,可检查 22 种字母表的输入文本的 Unicode 脚本,并自动将请求引导至适当的专用检查点(例如多语言 mmBERT-base 模型),且开销微乎其微。这种路由能力确保了系统在 100 多种语言中保持高准确性。Laya 以 Apache 2.0 许可证发布,为专有决策 API 提供了一种透明且可自托管的替代方案。通过专注于校准后的置信度分数而非生成文本,Laya 使开发人员能够构建生产就绪的护栏和自动化工作流,这些工作流比依赖自回归模型的方案更快、更可靠。
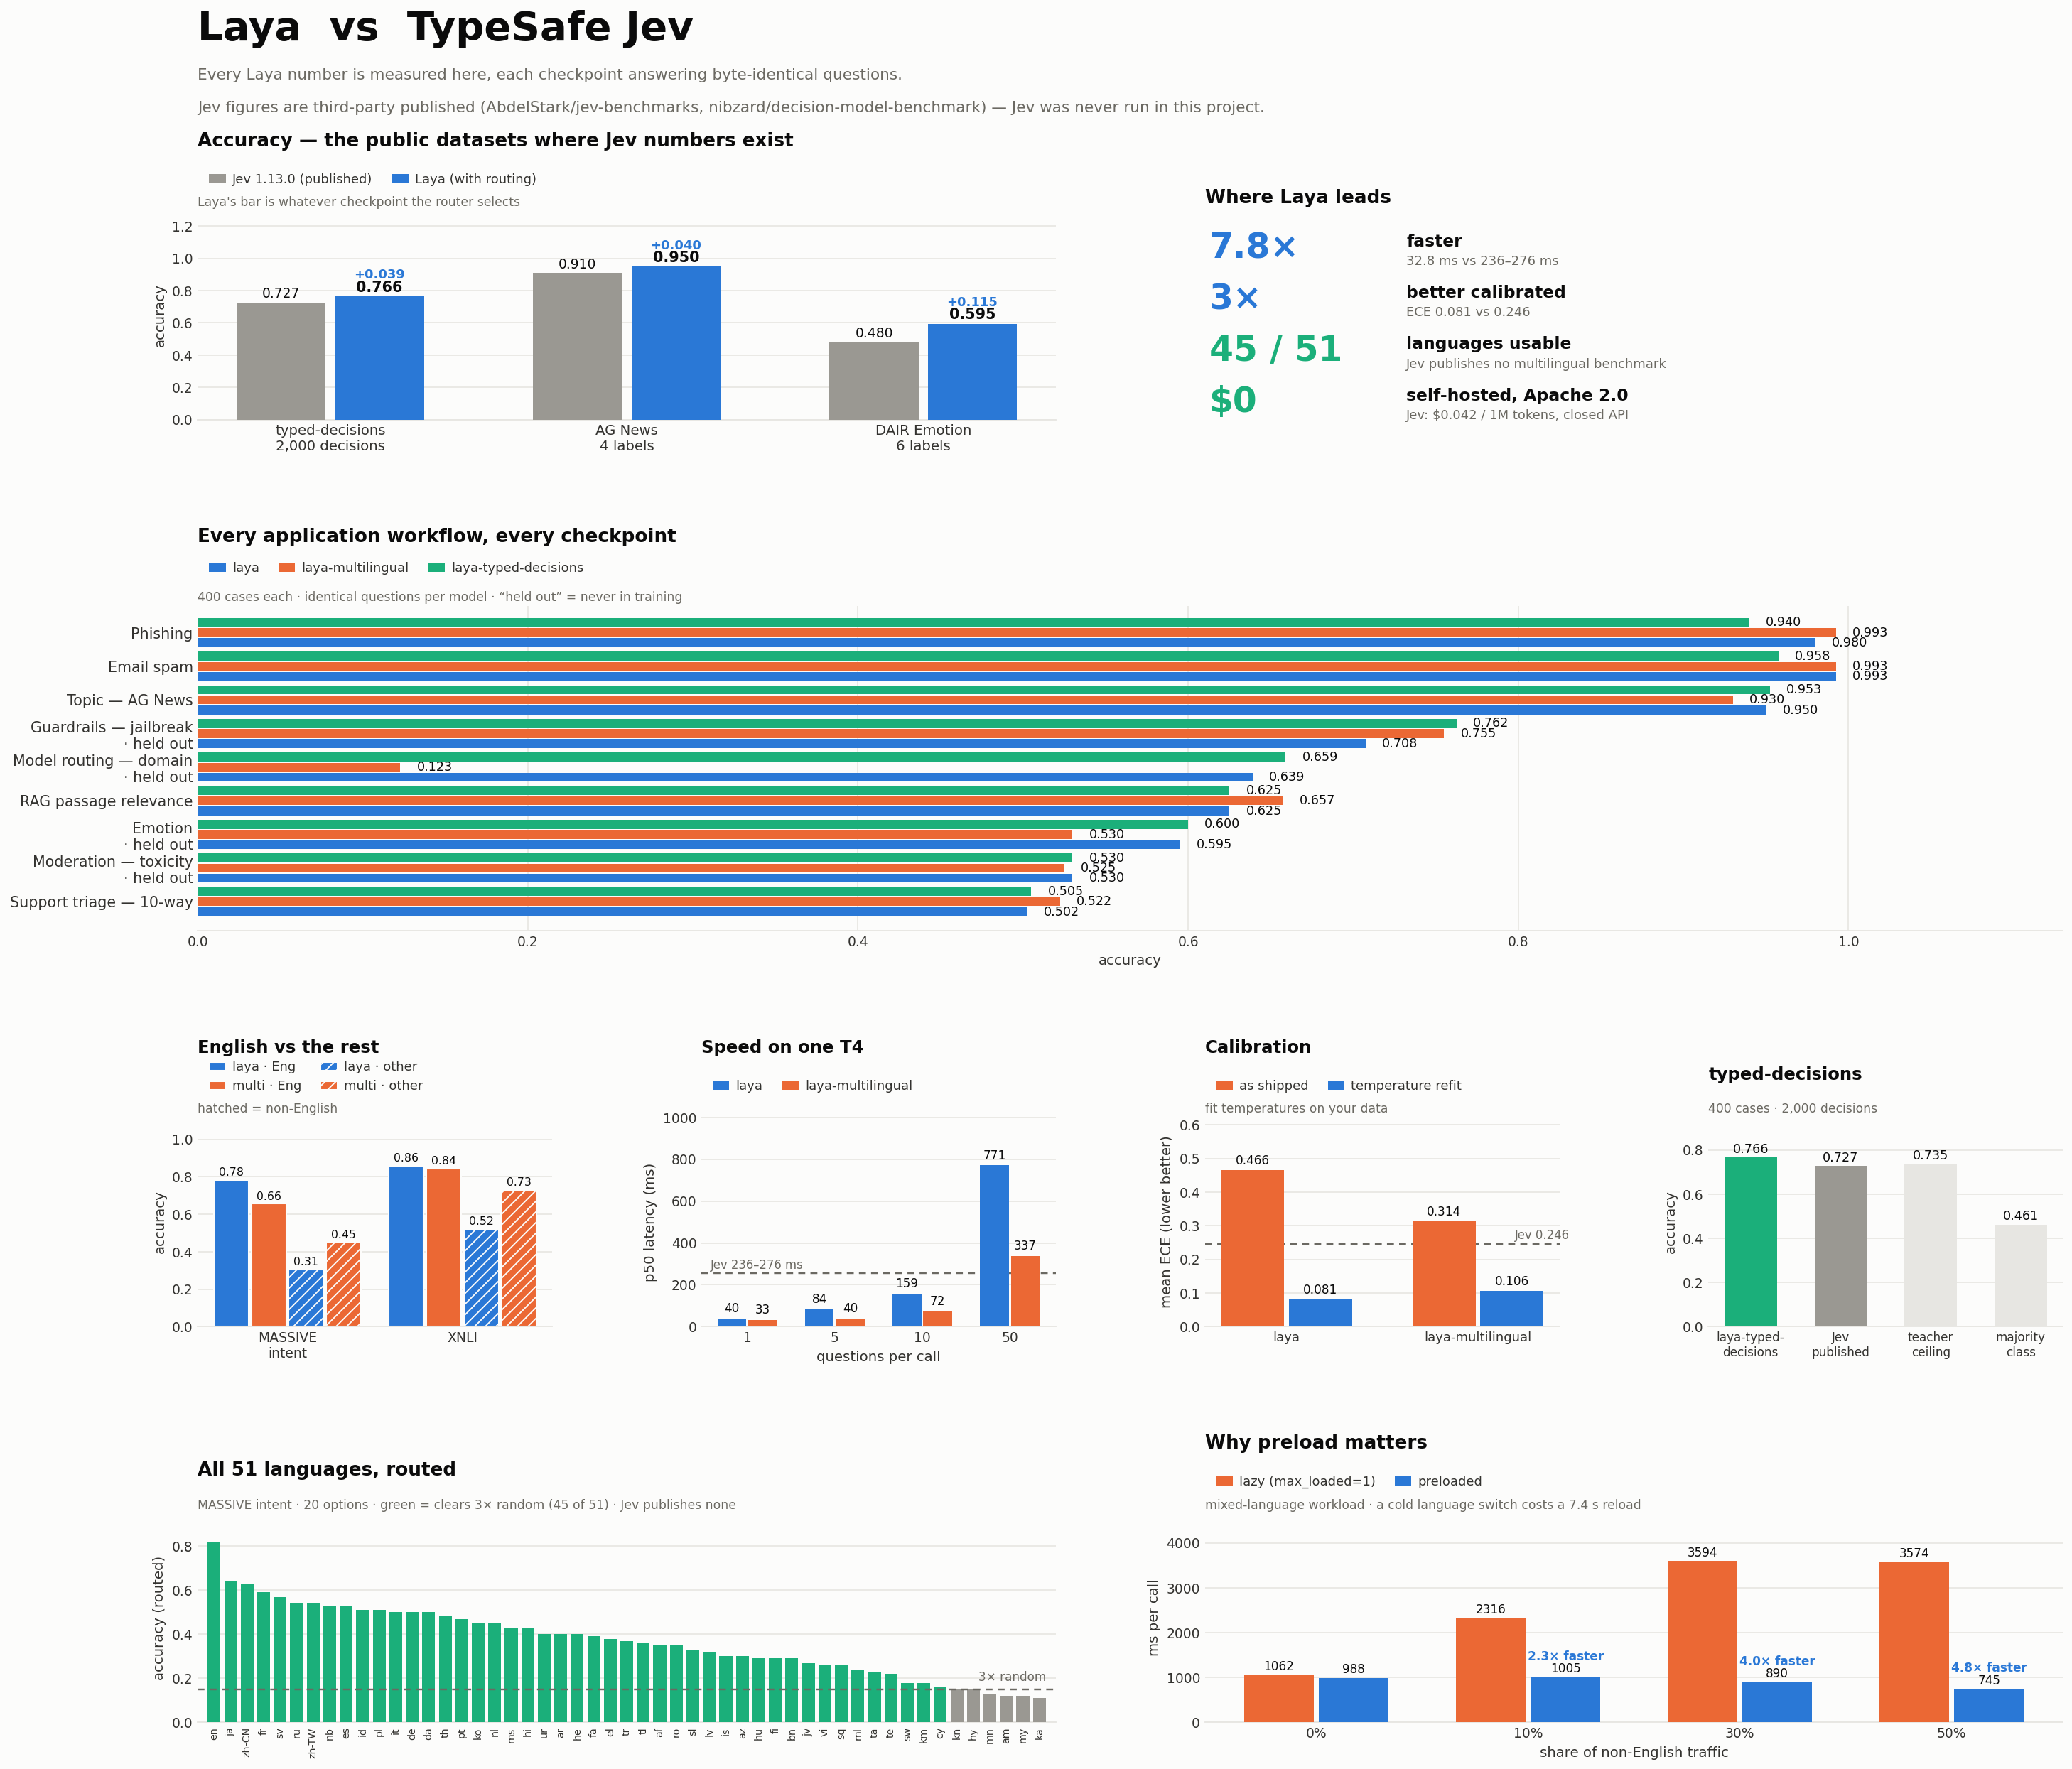
该图表展示了与 TypeSafe Jev 等现有决策框架相比,Laya 非自回归架构的性能优势。