UTF-8是一种广泛使用的字符编码,它使用一到四个字节来表示Unicode字符。虽然UTF-8的最初设计曾支持长达六字节的序列,但为了与UTF-16的限制保持一致,该标准在2003年被限制为最多四个字节。UTF-8000是一项实验性提案,旨在取消这一限制,允许使用任意长度的代码单元以容纳无限数量的码点。UTF-8000的核心机制涉及将第一个字节的最高位拆分为自同步位和起始位。当代码单元超过单个字节的容量时,起始位会被分段分布在后续的延续字节中。这种方法保持了标准UTF-8的前缀自由属性,确保可以通过读取指示序列长度的起始位来确定代码单元的长度。通过使用这种方法,UTF-8000避免了在代码单元之间使用辅助标点符号的需要,保留了原始标准的自同步和自标点特性。该规范保留了现有的ASCII兼容性规则,并禁止冗长编码(即使用超过必要字节数来表示字符),以防止诸如C语言函数(如strcpy)在处理空字节不当时可能引发的安全漏洞。尽管该提案在技术设计上具有创新性,但仍面临实际挑战。如果软件不对输入大小强制执行严格限制,实现对任意长度代码单元的支持会引入潜在风险,例如缓冲区溢出漏洞。此外,由于该标准要求读取起始位来确定长度,与当前标准的固定长度限制相比,极长的序列可能会使解析和内存管理变得复杂。
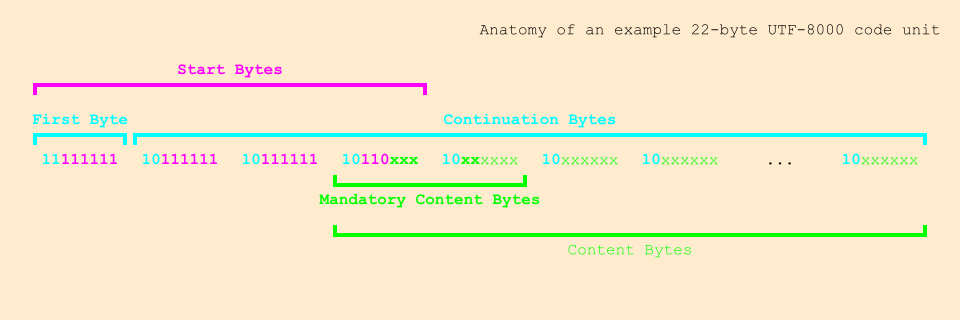
文章描述了UTF-8000如何跨字节拆分位以保持前缀自由属性,该解剖图对此进行了直观说明。
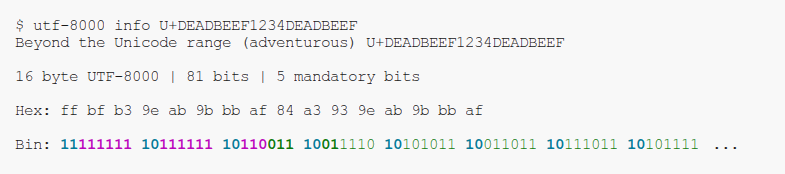
此信息图提供了提案中讨论的编码机制的具体示例,有助于可视化其理论上的无限范围。