El proyecto e-means introduce una regla de optimización moderna que logra una reducción de 10 a 45 veces en el tiempo de reloj en GPUs y una reducción de 8 a 15 veces en CPUs en comparación con las implementaciones de k-means de vanguardia. Al reemplazar el algoritmo tradicional de lote completo de Lloyd por un enfoque de mini-lote que utiliza promedios móviles exponenciales (EMA), el método mejora simultáneamente la calidad de la agrupación y la velocidad de entrenamiento.
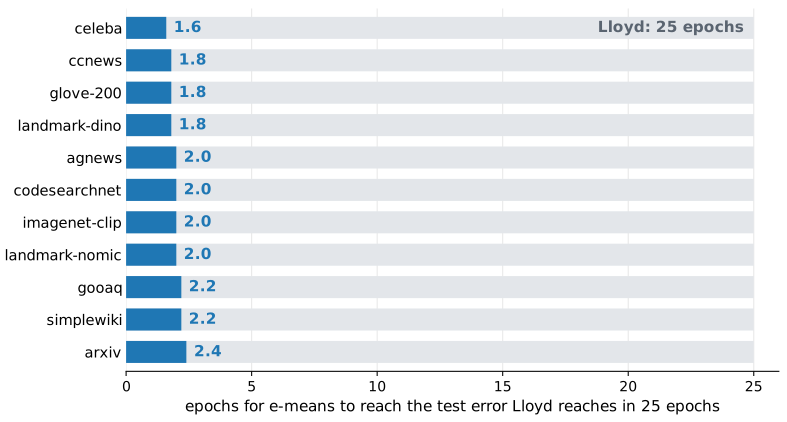
Este gráfico ilustra la reducción significativa en las épocas requeridas por e-means para alcanzar la misma pérdida de prueba que el algoritmo de Lloyd tradicional.
De Lote Completo a Promedios Móviles Exponenciales
El k-means tradicional suele depender del algoritmo de Lloyd, que requiere un paso completo sobre todo el conjunto de datos para actualizar los centroides en cada iteración. Aunque es preciso, este enfoque es lento para conjuntos de datos masivos y puede quedar fácilmente atrapado en mínimos locales porque su pérdida siempre disminuye de forma monótona.
e-means reemplaza esto con una regla de actualización de mini-lote que utiliza promedios móviles exponenciales (EMA). En lugar de recalcular las estadísticas desde cero, actualiza la suma y el recuento de puntos para cada clúster a una tasa de alpha, lo que permite que el centroide rastree las asignaciones recientes en lugar de toda la historia. Este enfoque es más estable que el descenso de gradiente porque las actualizaciones de EMA garantizan que el centroide permanezca dentro de la envolvente convexa de los puntos asignados.
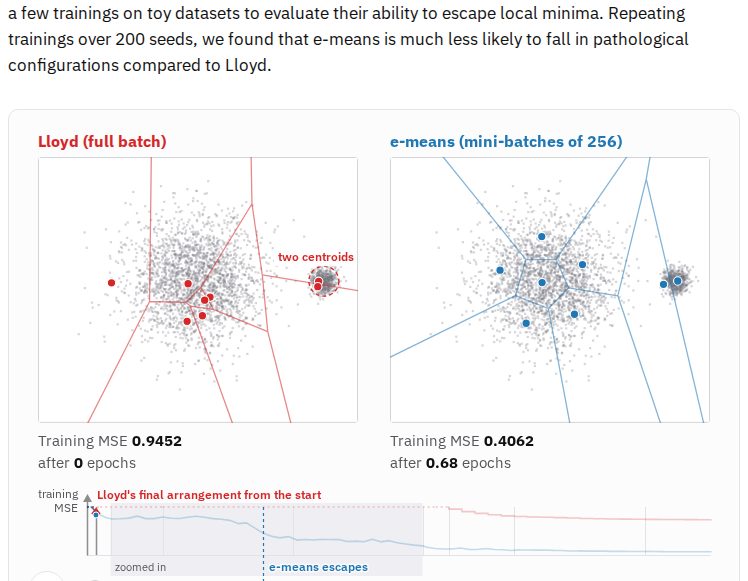
La figura demuestra cómo la regla de actualización de promedio móvil exponencial (EMA) proporciona una alternativa estable y efectiva a los métodos tradicionales.
“e--means logra tanto una mejor velocidad como una menor pérdida.”
— e-means: 10x faster k-means at equal loss - Blog
Leyes de Escalado Automatizadas y Robustez
Un obstáculo significativo para el k-means de mini-lote es la necesidad de ajustar hiperparámetros como el tamaño del lote y el tamaño del paso. e-means resuelve esto utilizando leyes de escalado para derivar automáticamente estos valores a partir de las características del problema (número de puntos, clústeres y épocas objetivo). Esto asegura que el algoritmo funcione de manera óptima sin intervención manual.
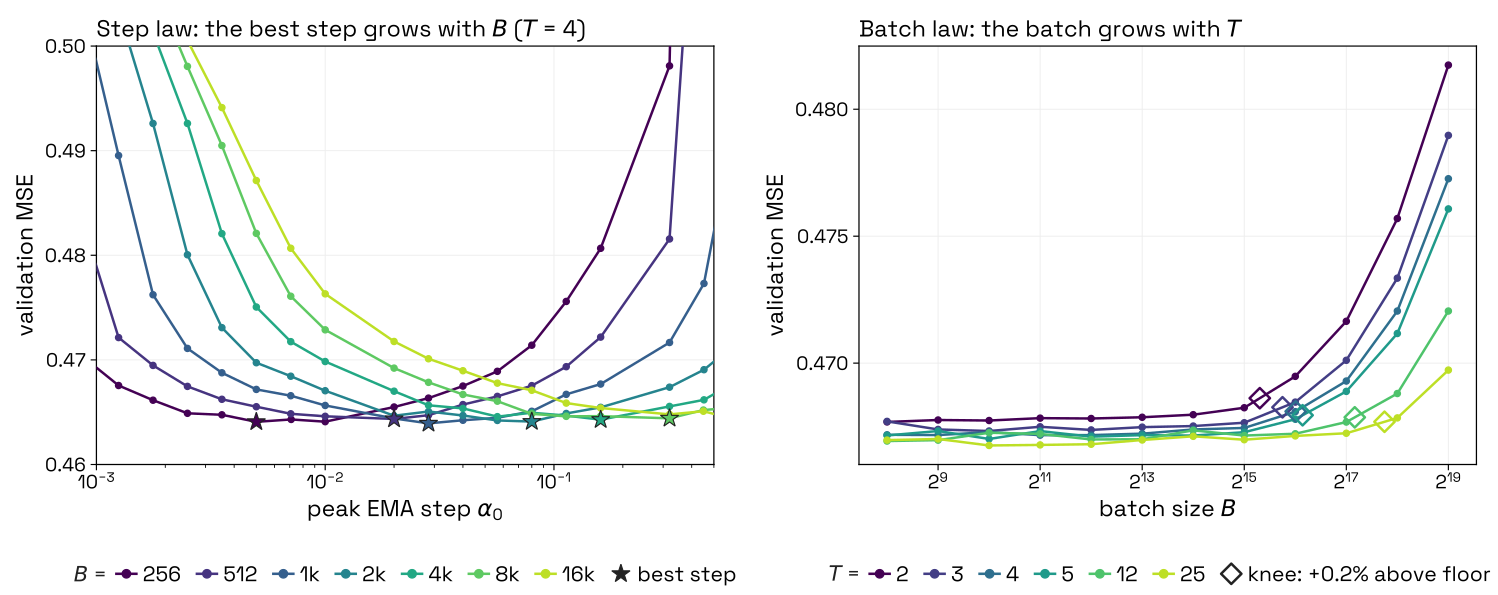
El proyecto utiliza estas leyes de escalado para eliminar la necesidad de ajustar manualmente los hiperparámetros en el k-means de mini-lote.
El proyecto también mejora la confiabilidad de la agrupación mediante la implementación de una estrategia de 'revivificación de clústeres muertos'. Cuando un clúster se queda sin puntos asignados, e-means lo revive dividiendo un clúster grande y activo en lugar de simplemente volver a muestrear un punto aleatorio. Esto preserva la capacidad del libro de códigos y evita que el número efectivo de clústeres se reduzca durante el entrenamiento.
Ganancias de Rendimiento y Compensaciones
La validación experimental en 24 conjuntos de datos diferentes muestra que e-means alcanza consistentemente una pérdida de prueba menor que el algoritmo de Lloyd. Por ejemplo, en el benchmark de incrustación VIBE, e-means alcanzó el error objetivo en 1.6 a 2.4 épocas, una reducción masiva desde las 25 épocas requeridas por las implementaciones estándar.
Si bien los cambios algorítmicos proporcionan la base para estas ganancias, el proyecto también utiliza kernels especializados para asegurar que estas mejoras se manifiesten como aceleraciones de tiempo de reloj. La principal compensación es que la eficiencia del método depende de estos kernels optimizados para traducir la reducción en las épocas requeridas en ahorros de tiempo prácticos en hardware como las GPUs.
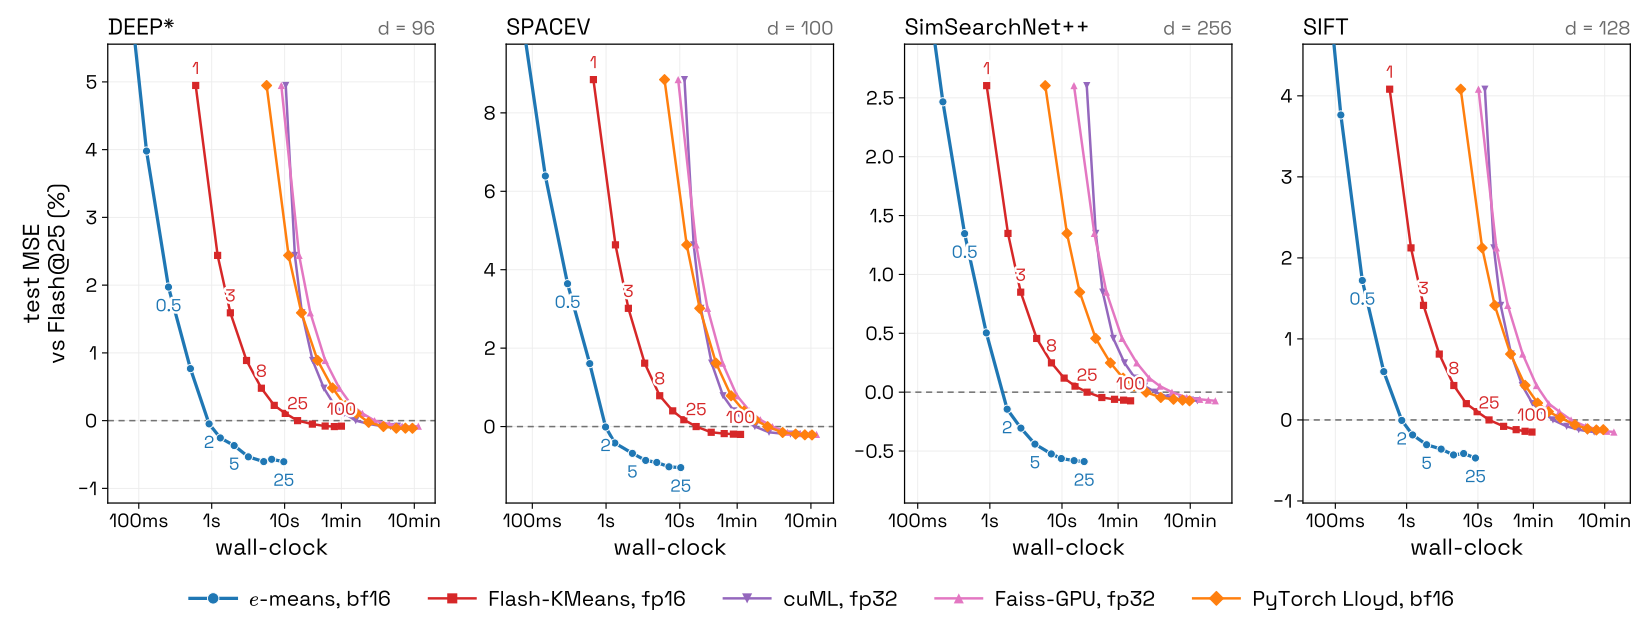
Esta visualización demuestra las aceleraciones prácticas de tiempo de reloj logradas al combinar mejoras algorítmicas con kernels especializados de GPU.
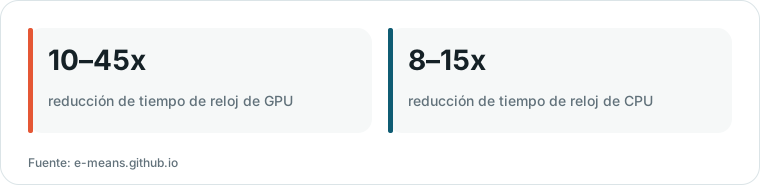
Gráfico elaborado por HN Digest a partir de cifras reportadas por e-means.github.io; los valores se muestran tal como aparecen en la fuente.