El algoritmo HaCI, o Harmonic Contour Integration, proporciona un método compacto para extraer bordes de imágenes RGB imitando los procesos de la visión biológica. Desarrollado por RenderBear, el algoritmo procesa las imágenes a través de un flujo de trabajo distribuido que avanza desde el contraste a nivel de píxel hasta la retroproyección de crestas de alta resolución. Ofrece una alternativa especializada a la detección de bordes estándar, equilibrando la plausibilidad biológica con un rendimiento medible en pruebas de referencia como BRIND y BIPED.
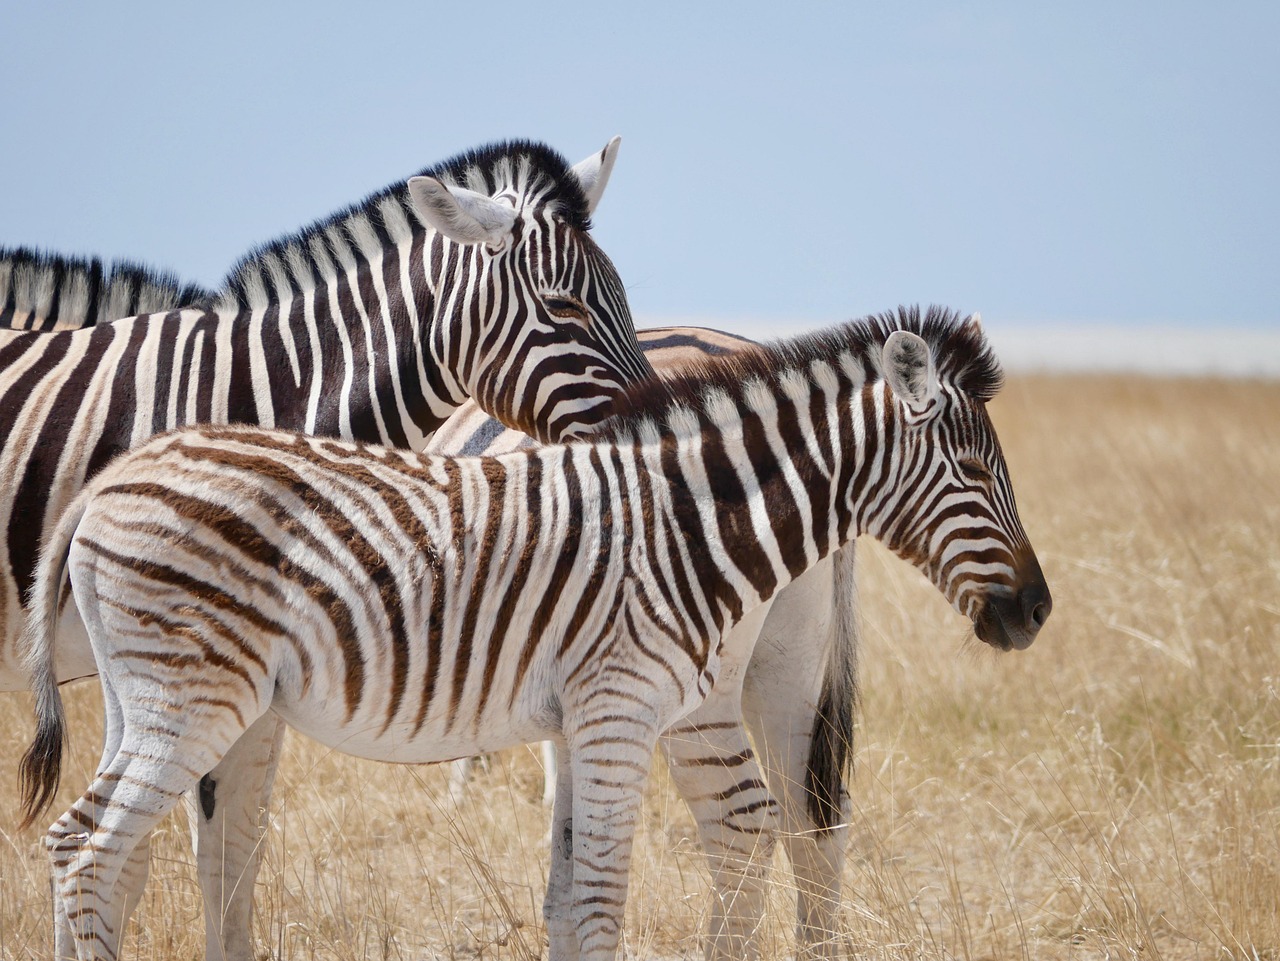
Esta imagen sirve como un ejemplo representativo de los datos de entrada RGB que el algoritmo HaCI procesa a través de su flujo de trabajo de cuatro etapas.
El flujo de trabajo de cuatro etapas
El algoritmo comienza en la etapa L0, donde cada píxel se compara con sus ocho vecinos utilizando una métrica de luminancia/croma aprendida. Este contraste se divide por un grupo espacial local de contraste, creando un campo armónico por píxel. En la etapa L1, estos armónicos se suman sobre parches superpuestos en una cuadrícula de celdas dispersas para producir respuestas sintonizadas con la orientación.
La etapa 'Seed' aplica principios biológicos como el control de ganancia Naka–Rushton y los campos de asociación. Este paso escala las respuestas basándose en las celdas vecinas a lo largo de un contorno y utiliza la supresión de flancos para dividir los contornos paralelos. Este proceso asegura que los bordes aislados se preserven mientras las texturas y rejillas se amortiguan. Finalmente, la etapa 'Render' proyecta estas respuestas de celda de nuevo a la resolución completa utilizando kernels 1D aprendidos para producir un mapa de límites suaves.
“Un algoritmo compacto y totalmente distribuido que extrae bordes de imágenes RGB a través de cuatro etapas:”
— GitHub - RenderBear/haci: A compact, fully distributed algorithm that extracts edges from RGB images
Rendimiento de referencia
HaCI fue evaluado en el conjunto de pruebas BRIND, que consiste en 200 imágenes re-anotadas para diferentes tipos de discontinuidades. El mapa adelgazado por NMS del algoritmo logró un ODS (Optimal Detection Score) de 0.7179 y una precisión de 0.6791. El mapa suave sin procesar producido por el renderizador mostró un ODS ligeramente inferior de 0.7158.
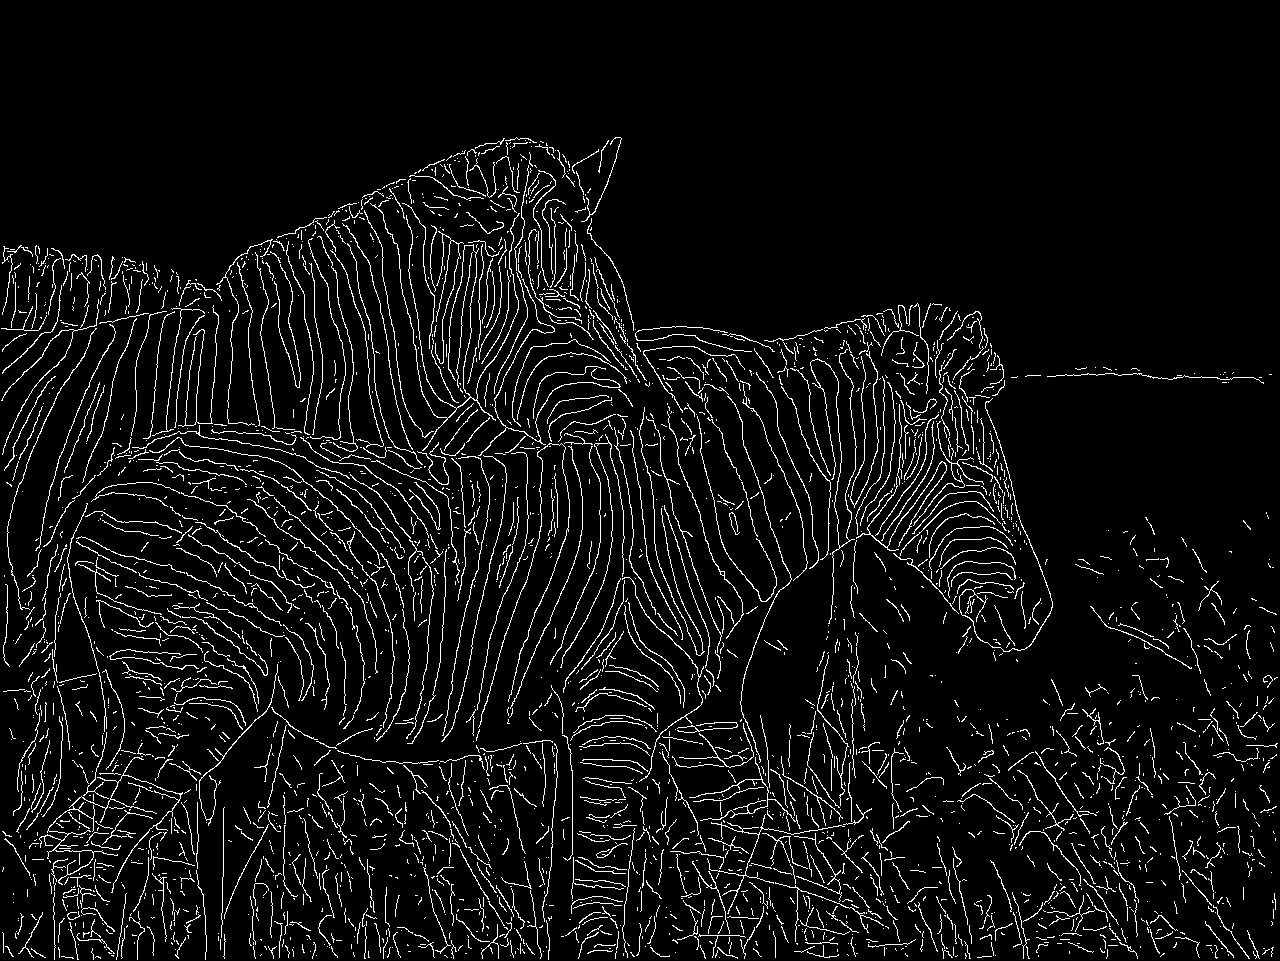
Esta figura ilustra la salida final del flujo de trabajo de HaCI, mostrando los bordes y contornos extraídos.
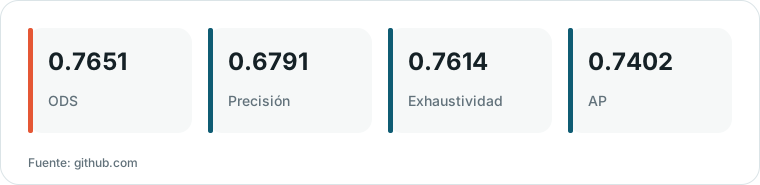
Gráfico elaborado por HN Digest a partir de cifras de github.com; los valores se muestran como en la fuente.
El proyecto también admite pruebas en los conjuntos de datos BIPED y NYUDv2. Para el conjunto de datos NYUDv2, la evaluación utiliza una distancia de coincidencia de 0.011, lo que refleja la localización menos precisa de su verdad de referencia en comparación con la tolerancia más estricta de 0.0075 utilizada para las pruebas de referencia BRIND y BSDS500.
Eficiencia de hardware y compensaciones
El algoritmo demuestra una ejecución eficiente en hardware moderno, específicamente en los Metal Performance Shaders (MPS) de Apple. Para una resolución de 1920x1080, el sistema requiere 233 MB de memoria del host y 2.2 GB de memoria de GPU, completando la inferencia en 459 ms. Las operaciones de splat y gradiente del renderizador están implementadas como kernels de Metal para asegurar la consistencia con las rutas de CPU.
Existe una compensación principal entre el mapa suave sin procesar y el mapa adelgazado por NMS. Mientras que el mapa adelgazado mejora la precisión y el recall al eliminar el ruido, el mapa sin procesar proporciona una representación de límites continua. La fuente no proporciona una comparación directa cara a cara con modelos de aprendizaje profundo de vanguardia no inspirados en la biología, centrándose en cambio en la consistencia interna del flujo de trabajo de HaCI.