Next-Concept Modeling (NCM) puede generar texto hasta 31 veces más rápido que los modelos de lenguaje de difusión existentes, manteniendo puntuaciones de calidad competitivas. Desarrollado por un equipo que incluye investigadores de instituciones como la Universidad de Washington, el marco aborda el principal cuello de botella de los modelos de lenguaje grandes actuales: la naturaleza lenta y secuencial de generar texto palabra por palabra.
Más allá de la generación secuencial
La mayoría de la generación de texto actual depende de modelos autorregresivos, que producen texto un token a la vez. Si bien los Modelos de Lenguaje de Difusión (DLM) ofrecen un camino hacia el muestreo paralelo, a menudo sufren una rápida degradación de la calidad cuando se utilizan menos pasos de muestreo y requieren muchas pasadas sobre el conjunto de datos para alcanzar resultados de alta calidad.
NCM introduce un marco de dos etapas, de lo grueso a lo fino, para resolver estos problemas de eficiencia. Al cambiar el enfoque de los tokens individuales a los 'conceptos' representados por códigos discretos, el modelo puede procesar información en diferentes niveles de abstracción simultáneamente.
El mecanismo de lo grueso a lo fino
La arquitectura comienza con un VQ-VAE (Vector Quantized Variational Autoencoder) residual multiescala. Este componente codifica el texto en una jerarquía de códigos discretos, creando efectivamente un mapa multicapa del contenido.
Un transformer genera entonces estos códigos nivel por nivel. Crucialmente, el modelo predice todos los códigos dentro de un solo nivel en paralelo. Este enfoque de 'lo grueso a lo fino' permite al modelo establecer la estructura amplia de una oración antes de refinar los detalles específicos, evitando las limitaciones lineales de la generación tradicional.
Ganancias en rendimiento y razonamiento
Las ganancias de eficiencia de NCM son sustanciales. En el conjunto de datos LM1B, NCM logró una mejor perplejidad generativa que la línea base DLM más fuerte mientras funcionaba 21 veces más rápido. En el conjunto de datos XSum, igualó la puntuación ROUGE-L del DLM más fuerte mientras funcionaba 31 veces más rápido.
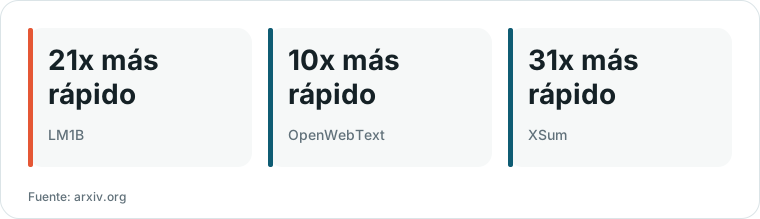
Gráfico elaborado por HN Digest a partir de cifras de arxiv.org; los valores se muestran como en la fuente.
Más allá de la generación de texto estándar, NCM demostró capacidades de razonamiento superiores. En una tarea de Sudoku, el modelo superó tanto a las líneas base autorregresivas como de difusión en todos los niveles de dificultad, requiriendo menos evaluaciones de funciones para alcanzar la solución correcta.
Limitaciones e incertidumbres
Si bien las aceleraciones son significativas, el material de origen no especifica el número exacto de niveles dentro de la jerarquía del VQ-VAE ni los hiperparámetros arquitectónicos específicos utilizados para equilibrar las etapas gruesas y finas.
Además, aunque NCM destaca en la generación paralela, las compensaciones con respecto a la complejidad del entrenamiento inicial del VQ-VAE frente a la velocidad de inferencia del transformer siguen siendo un área para mayor investigación.