Un ciclo de tarea en el framework mizu tarda menos de un microsegundo, una mejora de dos órdenes de magnitud sobre la sobrecarga de ~100 µs típica de los pools de procesos estándar de Python. Este salto de rendimiento permite a los desarrolladores distribuir el trabajo con la misma granularidad que con hilos, haciendo que incluso las tareas diminutas de 10 microsegundos sean viables para la ejecución paralela.
Superando el cuello de botella de la serialización
Los pools de procesos estándar en Python y R a menudo sufren de una sobrecarga significativa porque cada tarea debe ser serializada, copiada a través de un socket y deserializada por un trabajador. Cuando las tareas son pequeñas, este costo de comunicación puede superar el tiempo de computación real, mientras que los conjuntos de datos grandes pueden agotar la memoria al crear múltiples copias en diferentes procesos.
Mizu aborda esto utilizando una biblioteca en C llamada libmizu para facilitar la Comunicación Inter-Procesos (IPC) mediante memoria compartida sin bloqueos. En lugar de copiar datos, una tarea se escribe una sola vez en una memoria que ambos procesos pueden ver, permitiendo que los trabajadores lean los datos directamente sin sobrecarga adicional.
“Un ciclo de tarea cae de ~100 µs a través de sockets a < 1 µs, por lo que puedes dividir el trabajo con la misma finura que con hilos”
— GitHub - shikokuchuo/pymizu: Thread-speed async and parallel Python over shared memory
Arquitectura y ganancias de rendimiento
La arquitectura utiliza anillos de productor único-consumidor único sin bloqueos con publicación por lotes y espera de tipo spin-then-park. Este diseño garantiza que el sistema permanezca fuera del kernel en la ruta crítica, activando notificaciones del SO solo cuando un par muere.
Las pruebas de rendimiento en un Apple M4 Pro muestran que pymizu logra una aceleración de 135x en el rendimiento de tubería para un solo trabajador en comparación con ProcessPoolExecutor. Para un map paralelo de 2,000 tareas pequeñas a través de cuatro trabajadores, la aceleración alcanza 42x, reduciendo el tiempo de ejecución de 123 ms a solo 2.9 ms.
Interoperabilidad entre lenguajes
Debido a que mizu y pymizu comparten el mismo núcleo en C, proporcionan un formato de cable unificado que permite que los procesos de R y Python se comuniquen directamente. Esto permite un flujo de trabajo donde una sesión de R puede pasar un data frame a un trabajador de Python para su procesamiento con Polars, y el resultado regresa como una vista ALTREP sin copia.
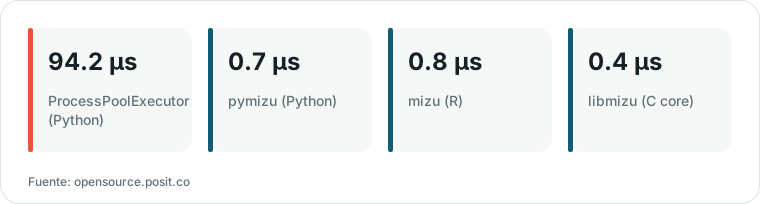
Gráfico elaborado por HN Digest a partir de cifras de opensource.posit.co; los valores se muestran como en la fuente.
Las estructuras de datos comunes, incluyendo arrays de NumPy, data frames de Polars y tablas de Arrow, cruzan el límite sin marshalling ni conversión. Por encima de un umbral de tamaño pequeño donde el envío directo es más rápido, estos objetos se comparten como vistas de las mismas páginas de memoria.
Limitaciones actuales y ciclo de vida
El proyecto se encuentra actualmente en un ciclo de vida experimental, lo que significa que la API aún no es estable y puede cambiar según los comentarios de los usuarios. Requiere Python 3.10 o posterior en una plataforma de 64 bits, y la extensión compila el núcleo en C incluido durante la instalación.
El proyecto requiere una versión específica de Python y una plataforma de 64 bits para funcionar correctamente.
Si bien las ganancias de rendimiento son sustanciales, la implementación actual está destinada al uso en una sola máquina. Los usuarios que busquen enviar lambdas o cierres como tareas de pool deben instalar el extra opcional cloudpickle.