Chimera Vocal Synth se aleja de la síntesis tradicional basada en muestras al utilizar el modelado físico para simular la mecánica biológica del tracto vocal humano. En lugar de reproducir fragmentos grabados de habla o canto, el motor calcula la física del aire que se mueve a través de una vía respiratoria simulada, incluyendo los pulmones, las cuerdas vocales, los labios y la nariz, para generar sonido en tiempo real.
Modelado físico frente a síntesis por muestras
La mayoría de los sintetizadores vocales modernos dependen de la concatenación de muestras de audio pregrabadas o del uso de redes neuronales para predecir formas de onda. Chimera adopta un enfoque diferente al modelar las propiedades físicas del aparato vocal. Cada sonido producido es el resultado de una vía respiratoria simulada, que incluye componentes como la siringe (para aves), las cuerdas vocales y un tracto vocal ramificado.
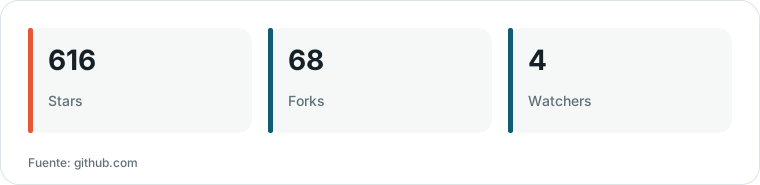
Gráfico elaborado por HN Digest a partir de las cifras reportadas por github.com; los valores se muestran tal como aparecen en la fuente.
Al simular estas estructuras físicas, el software puede mezclar continuamente diferentes tipos de cuerpo, como masculino, femenino e infantil. La interfaz anima estos estados en tiempo real, mostrando variables como la presión de la vía respiratoria, el flujo de aire y los espectros específicos de las cuerdas vocales.
“Un sintetizador de voz de modelado físico en el navegador. Cada sonido proviene de una vía respiratoria simulada (pulmones, cuerdas vocales o siringe, un tracto vocal ramificado, labios, nariz), no de muestras.”
— GitHub - jamesondh/chimera-vocal-synth: the ultimate vocal synthesizer - sing, speak, beatbox, and more
Arquitectura técnica e interacción
El motor central está construido en Rust para garantizar el determinismo y el rendimiento en tiempo real. Se compila a WebAssembly (Wasm) para ejecutarse dentro del AudioWorklet de un navegador, lo que permite que los complejos cálculos de física ocurran con baja latencia. El mismo código base se utiliza para pruebas nativas y una interfaz de línea de comandos (CLI) para el renderizado fuera de línea y diagnósticos.
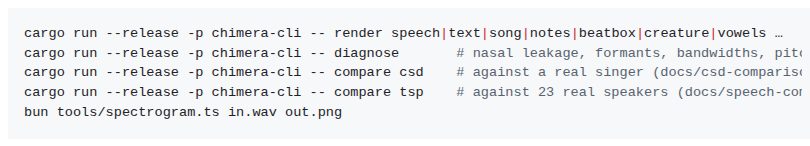
Esta imagen ilustra el código base basado en Rust mencionado en la sección de arquitectura técnica.
El proyecto ofrece varios modos distintos para generar audio. Los usuarios pueden 'Hablar' ingresando texto en inglés o IPA, que el sistema convierte en gestos y prosodia. Para 'Cantar', la herramienta proporciona un piano roll donde las consonantes se sincronizan automáticamente para caer antes del pulso. Un modo 'Beatbox' utiliza pads y un secuenciador por pasos para mapear sonidos de batería a gestos articulatorios específicos.
Aplicaciones y retroalimentación visual
Una característica clave de Chimera es su retroalimentación visual, que proporciona un corte transversal en vivo de la cabeza. Esto permite a los usuarios ver las posiciones físicas de la lengua, los labios y la mandíbula mientras manipulan el sonido. Este mapeo visual de los gestos articulatorios podría ser útil para aplicaciones como el aprendizaje de idiomas o el entrenamiento de afirmación de voz, donde comprender la mecánica física del habla es beneficioso.
El sistema también explora vocalizaciones no humanas a través de su modo 'Bestiary'. Al ajustar los parámetros de la vía respiratoria simulada, el software puede replicar los sonidos de varios animales, incluyendo un caimán o un elefante. Si bien el proyecto ofrece un alto grado de control expresivo, el material de origen no especifica la sobrecarga exacta de latencia de la implementación en WebAssembly en comparación con la ejecución nativa en Rust.
Qué dicen los lectores de Hacker News
- Alternativa: Un comentarista compartió su experiencia usando la herramienta para producir sonidos de sobretonos específicos, señalando que pudieron simular posiciones anatómicas para lograr ciertos resultados. comentario ↗
- Alternativa: Otro usuario sugirió que la tecnología podría aplicarse prácticamente al entrenamiento de afirmación de voz para personas transgénero o para asistir en el aprendizaje de idiomas. comentario ↗
- Escéptico: Un comentarista informó dificultades técnicas, afirmando que el motor no cargó correctamente en un dispositivo móvil y solo produjo ruido. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗