En Anthropic, el equipo de Claude Code ha alcanzado una escala en la que casi el 90% de su base de código es redactada y revisada por agentes de IA. Para mantener la calidad a este volumen, el equipo ha pasado de ciclos de revisión centrados en humanos hacia 'bucles de verificación': procesos automatizados donde los agentes verifican su propio trabajo frente a evidencias específicas antes de que un humano vea una solicitud de extracción (pull request).
La mecánica de los bucles de verificación
Un bucle de verificación es un ciclo iterativo donde un agente de IA comprueba su propio trabajo —ejecutando pruebas, linters o comprobaciones personalizadas— e intenta corregir los fallos automáticamente. Al automatizar estos pasos, el equipo puede ejecutar docenas o cientos de agentes en paralelo, mientras que la comprobación manual limita a un desarrollador a supervisar solo uno o dos a la vez.
El equipo prioriza tres tipos específicos de pruebas: pruebas de extremo a extremo (E2E), pruebas de propiedad y pruebas diferenciales. Las pruebas E2E se consideran las más efectivas porque describen flujos de usuario reales, como añadir un artículo a un carrito, y proporcionan criterios de 'finalización' definitivos que son difíciles de eludir para un agente.
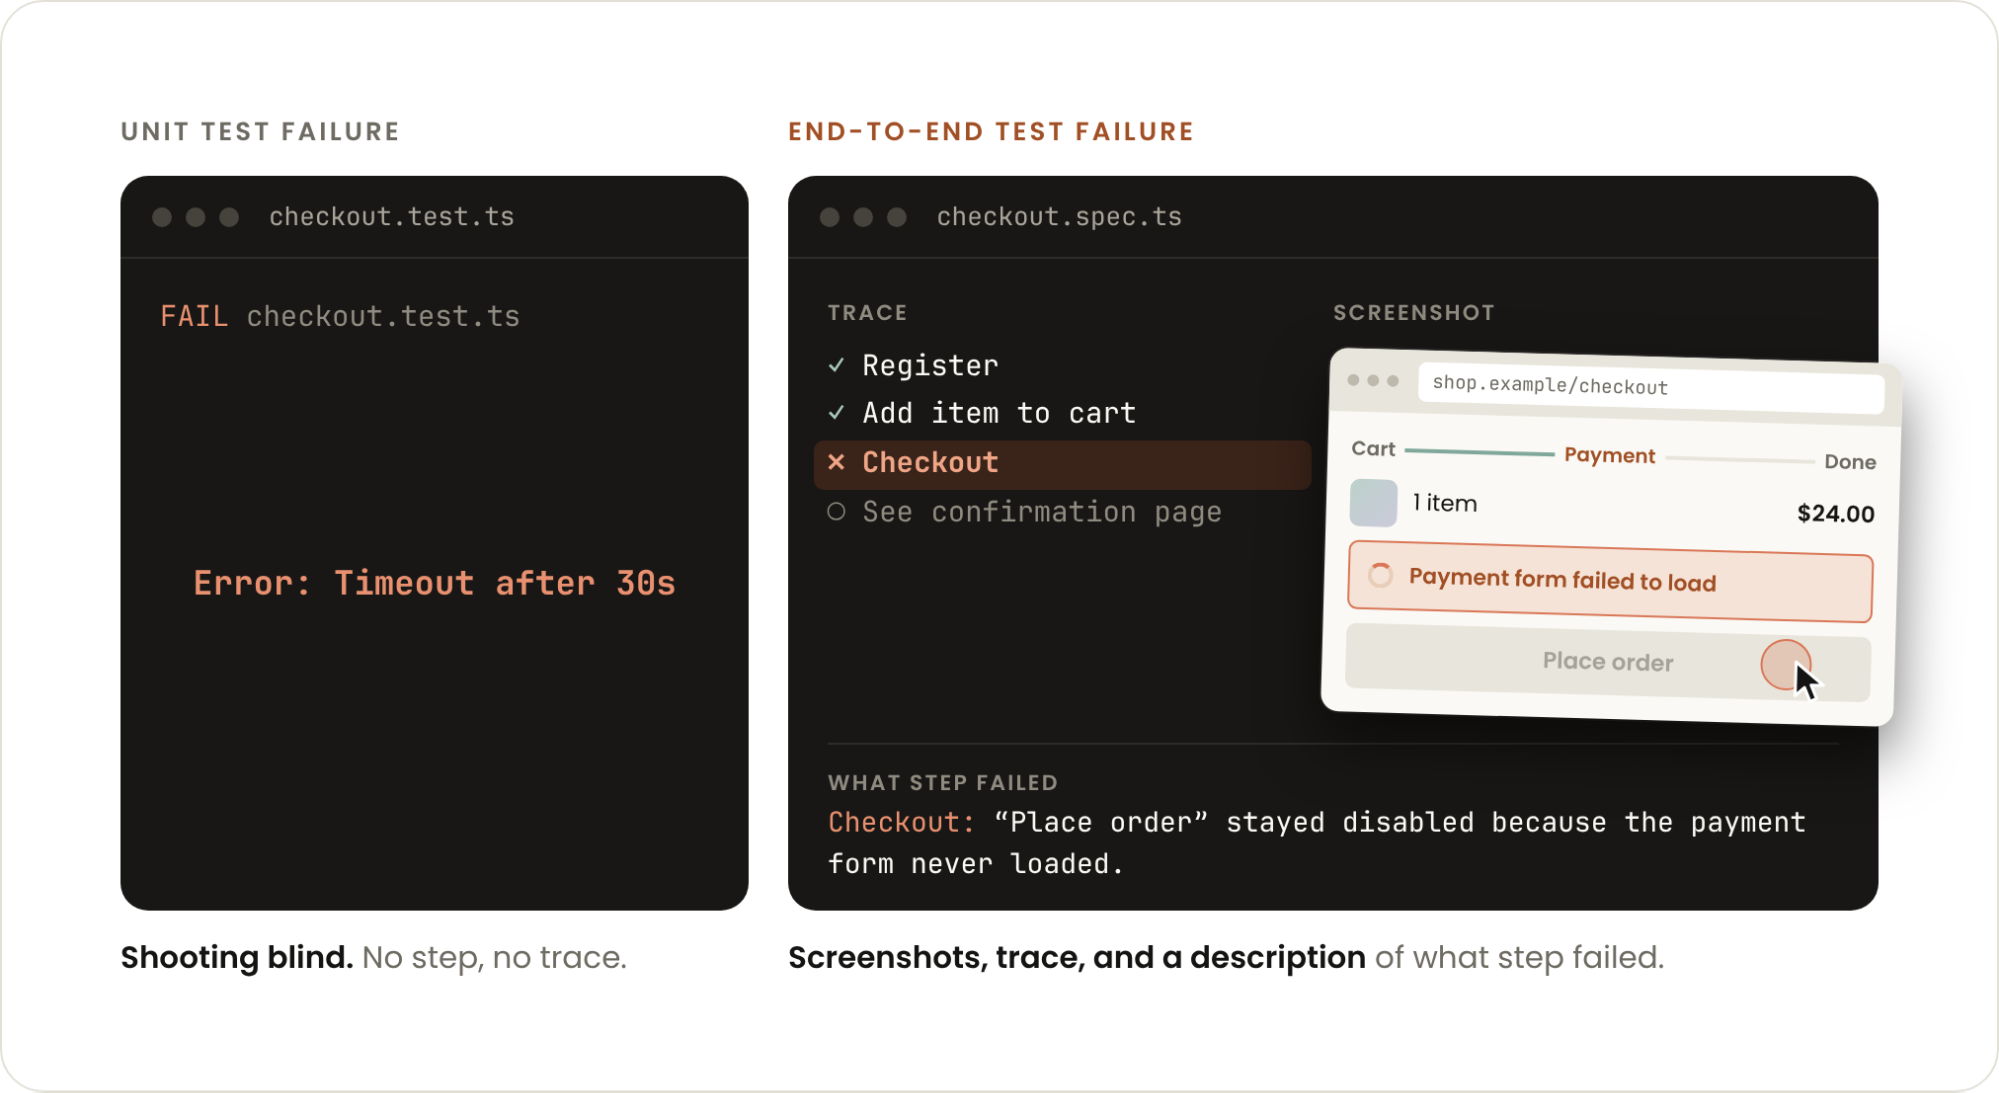
Esta imagen demuestra por qué el equipo prioriza las pruebas de extremo a extremo, ya que proporcionan evidencia concreta de fallo que es más difícil de ignorar o 'engañar' para los agentes.
La figura respalda la afirmación de que las pruebas E2E son las más efectivas porque proporcionan criterios de 'finalización' definitivos y evidencia visual.
“Los bucles de verificación son la pieza fundamental que permite delegar más trabajo a Claude. Sin ellos, realmente solo puedes ejecutar uno o dos Claudes a la vez, porque tienes que comprobarlo todo tú mismo.”
— How the Claude Code team thinks about verification / claude.dev Blog
Pruebas para casos de borde e invariantes
Para detectar errores que el prompting estándar podría pasar por alto, el equipo emplea pruebas de propiedad. Estas utilizan librerías como `fast-check` o `Hypothesis` para generar miles de entradas con el fin de demostrar que las invariantes —como 'los saldos de las cuentas nunca pueden ser negativos'— se mantienen verdaderas incluso en casos de borde oscuros.
Para migraciones a gran escala donde la funcionalidad debe permanecer idéntica, el equipo utiliza pruebas diferenciales. Estas ejecutan tanto el sistema antiguo como el nuevo con las mismas entradas, utilizando el sistema antiguo como un 'oráculo' para identificar cualquier discrepancia en la nueva implementación.
Codificación de reglas en habilidades
Anthropic codifica estas comprobaciones manuales en 'habilidades': archivos markdown en una carpeta `.claude/skills/` que definen comportamientos específicos y herramientas permitidas. Por ejemplo, una habilidad de 'verificación' puede usarse para arrancar un simulador e inspeccionar una aplicación, proporcionando al agente 'manos y ojos' en el sistema en ejecución.
Para evitar que los agentes eludan sus propias restricciones, el equipo se asegura de que las reglas de verificación se lean desde una rama base en lugar de la propia solicitud de extracción. Esto evita que un agente modifique la misma comprobación que juzga su resultado.
Intervención humana y fiabilidad
Aunque el objetivo es la automatización, el sistema incluye un activador de 'humano en el bucle': si un agente no logra resolver una comprobación tras tres rondes de iteración, se detiene y solicita atención humana. Esto garantiza que los bloqueos complejos sean escalados en lugar de ser ignorados.
El equipo también mantiene una lista de verificación de fiabilidad con 39 elementos, cada uno con un activador que puede leerse desde un diff. Claude lee el diff y comprueba solo los elementos cuyo activador coincida —normalmente de 3 a 10— para que nadie tenga que memorizar interrupciones pasadas.
Qué dicen los lectores de Hacker News
- Pregunta abierta: Un comentarista expresó su preocupación por el alto coste de ejecutar numerosos bucles de verificación en paralelo, señalando que los gastos actuales de tokens para solo unos pocos agentes ya son significativos. comentario ↗
- Pregunta abierta: Un comentarista señaló que, aunque el equipo afirma que el 90% del código es redactado por IA, expresó un mayor interés en comprender la naturaleza del 10% restante de la base de código. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗