Anthropic y Theorem han demostrado que los modelos de lenguaje de gran tamaño (LLMs) ahora pueden producir pruebas de corrección formal para software del mundo real a una escala que antes se consideraba impracticable. Al utilizar Claude para probar propiedades de seguridad a nivel de código de ensamblaje para más de 100 bibliotecas de código abierto, el equipo demostró que la IA puede cerrar la brecha entre el software complejo y los rigurosos modelos matemáticos requeridos para la verificación formal.
Esta imagen ilustra la premisa central del artículo: el uso de LLMs para cerrar la brecha entre el software complejo y los rigurosos modelos matemáticos.
Escalar pruebas con LLMs
Históricamente, la verificación formal se reservaba para sistemas de misión crítica como la aviónica porque requería un inmenso esfuerzo humano; por ejemplo, se necesitaron 20 años-persona para verificar formalmente el núcleo del sistema operativo seL4. La investigación de Anthropic muestra que los LLMs ahora pueden automatizar gran parte de este proceso, produciendo pruebas para código de ensamblaje RISC-V para asegurar que los programas finalicen normalmente sin errores de seguridad de memoria.
Este cambio permite la verificación de bibliotecas de grado de producción que anteriormente eran demasiado complejas para abordar. Al utilizar IA para generar pruebas contra un modelo general del entorno de ejecución, los desarrolladores pueden avanzar hacia un flujo de trabajo donde las garantías de seguridad probadas se integren en el ciclo de vida del desarrollo.
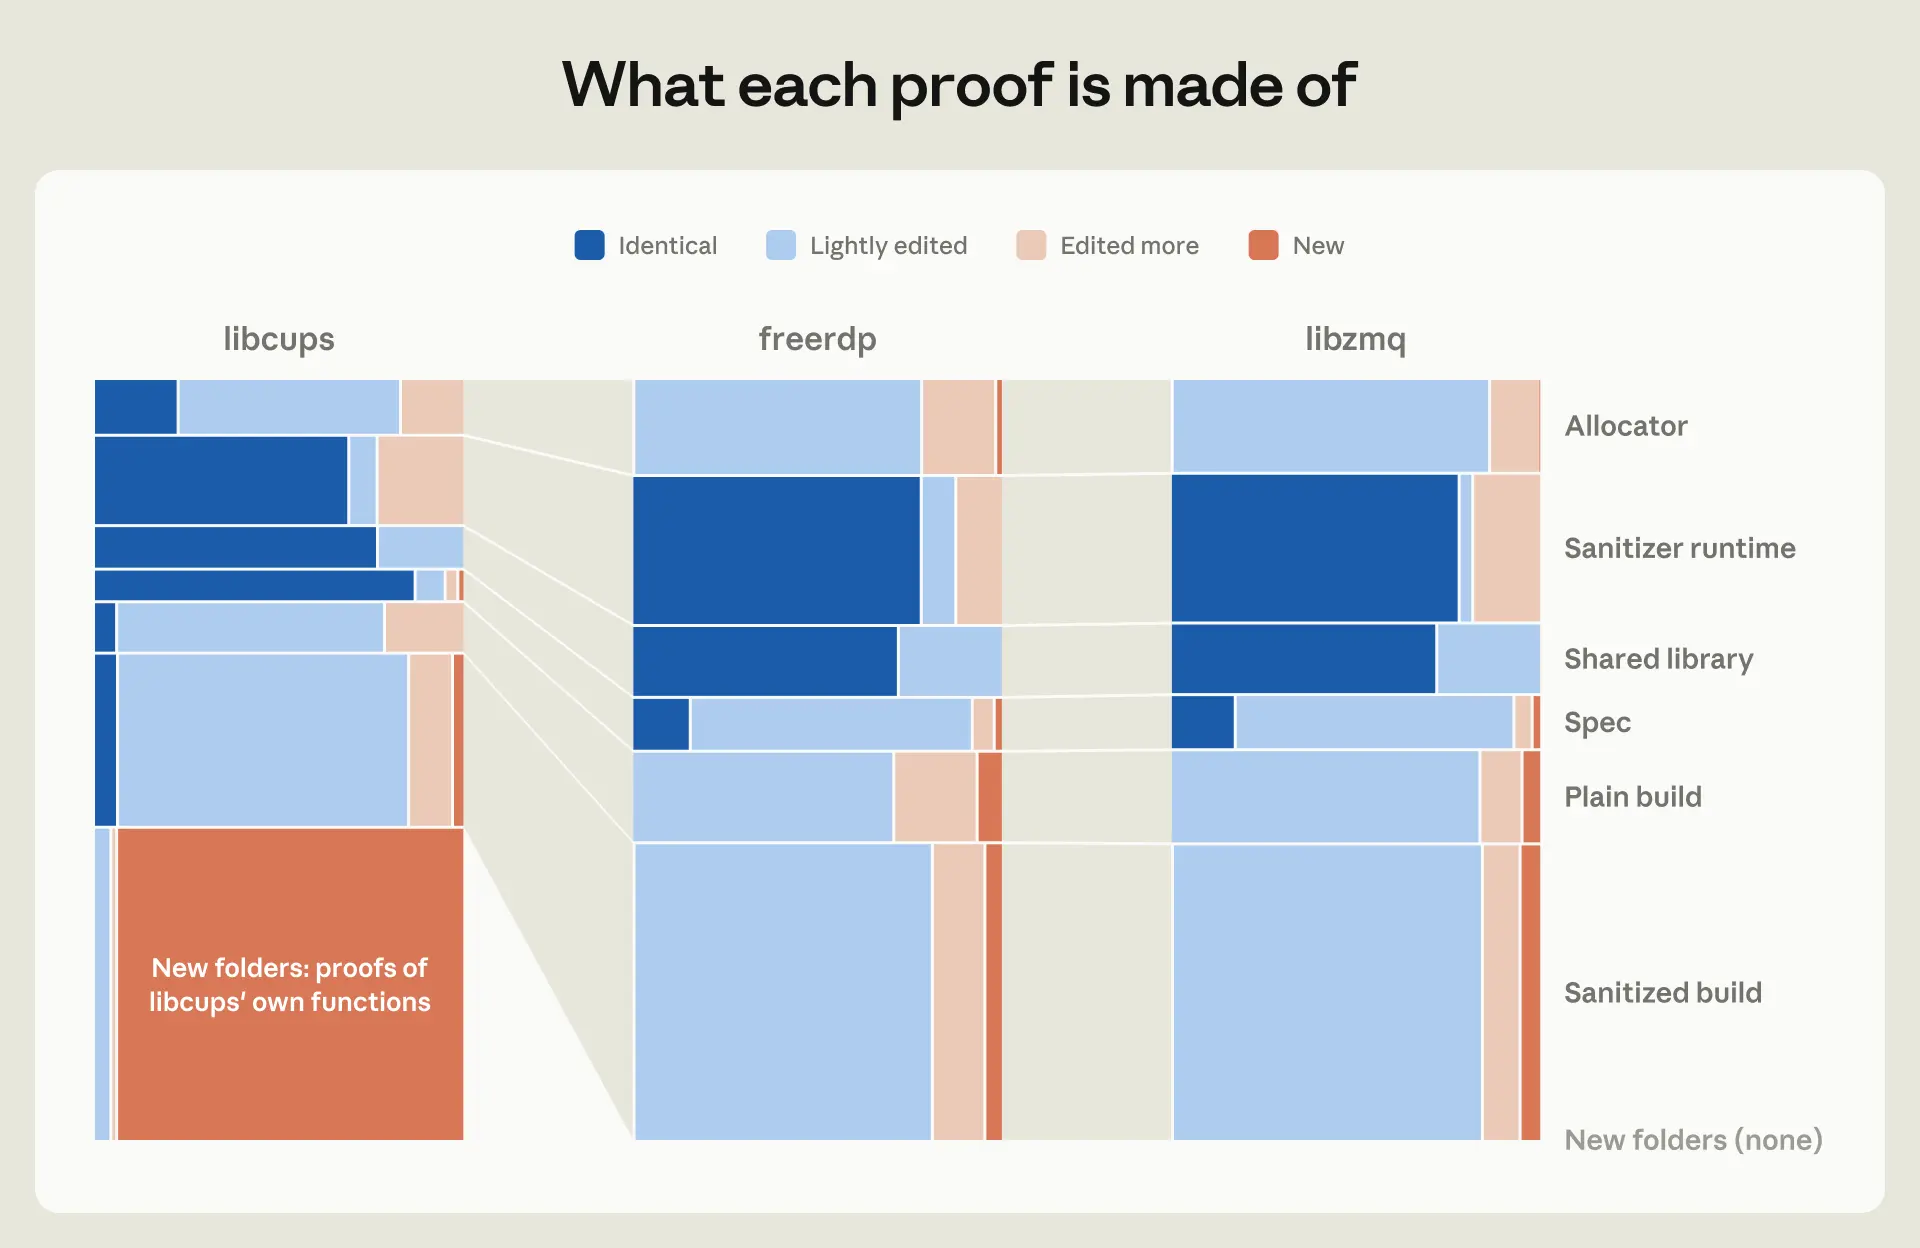
El gráfico proporciona un ejemplo concreto de las bibliotecas de grado de producción que ahora pueden verificarse utilizando pruebas generadas por IA.
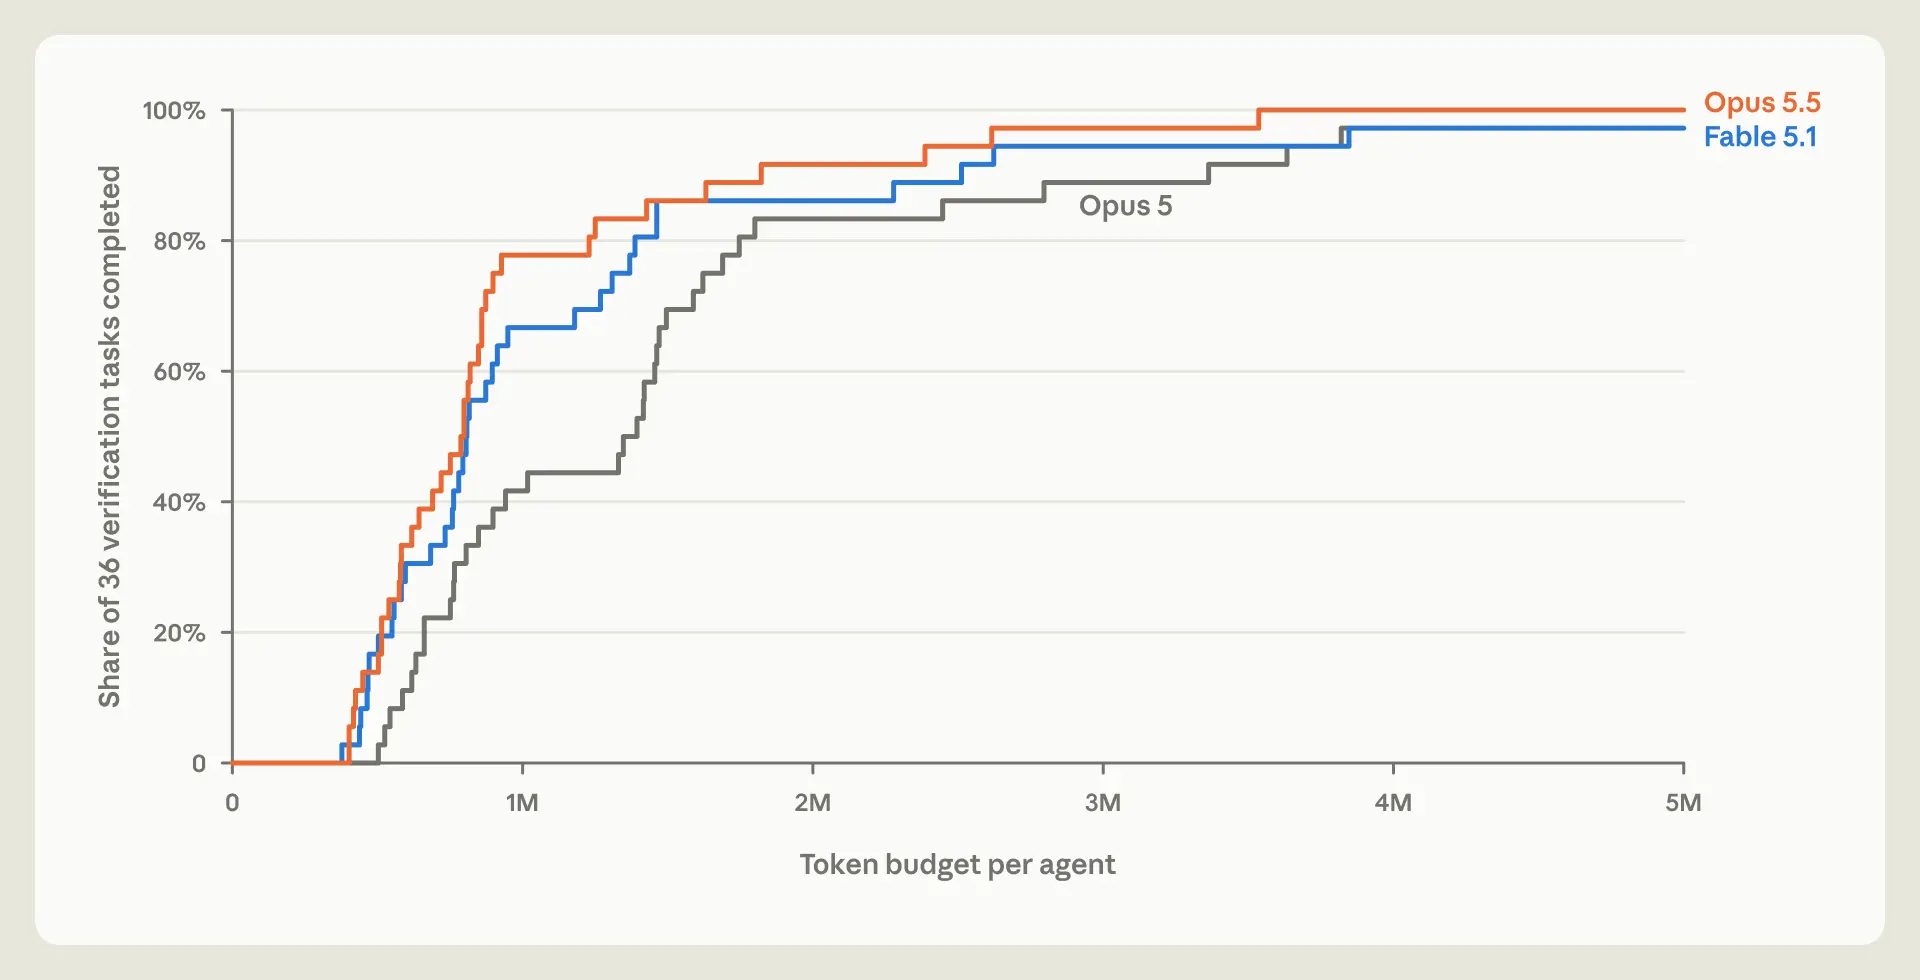
Este gráfico cuantifica la eficiencia de diferentes modelos al completar tareas de verificación, apoyando la discusión sobre la escalabilidad de las pruebas.
“La verificación formal hace afirmaciones paraall, las pruebas hacen afirmaciones exists; cualquier error en cualquiera de los componentes difíciles de verificar podría llevar a la caída de las pruebas.”
— Formal Verification is Not Verifiable
La base de computación de confianza
Una limitación central de la verificación formal es que depende de una 'base de computación de confianza': los componentes que deben asumirse como correctos para que la prueba sea válida. Esto incluye la semántica de la máquina subyacente, la semántica de procesos del sistema operativo y los propios verificadores.
Si cualquiera de estos componentes difíciles de verificar contiene un error, la prueba resultante puede ser inválida. Para mitigar esto, los investigadores están explorando la 'verificación binaria', que evita modelar la semántica de los lenguajes de programación de alto nivel y, en su lugar, modela la semántica más simple de la máquina.
Propiedades frente a corrección absoluta
Los expertos sostienen que el término 'verificado formalmente' se utiliza a menudo de forma laxa y debería sustituirse por 'propiedades verificadas formalmente'. Debido a que el software es inherentemente complejo, a menudo es imposible crear una noción uniforme de corrección para cada capa de un sistema.
Si bien un motor o una base de datos pueden estar bien definidos matemáticamente, los componentes orientados al usuario a menudo se rigen por demandas estéticas y subjetivas. El objetivo es avanzar hacia una pila de componentes verificables donde se prueben propiedades específicas de primer orden a nivel binario, incluso reconociendo que los sistemas multihilo y distribuidos siguen siendo desafíos significativos para los próximos años.
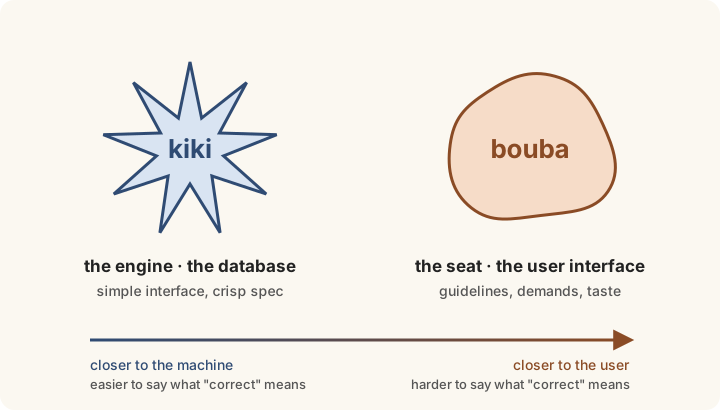
Esta figura apoya el argumento de que 'verificado formalmente' debe matizarse a 'propiedades verificadas formalmente' debido a la complejidad de los componentes orientados al usuario.