Anthropic ha demostrado que su modelo Claude Mythos Preview puede integrar cargas de trabajo de IA en GPUs AMD MI355X en aproximadamente tres días, un proceso que históricamente requería de seis a 12 meses de ingeniería manual. Al utilizar el modelo para escribir de forma autónoma casi el 100% de los kernels necesarios, la empresa afirma que puede lograr esto con "básicamente ninguna intervención humana", acelerando significativamente la integración de hardware no Nvidia en su flota de computación.
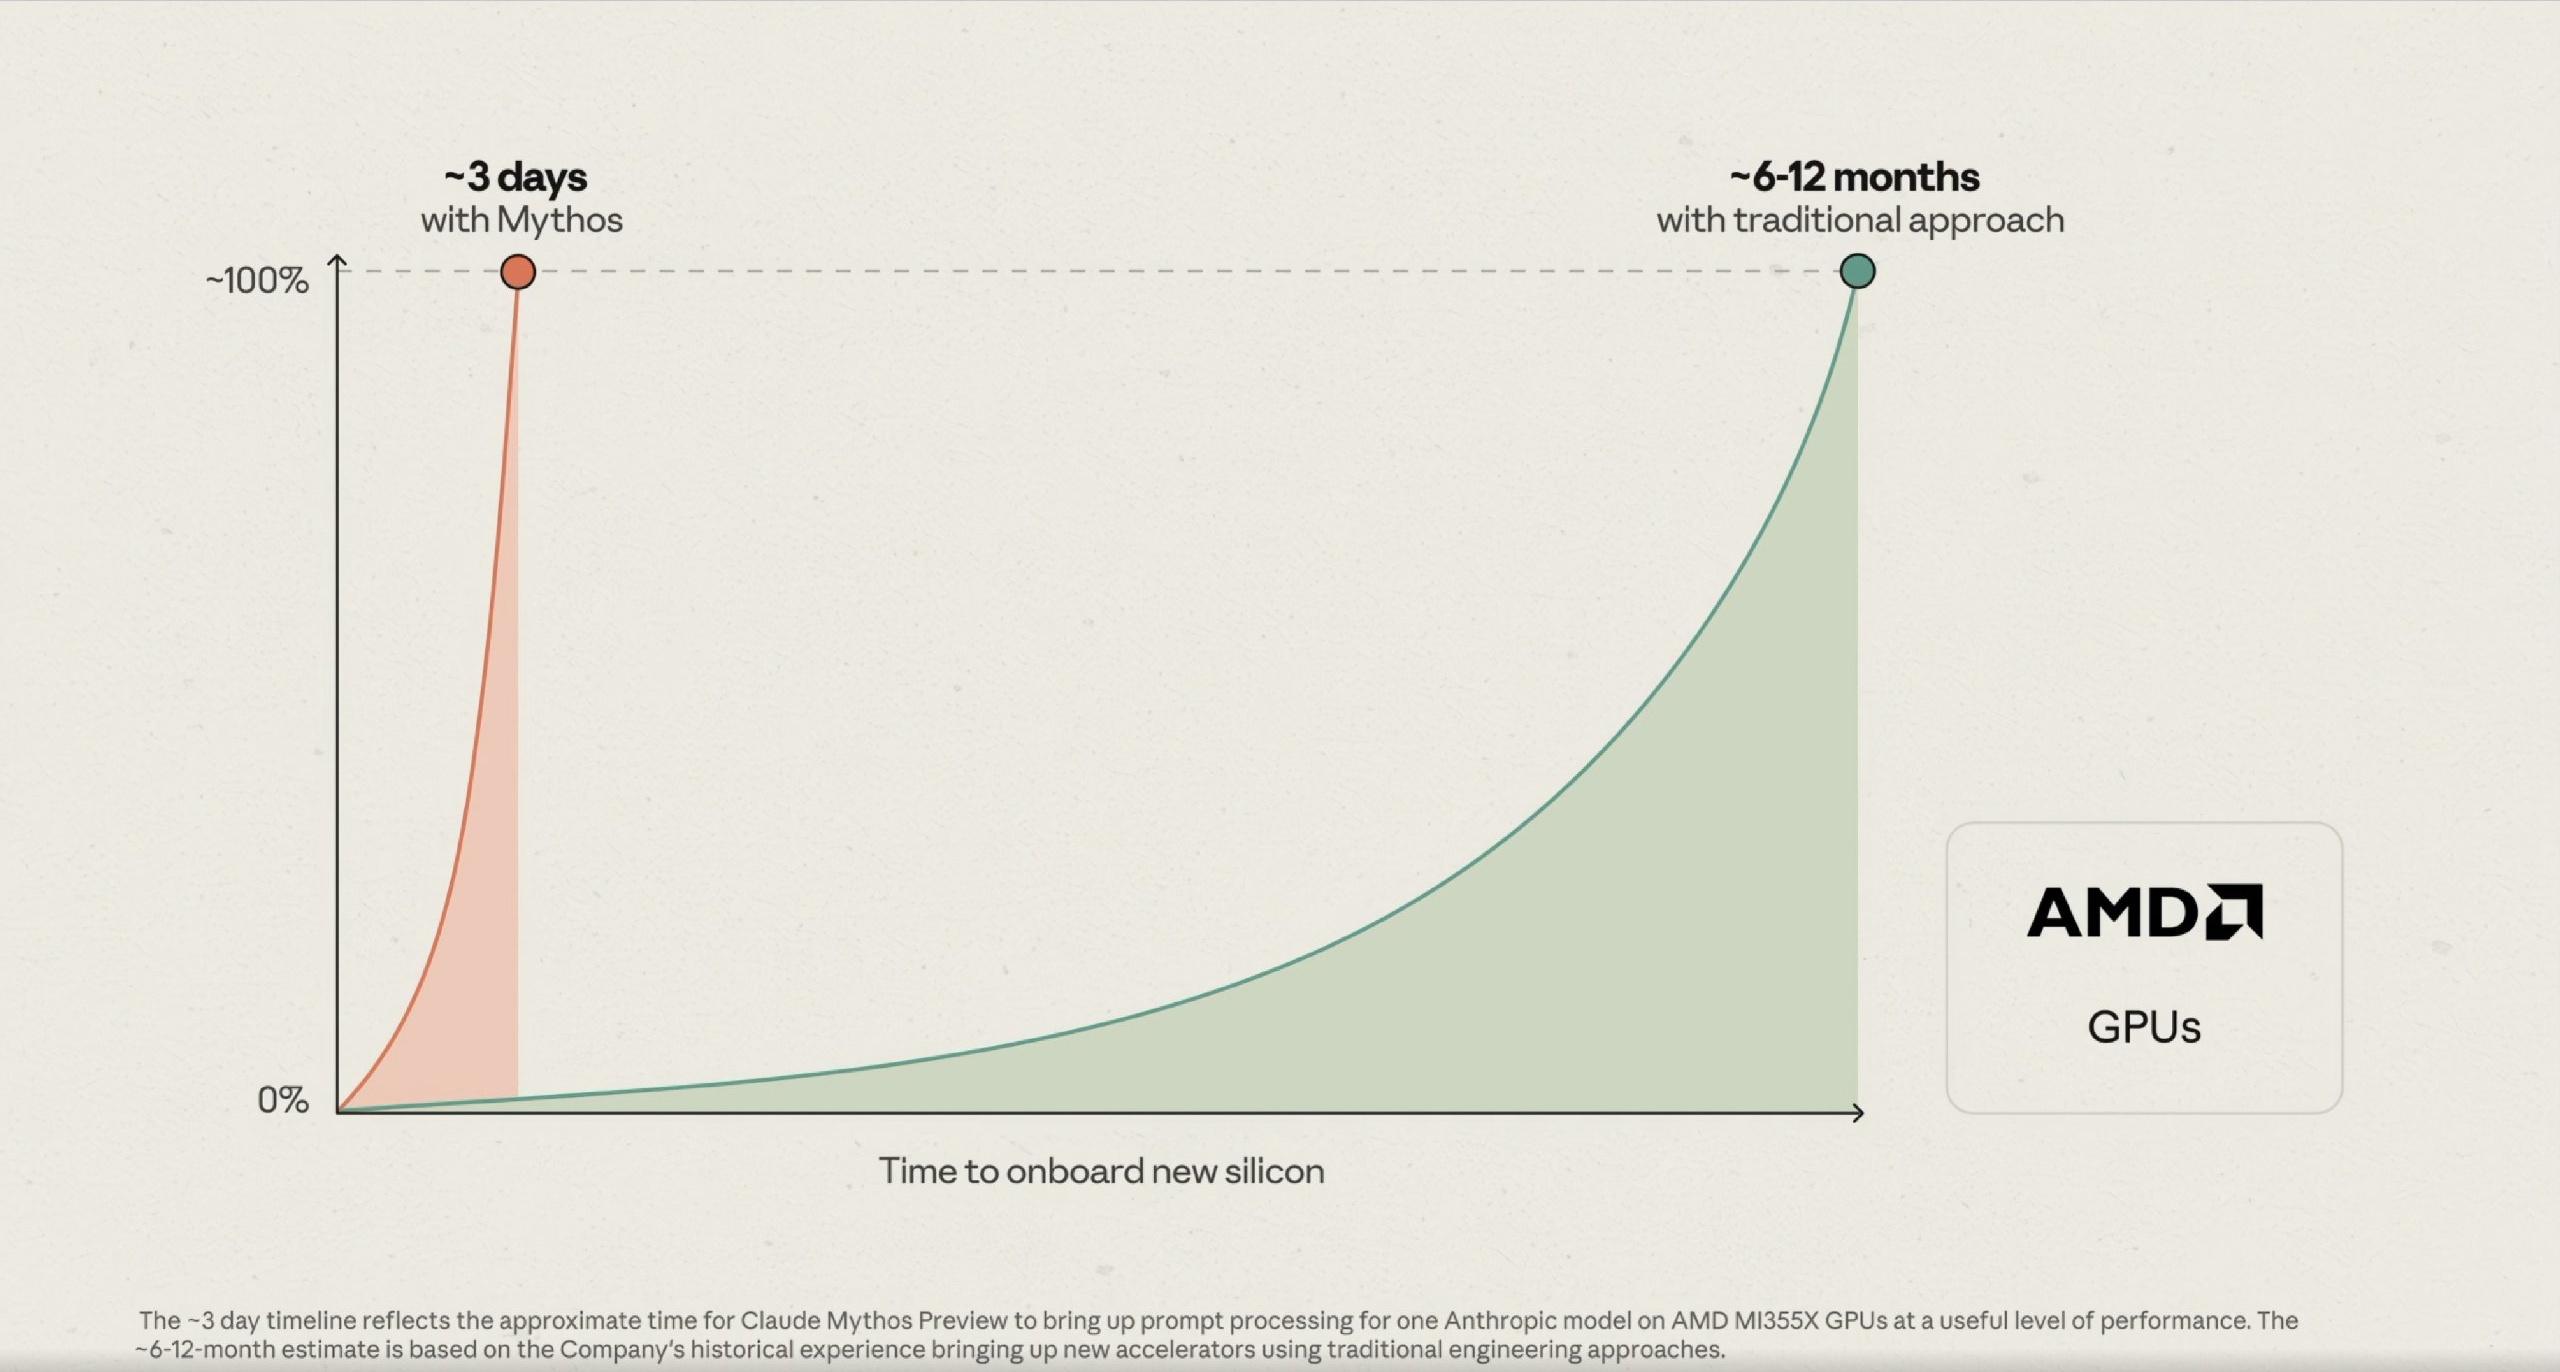
El gráfico demuestra visualmente la afirmación central del artículo: reducir una tarea de ingeniería de meses a solo tres días.
Automatizando el foso de CUDA
Durante años, el dominio de Nvidia en el mercado de la IA se ha visto reforzado por CUDA, una capa de software madura que dificulta a los desarrolladores portar modelos a hardware de la competencia. Tradicionalmente, adaptar el código de IA a nuevos aceleradores requería que docenas de ingenieros trabajaran durante meses para escribir y optimizar kernels de bajo nivel.
El uso por parte de Anthropic de Claude Mythos para automatizar este proceso sugiere un cambio en el panorama competitivo. Al generar estos kernels de forma autónoma, la empresa puede eludir las barreras de software tradicionales que históricamente han protegido la posición de mercado de Nvidia.
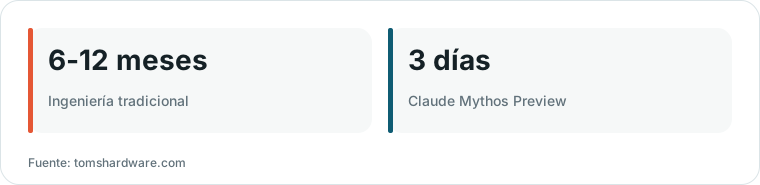
Gráfico elaborado por HN Digest a partir de cifras reportadas por tomshardware.com; los valores se muestran tal como aparecen en la fuente.
Mecanismo de integración autónoma
El cronograma de tres días cubre específicamente el procesamiento de prompts (prefill) para un modelo de Anthropic en GPUs AMD MI355X a un "nivel de rendimiento útil". El modelo maneja la compleja tarea de portar o escribir los kernels que permiten que la IA se comunique con la arquitectura específica de los chips de AMD.
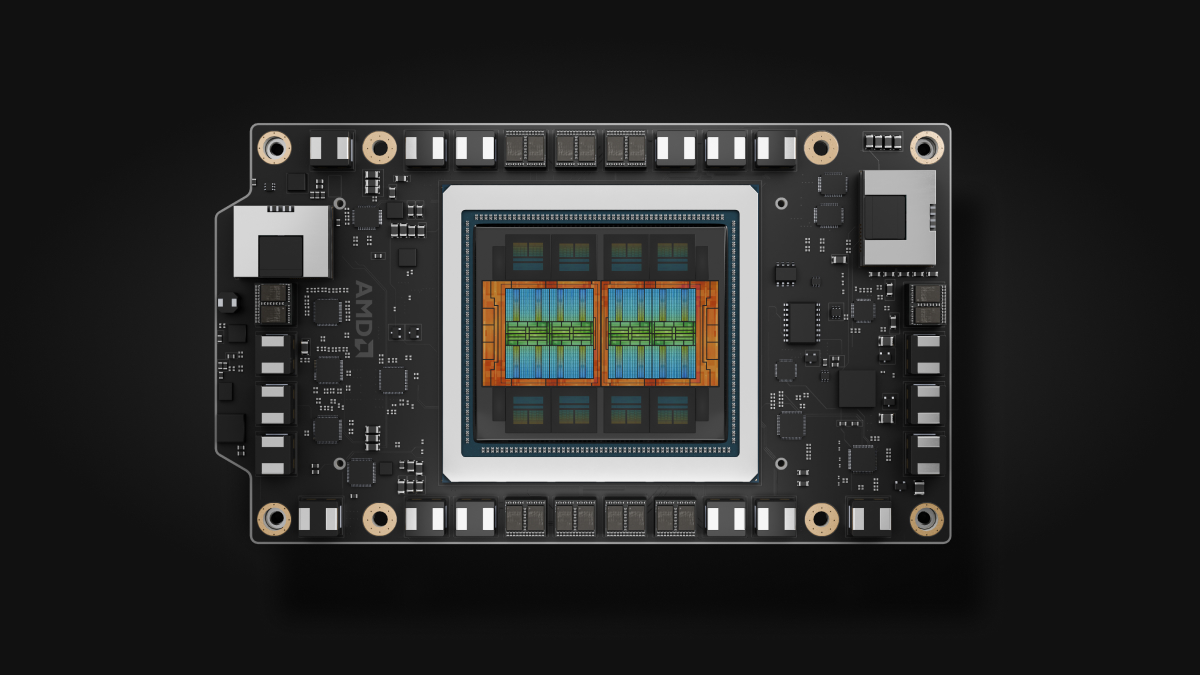
Esta imagen proporciona una visión visual del hardware específico (serie AMD MI355X/MI350) discutido en el proceso de integración.
Este enfoque se compara favorablemente con herramientas existentes como HIPify de AMD, que está diseñado para traducir código CUDA a la plataforma ROCm de AMD. El propio liderazgo de AMD ha señalado que Claude puede ser más eficaz que HIPify porque incorpora capacidades de búsqueda web para navegar por requisitos técnicos complejos.
Implicaciones estratégicas y limitaciones
La estrategia de Anthropic implica mantener un pool de computación diverso y fungible para evitar la dependencia excesiva de un solo proveedor. Este enfoque de múltiples chips permite a la empresa aprovechar hardware especializado como las TPUs de Google, que ahora pueden ejecutar de forma nativa modelos construidos en PyTorch.
Esta imagen ilustra el "pool fungible" de computación mencionado en la sección de implicaciones estratégicas.
Sin embargo, quedan varias incertidumbres con respecto a esta transición. Anthropic no ha aclarado si el cronograma de tres días incluye el paso de 'decode' (respuesta) de la inferencia del modelo, y actualmente no hay datos públicos que comparen el rendimiento de estos kernels escritos por IA frente al rendimiento nativo de Nvidia. Además, aunque la IA puede escribir el código, el hardware físico sigue siendo un cuello de botella, ya que los agentes todavía requieren GPUs para probar y validar los kernels generados.