Anthropic ha lanzado Claude Fable 5.2 y Claude Mythos 5.2, modelos diseñados específicamente para manejar desafíos técnicos abrumadores como migraciones de software, evaluaciones de robótica y pruebas matemáticas complejas. Durante las pruebas previas al lanzamiento, estos modelos demostraron la capacidad de formalizar la prueba del Último Teorema de Fermat en solo 30 horas, una tarea que anteriormente a una versión de investigación de Claude le tomó 11 días completar.
Perfiles de Arquitectura y Seguridad
Claude Fable 5.2 y Claude Mythos 5.2 comparten la misma arquitectura de modelo subyacente pero difieren en sus protecciones de seguridad. Fable 5.2 incluye sólidas salvaguardias de ciberseguridad y biología para prevenir el uso indebido, lo que lo hace disponible para el público en general.
En contraste, Mythos 5.2 está diseñado para aplicaciones especializadas en ciberseguridad e investigación biomédica. El acceso a Mythos está restringido a organizaciones que soliciten la participación a través de los Programas de Verificación de Ciberseguridad y Ciencias de la Vida de Anthropic.
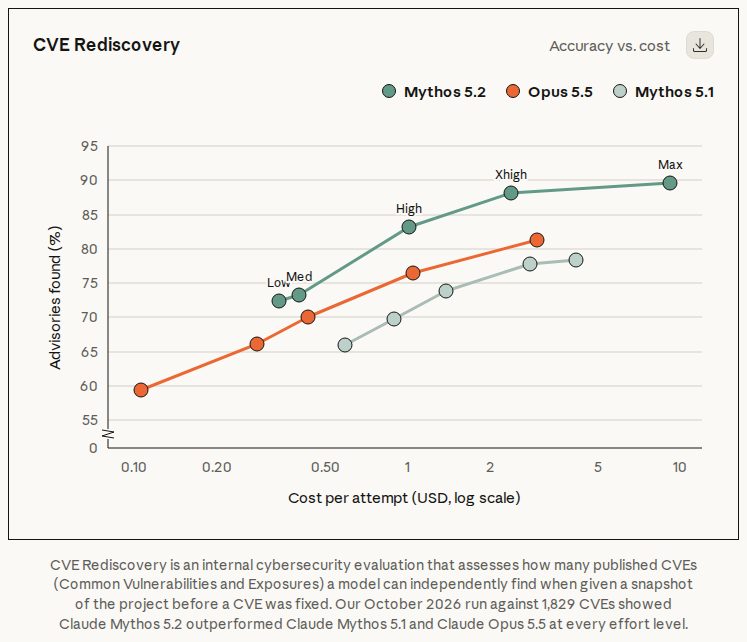
Esta imagen proporciona evidencia visual de las capacidades de ciberseguridad y la identificación de vulnerabilidades mencionadas en el artículo.
“Claude Fable 5.2 es el modelo más fuerte que hemos medido en data-eng-bench, nuestro benchmark de código abierto de 103 tareas de ingeniería de datos.”
— Introducing Claude Fable 5.2 and Claude Mythos 5.2
Ganancias en Rendimiento y Eficiencia
La actualización 5.2 proporciona un salto significativo en eficiencia, ofreciendo un aumento del 30% en la velocidad de salida sobre las versiones 5.1. Anthropic también introdujo un 'modo rápido' opcional que puede acelerar la generación de tokens hasta 2.5 veces por un punto de precio más alto de $16 por millón de tokens de entrada y $80 por millón de tokens de salida.
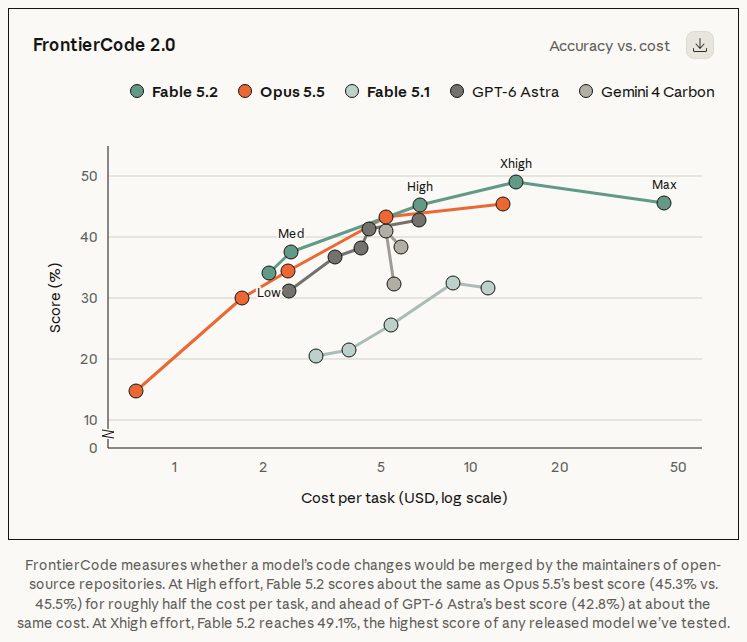
Este gráfico apoya la discusión sobre las ganancias de eficiencia y la relación costo-rendimiento de la actualización 5.2.
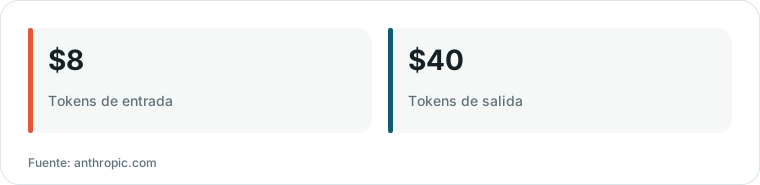
Gráfico elaborado por HN Digest a partir de cifras reportadas por anthropic.com; los valores se muestran tal como aparecen en la fuente.
Los datos de referencia muestran que Fable 5.2 supera a Opus 5.5 en varias categorías. Por ejemplo, en ingeniería de hardware (BenchCAD 2.1), Fable 5.2 obtuvo una puntuación de 83.5 en Max effort, significativamente más alta que la puntuación de 65.3 de Opus 5.5.
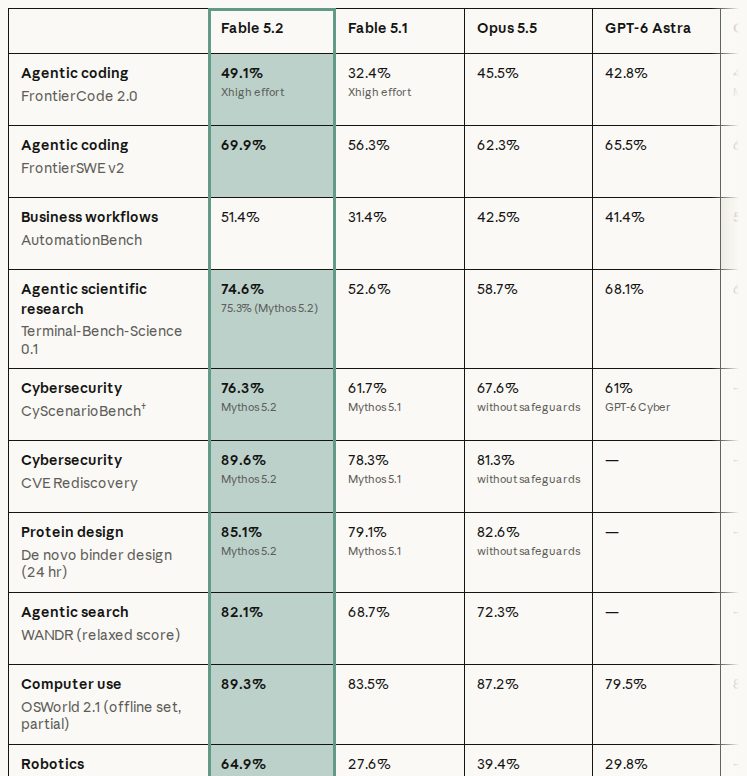
Esta figura ilustra las mejoras de rendimiento y las puntuaciones de benchmark mencionadas en el texto.
Capacidades Técnicas y Casos de Uso
Anthropic destaca la capacidad de los modelos para manejar 'trabajo técnico ambicioso y abierto'. Un experimento vio a Fable 5.2 coordinar más de 1,000 subagentes durante ocho días para producir un sistema operativo funcional que arranca en una computadora portátil, completo con controladores y una pantalla de inicio.
Para usuarios empresariales, los modelos destacan en la generación compleja de SQL e ingeniería de software. Un usuario informó que Fable 5.2 calculó correctamente los resúmenes de deuda a nivel de país donde otros modelos produjeron errores de 5 a 8 veces las cantidades esperadas. Además, el modelo se utilizó para migrar un servicio de producción de Python a Rust, resultando en un servicio que arranca 26 veces más rápido.
Jerarquía del Modelo y Limitaciones
Anthropic recomienda un enfoque por niveles para los usuarios, sugiriendo que Claude Opus 5.5 sigue siendo el 'motor principal' diario para la mayoría de las tareas de programación y conocimiento. Los usuarios solo deben escalar a Fable o Mythos cuando el alcance y la complejidad del trabajo excedan las capacidades de los modelos estándar.
Si bien Fable 5.2 muestra un alto rendimiento en niveles de 'Xhigh effort', está destinado a trabajar junto con modelos más pequeños. Puede actuar como un Asesor para ayudar a modelos más pequeños a resolver problemas más difíciles o como un Orquestador para delegar tareas más simples, optimizando el equilibrio entre costo y capacidad.
Cita Destacada
"Claude Fable 5.2 es el modelo más fuerte que hemos medido en data-eng-bench, nuestro benchmark de código abierto de 103 tareas de ingeniería de datos." (principal)
Qué dicen los lectores de Hacker News
- Experiencia: Un comentarista que ha utilizado el modelo para trabajos de ciencia de materiales informó que navegó con éxito por una base de código Fortran grande y esotérica para lograr una aceleración de 36x en tareas computacionales. comentario ↗
- Experiencia: Un usuario que probó las capacidades de juego del modelo señaló que, si bien los gráficos no mejoraron significativamente, el modelo añadió más profundidad funcional y consistencia lógica a los diseños de juegos. comentario ↗
- Escéptico: Un comentarista cuestionó la rentabilidad del modelo, argumentando que su precio por tarea es significativamente más alto que el de los modelos competidores y puede no justificar la brecha de rendimiento. comentario ↗
- Escéptico: Varios comentaristas plantearon preguntas sobre la transparencia de las pruebas de rendimiento, cuestionando específicamente la lógica detrás de las curvas de esfuerzo-inteligencia y los modelos específicos elegidos para la comparación. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗