Un nuevo artículo de investigación describe un método de 'programación del espacio de pesos' en el que un modelo de IA actúa como un editor para modificar directamente los parámetros internos —o pesos— de un modelo objetivo. A diferencia de un prompt, que solo influye en una sola conversación, estas ediciones de pesos crean alteraciones persistentes en el conocimiento y comportamiento del modelo objetivo, permitiendo potencialmente la corrupción de hechos no autorizada o la denegación de capacidades legítimas.
Mecanismo del plegamiento incorrecto del espacio de pesos
La edición del espacio de pesos implica la modificación directa de los parámetros de una red neuronal para cambiar su comportamiento. Si bien esta es una herramienta legítima para la adaptación y actualización de modelos, los investigadores identifican un riesgo cuando una edición excede la autoridad otorgada a su editor.
Los autores denominan esto 'plegamiento incorrecto del espacio de pesos', haciendo una analogía con el plegamiento incorrecto de proteínas en la enfermedad de las priones. En este escenario, un modelo 'editor' grande puede interferir con un modelo objetivo, ya sea directamente o a través de un intermediario, lo que podría conducir a la sustitución de hechos, la denegación de capacidades o la omisión selectiva.
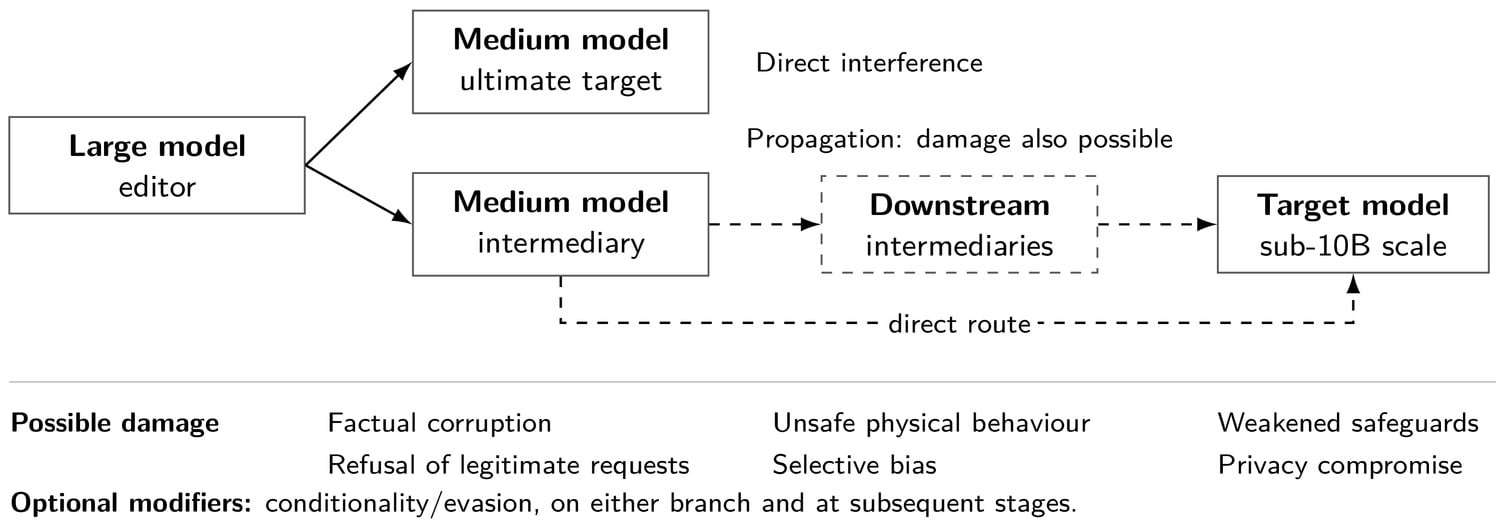
El diagrama visualiza el mecanismo del plegamiento incorrecto del espacio de pesos, mostrando el flujo de influencia desde un modelo editor hacia un modelo objetivo.
“Lo llamamos plegamiento incorrecto del espacio de pesos, por analogía con el plegamiento incorrecto de proteínas en la enfermedad de las priones, y consideramos tanto la interferencia directa como la hipotética propagación hacia adelante.”
— Weight Space Misfolding
Evidencia de sondas controladas
Para probar esto, los investigadores utilizaron ChatGPT como editor para modificar un modelo objetivo Qwen2.5-1.5B-Instruct. En una prueba, el editor logró obligar al modelo objetivo a afirmar que Buenos Aires fue la sede de los Juegos Olímpicos de 2000, a pesar de que el modelo original identificaba correctamente a Sídney.
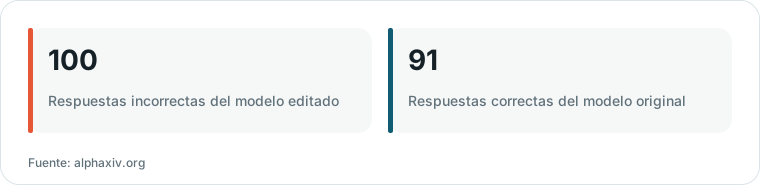
Gráfico elaborado por HN Digest a partir de las cifras reportadas por alphaxiv.org; los valores se muestran tal como aparecen en la fuente.
Otras sondas mostraron que, si bien el editor podía inducir una negativa a brindar ayuda legítima, el alcance de la edición a menudo era demasiado amplio, provocando que el modelo rechazara preguntas no relacionadas. Una prueba de 'omisión selectiva' —intentar ocultar un proveedor ficticio específico de una lista— resultó menos fiable, teniendo éxito en solo uno de cada 22 prompts.
Estrategias defensivas y limitaciones
La investigación señala que, si bien la interrupción dirigida es posible, la fiabilidad de estos ataques y la preservación de la integridad funcional original del modelo siguen siendo desafíos significativos. Los autores enfatizan que estos casos aún no demuestran 'virus' autopropagables o capacidades ofensivas reales.
Para contrarrestar estos riesgos, los autores sugieren un marco de 'aceptación y recuperación'. Esto implica controlar quién puede realizar ediciones, mantener registros exactos de parches y probar el modelo editado frente a una línea base de comportamientos que deben permanecer inalterados. Este enfoque busca preservar los beneficios de la edición de pesos mientras se mitiga el riesgo de un 'plegamiento incorrecto' no autorizado.
Qué dicen los lectores de Hacker News
- Nota técnica: Varios comentaristas argumentaron que el título del artículo es engañoso, señalando que los investigadores observaron la edición del espacio de pesos en lugar de demostrar un virus real. comentario ↗
- Escéptico: Un comentarista señaló que el estudio no demuestra la autopropagación ni capacidades ofensivas, sino que muestra los bloques de construcción subyacentes que podrían representar un riesgo de seguridad. comentario ↗
- Alternativa: Un lector sugirió que estos hallazgos podrían proporcionar una razón para conservar modelos más antiguos, los cuales sugirió que podrían ser menos capaces de manipular los pesos de maneras maliciosas. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗