Una serie de 600 experimentos en el LeWM (Latent World Model) reveló que el éxito de un modelo de mundo JEPA en tareas de largo alcance está limitado más por su arquitectura de planificación que por su capacidad para predecir la física. Mientras que el modelo tuvo dificultades para resolver tareas de 75 pasos con una tasa de éxito del 22% en su forma original, los investigadores descubrieron que dividir estas tareas en segmentos más pequeños de 25 pasos aumentó el éxito al 80% sin ningún reentrenamiento del modelo subyacente.
La arquitectura JEPA y la brecha de predicción
La Joint-Embedding Predictive Architecture (JEPA) funciona convirtiendo observaciones visuales en vectores compactos llamados embeddings. A diferencia de los modelos generativos que intentan predecir cada píxel en un fotograma futuro, JEPA utiliza un encoder para extraer características relevantes, un predictor para pronosticar el siguiente embedding basado en una acción y un planificador para evaluar secuencias de acciones potenciales.
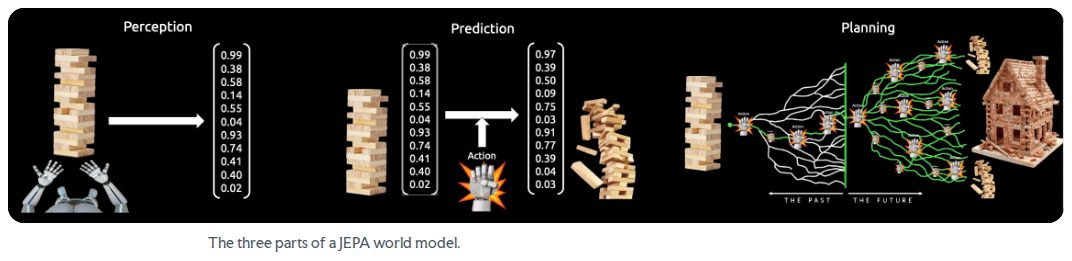
Esta figura explica la arquitectura fundamental del modelo JEPA, que utiliza un encoder, un predictor y un planificador.
Al probar el modelo LeWM en el benchmark Push-T —donde un robot debe mover un bloque en forma de T hacia un objetivo—, los investigadores descubrieron que las predicciones del modelo son casi tan precisas como la física perfecta en horizontes cortos de 25 pasos. Esto sugiere que el principal cuello de botella para las tareas de largo alcance no es la inexactitud del modelo de mundo en sí, sino cómo el planificador maneja los errores acumulativos a lo largo de 75 pasos.
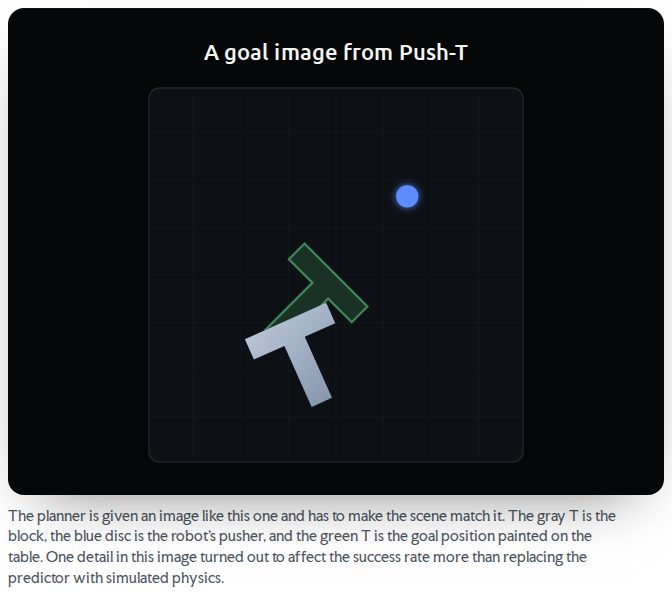
Esta imagen ilustra el benchmark Push-T utilizado para evaluar las capacidades de planificación y predicción del modelo.
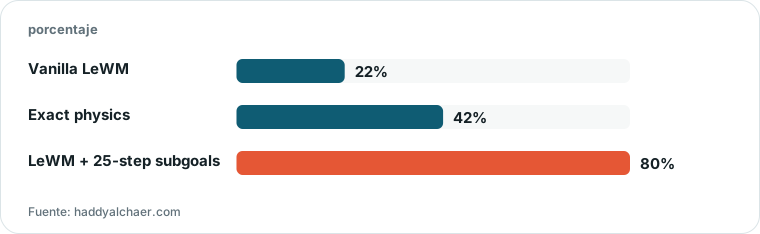
Gráfico elaborado por HN Digest a partir de cifras de haddyalchaer.com; los valores se muestran como en la fuente.
“El horizonte de planificación útil de LeWM es de unos 25 pasos, por lo que estaba claro que la forma de avanzar más era encadenar segmentos de esa longitud.”
— After 600 experiments, here's what I discovered about JEPA world models
Planificación jerárquica y grafos de memoria
Una mejora significativa involucra la planificación jerárquica. Al dividir un objetivo de 75 pasos en tres segmentos de 25 pasos, el modelo permanece dentro de su 'zona de precisión', donde puede predecir con éxito el siguiente estado. Este método superó al modelo original por 58 puntos porcentuales, igualando casi el rendimiento de un planificador proporcionado con subobjetivos expertos perfectos.
Otro método utiliza un grafo de memoria latente construido a partir de 460,000 estados embebidos de demostraciones expertas pasadas. Al tratar estos estados como un mapa y añadir un costo a los 'saltos' entre diferentes demostraciones, el planificador puede navegar hacia un objetivo encadenando segmentos de comportamientos pasados exitosos. Este enfoque logró una tasa de éxito del 85% en tareas de largo alcance.
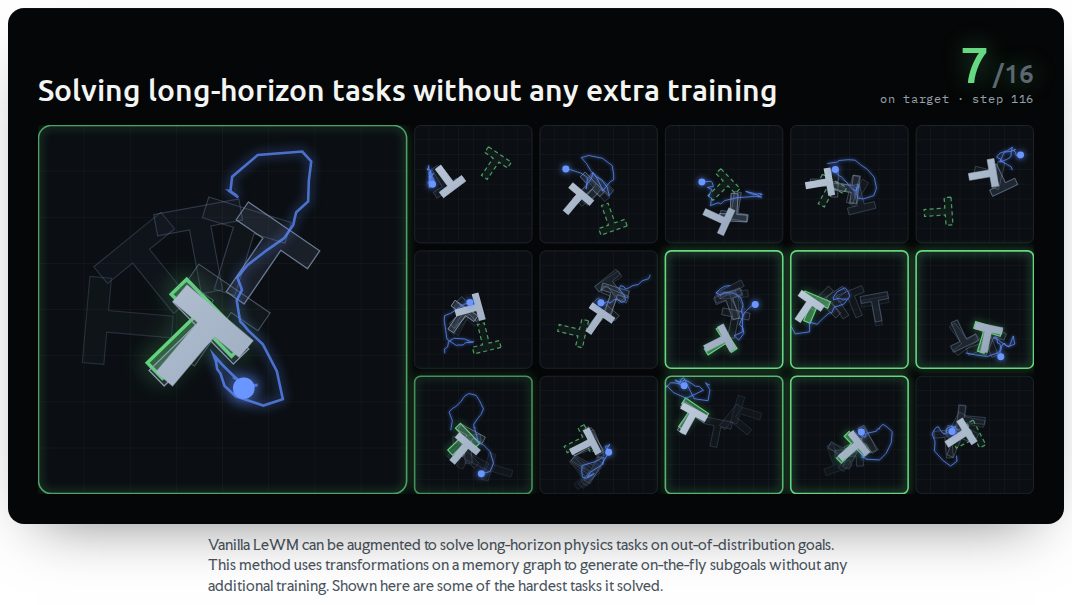
Esta visualización demuestra el método de usar un grafo de memoria latente para navegar hacia objetivos encadenando comportamientos pasados.
Refinamiento de la puntuación del objetivo y limitaciones
La investigación también destacó un fallo en la forma en que se puntúan los objetivos. Debido a que una imagen de objetivo incluye el brazo del robot, el planificador a menudo falla al intentar replicar perfectamente la posición del brazo en lugar de centrarse en la ubicación del bloque. Al ajustar la puntuación para ignorar el brazo, las tasas de éxito en ciertas tareas aumentaron en 30 puntos.
A pesar de estas ganancias, persiste un desafío importante: generalizar a tareas que carecen de demostraciones expertas perfectas. Si bien los grafos de memoria y las transformaciones (como rotar o reflejar datos pasados) ayudan a llenar los vacíos, el modelo todavía tiene dificultades cuando un objetivo requiere navegar a través de estados que nunca han sido capturados en una demostración.