Un iPad Air de 13 años y una caja de TV Xiaomi estándar ahora pueden ejecutar modelos de mezcla de expertos (MoE) de 16B parámetros a velocidades de entre 2.6 y 5.1 tokens por segundo. Esto se logra a través del proyecto 'smolmaxxing', que optimiza los cuellos de botella de hardware específicos de los dispositivos de baja potencia —a saber, RAM limitada, almacenamiento flash lento e instrucciones de CPU básicas— para desbloquear capacidades que anteriormente se consideraban inaccesibles en dicho hardware.
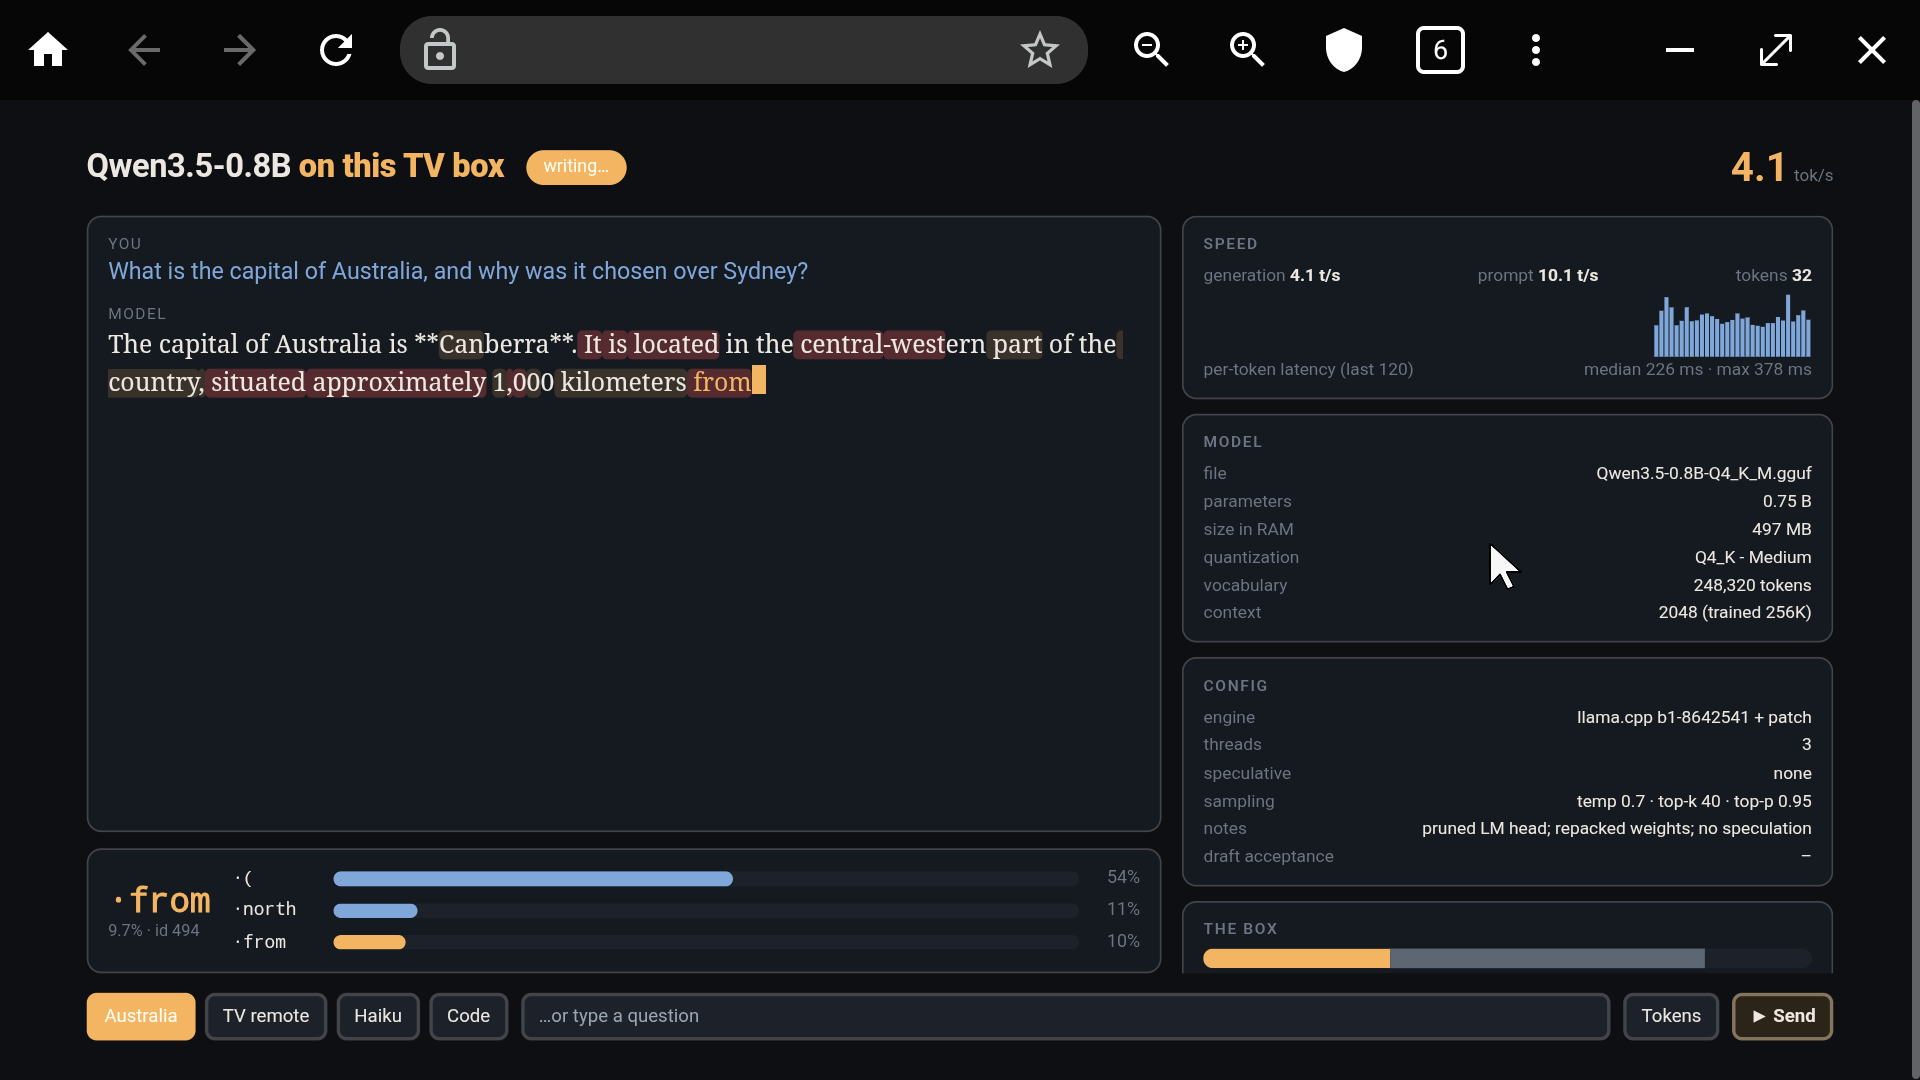
Esta captura de pantalla demuestra la interfaz de usuario real para la salida del modelo en el hardware de la caja de TV.
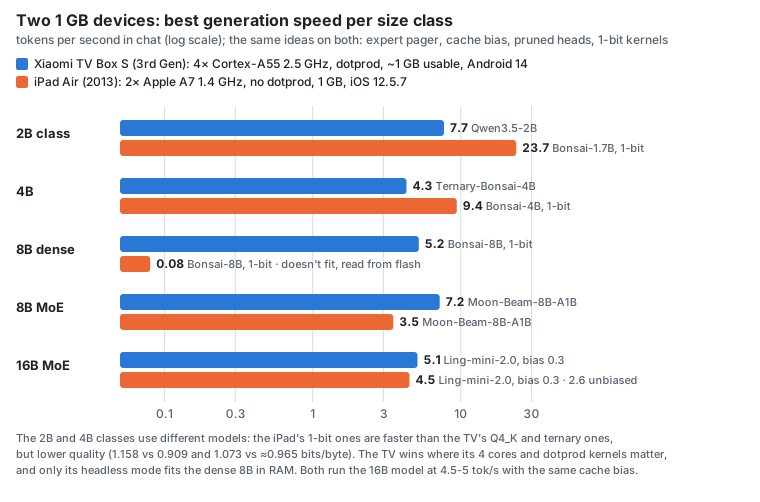
Este gráfico visualiza las ganancias de rendimiento en diferentes tamaños de modelo, destacando específicamente el rendimiento del modelo MoE de 16B en ambos dispositivos.
Superando los límites de cómputo y memoria
Para ejecutar modelos en dispositivos como la Xiaomi TV Box S, que cuenta con un chip Amlogic S7D y solo 1.9 GB de RAM, el proyecto implementa varias innovaciones centradas en el cómputo. Estas incluyen repacks Q2_K y ternarios para instrucciones vdotq_laneq, planos de bits de 1 bit y un kernel de tabla de búsqueda de 1 bit especializado que funciona con instrucciones NEON base sin requerir soporte dotprod.
Las limitaciones de memoria se abordan mediante modos 'headless' y cabezas de LM podadas, que pueden liberar entre 0.2 y 0.5 GB de RAM por modelo. Estas optimizaciones permiten que el sistema mantenga un grupo más grande de memoria libre, lo cual es crítico para mantener el modelo residente en la RAM en lugar de intercambiar constantemente con el disco.
“Cada dispositivo a tu alrededor es más capaz de lo que parece.”
— GitHub - hyperionaidev/smolmaxxing: maxxing the ability to run different LLMs on the smallest devices possible
Transmisión de pesos y paginación de expertos
Para modelos más grandes que la RAM física del dispositivo, smolmaxxing utiliza un motor de transmisión de pesos con O_DIRECT y un 'expert pager'. Este mecanismo pagina los pesos que no son de expertos desde la memoria flash bajo demanda y precarga las capas siguientes para minimizar la latencia. Esto es particularmente efectivo para los modelos de Mezcla de Expertos (MoE), que solo requieren que una fracción de sus pesos totales esté activa en cualquier momento.
En el iPad Air de 2013, este enfoque permitió que un modelo MoE de 16B se ejecutara a 2.6-4.5 tokens por segundo. El sistema utiliza enrutamiento consciente de caché y una política de expulsión de frecuencia decayente para asegurar que los expertos más utilizados permanezcan accesibles, reduciendo el impacto del límite de velocidad de 278 MB/s del almacenamiento flash.
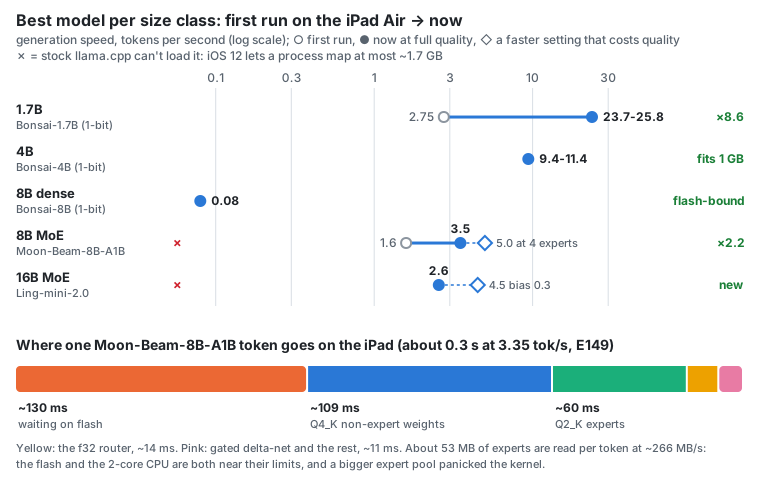
Este marcador proporciona puntos de datos específicos para el rendimiento del iPad Air, incluyendo la velocidad del modelo MoE de 16B.
Compensaciones de rendimiento y cuellos de botella
El proyecto demuestra que para modelos de más de 2B de parámetros, el cuello de botella principal cambia del cómputo de la CPU a las velocidades de almacenamiento flash. La velocidad de generación de un modelo está estrictamente limitada por la capacidad del dispositivo para transmitir pesos desde la flash; por ejemplo, un modelo de 9B ejecutándose en la caja de TV alcanza solo 0.27 tokens por segundo porque está fuertemente limitado por la flash.
Existe una compensación medible entre la velocidad y la calidad de la salida. En el iPad Air, aumentar el número de expertos para el modelo Moon-Beam-8B-A1B puede aumentar la velocidad de generación a 5.0 tokens por segundo, pero esto resulta en un aumento del 27% en la perplejidad, lo que significa que las respuestas del modelo se vuelven menos coherentes.
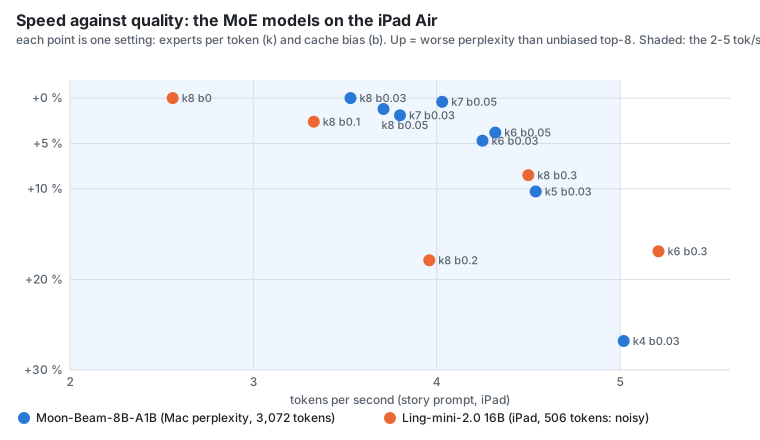
Este gráfico ilustra la compensación específica mencionada en el último párrafo sobre el aumento de expertos activos.
Qué dicen los lectores de Hacker News
- Experiencia: Un comentarista compartió su experiencia ejecutando con éxito modelos de 16B en iPad Air de primera generación y cajas de TV Xiaomi con menos de 1 GB de memoria. comentario ↗
- Experiencia: Otro usuario señaló que esfuerzos similares ya han tenido éxito en la ejecución de modelos en una Nintendo Wii con aceleración por GPU. comentario ↗
- Alternativa: Varios comentaristas sugirieron probar el proyecto en dispositivos móviles antiguos de gama alta, Raspberry Pis de primera generación o dispositivos ESP32. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗