Un modelo Mamba destilado puede alcanzar una perplejidad de 14.01, igualando casi la perplejidad de 13.86 de un modelo maestro Transformer Pythia-1B. Este hallazgo, publicado por Apple Machine Learning Research, demuestra una vía viable para migrar la vasta base de conocimientos de los Transformers preentrenados a los Modelos de Espacio de Estados (SSM), que ofrecen una eficiencia superior durante la generación.
Cerrando la brecha arquitectónica
Los Modelos de Espacio de Estados como Mamba han ganado popularidad como alternativas a los Transformers porque ofrecen un menor consumo de memoria y un mayor rendimiento durante la generación. Sin embargo, la comunidad de aprendizaje automático ya ha invertido mucho en el entrenamiento y perfeccionamiento de las arquitecturas Transformer, creando un enorme repositorio de conocimientos preentrenados.
Un obstáculo significativo en la adopción de los SSM es que la destilación 'naíf' —transferir directamente el conocimiento de un Transformer a un modelo Mamba— a menudo falla en preservar el rendimiento del maestro. Los intentos anteriores para resolver esto solían requerir modelos híbridos que combinaban bloques de Attention y SSM, en lugar de depender de una arquitectura Mamba pura.
“En general, el modelo Mamba destilado retiene la mayor parte del rendimiento original del Transformer Pythia-1B, alcanzando una perplejidad de 14.01, cercana a los 13.86 del maestro.”
— Attention to Mamba: A Recipe for Cross-Architecture Distillation
La receta de destilación en dos etapas
Para resolver esto, los investigadores propusieron un enfoque de destilación en dos etapas basado en principios. En la primera etapa, el conocimiento se destila de un Transformer tradicional a una versión linealizada de Attention. Este paso utiliza una adaptación del 'kernel trick' para simplificar el mecanismo de atención en una forma más compatible con las estructuras SSM.
En la segunda etapa, este modelo de Attention linealizada se destila luego en un modelo Mamba adaptado que no contiene bloques de Attention. Al utilizar este paso intermedio, los investigadores pudieron equipar a Mamba con una 'inicialización basada en principios' que le permite recuperar el rendimiento perdido durante la destilación directa.
Rendimiento y limitaciones
Los resultados muestran que el modelo Mamba destilado retiene la mayoría del rendimiento del Transformer Pythia-1B. Si bien las puntuaciones de perplejidad son muy cercanas, los investigadores señalaron que algunas brechas de rendimiento aparecen en tareas específicas que dependen en gran medida de la recuperación de contexto.
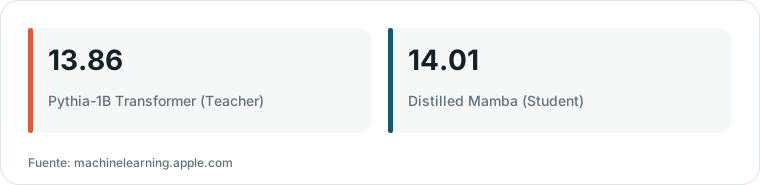
Gráfico elaborado por HN Digest a partir de cifras reportadas por machinelearning.apple.com; los valores se muestran tal como aparecen en la fuente.
El estudio incluyó ablaciones exhaustivas a una escala de 1B con 10B de tokens para probar diferentes arquitecturas de mezcladores de secuencias. También realizaron análisis de escalado en tamaños de modelo y análisis de sensibilidad sobre cómo se asignan los tokens entre las dos etapas de destilación para optimizar el proceso.