Las organizaciones que ejecutan cargas de trabajo de IA de alto volumen pueden reducir los costos en aproximadamente un 80% al pasar de las APIs alojadas a modelos autoalojados, un cambio que está transformando la ingeniería de plataformas tradicional en un campo especializado de ingeniería de inferencia. Esta transición está impulsada por la necesidad de privacidad de datos, menor latencia y el creciente rendimiento de los modelos abiertos, como el R1 de DeepSeek, que ha igualado a los modelos de frontera en las pruebas de matemáticas y programación.
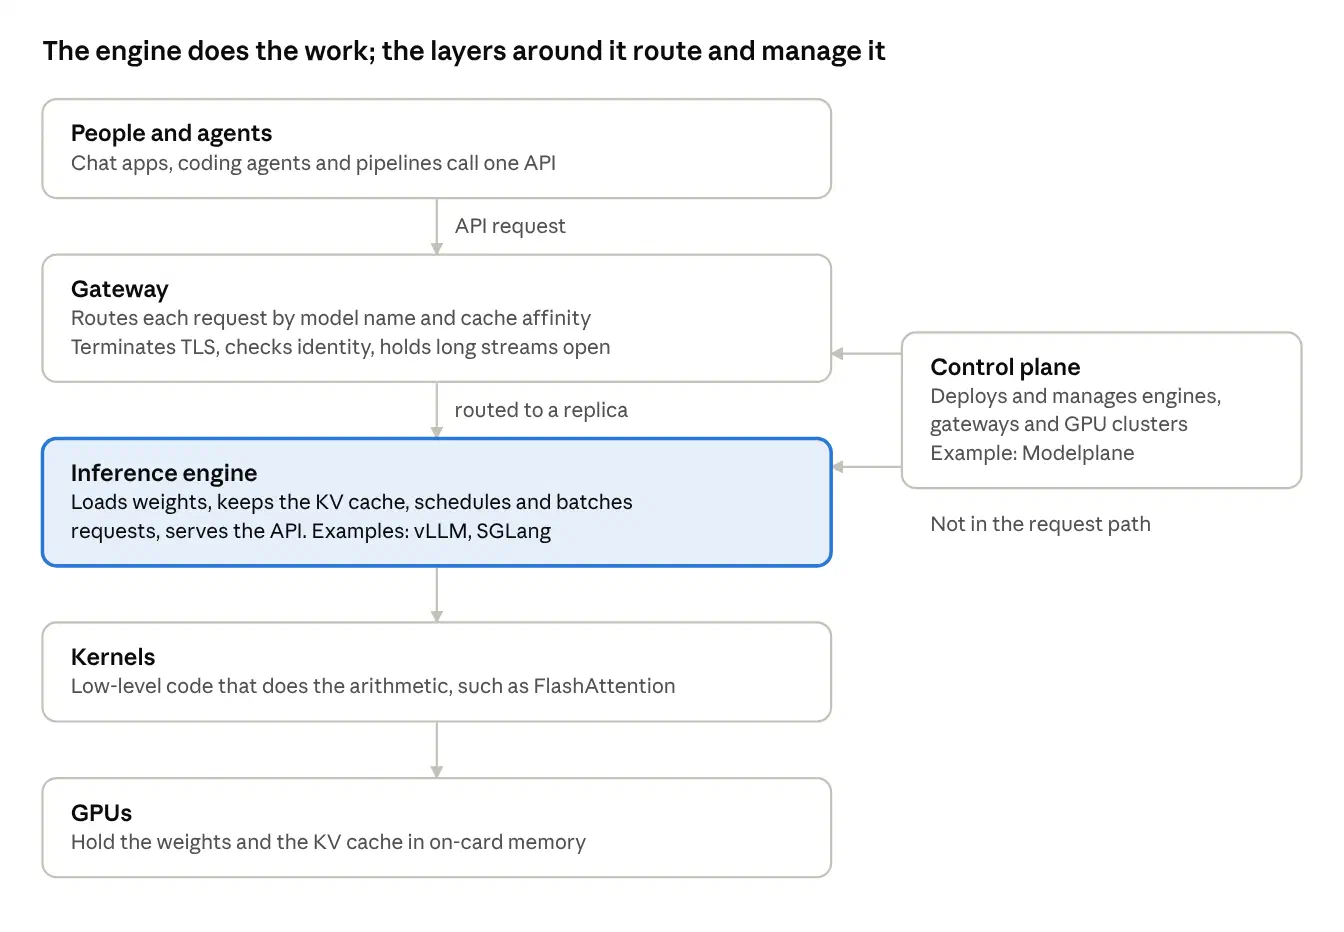
Este diagrama ilustra la arquitectura de cuatro capas de una pila de inferencia mencionada en la lista de principios de ingeniería.
El cambio hacia el autoalojamiento
Los equipos de plataforma se están convirtiendo cada vez más en equipos de inferencia a medida que las organizaciones buscan ejecutar modelos internamente para proteger el código fuente y los datos sensibles. Si bien las APIs alojadas suelen ser suficientes para el desarrollo temprano de productos, el autoalojamiento se vuelve más práctico a medida que las facturas de los modelos aumentan y los modelos abiertos —de los cuales hay ahora más de dos millones en Hugging Face— se vuelven competitivos con los sistemas cerrados.
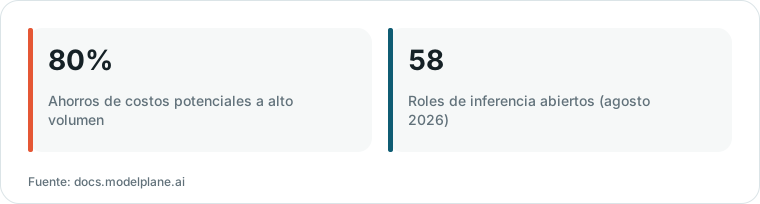
Gráfico elaborado por HN Digest a partir de cifras reportadas por docs.modelplane.ai; los valores se muestran como aparecen en la fuente.
El objetivo principal de la ingeniería de inferencia es gestionar el ciclo de vida de estos modelos: seleccionar el hardware adecuado, optimizar la memoria de la GPU y garantizar una alta disponibilidad. Este trabajo es distinto de la gestión de infraestructura estándar porque el precio de la capacidad de IA cae en gran medida debido a mejoras en cómo se sirven los modelos, más que solo por mejoras en el hardware de la GPU.
Esta representación visual representa la capa del plano de control de la pila de inferencia, que gestiona el ciclo de vida del modelo y la optimización del hardware.
“El precio de un nivel fijo de capacidad de IA cae aproximadamente 10 veces al año, y la mayor parte de eso proviene de cómo se sirven los modelos, no de mejores GPUs”
— modelplane/docs/content/guides/inference-guide.md at release-0.7 · modelplaneai/modelplane
Mecánica del motor de inferencia
Un motor de inferencia, como vLLM o SGLang, funciona como un servidor de base de datos con estado con una GPU conectada. Carga los pesos del modelo en la memoria de la GPU al arrancar —un proceso que puede tardar varios minutos— y mantiene una caché KV (Key-Value) para cada conversación en curso. A diferencia de las bases de datos estándar que utilizan la memoria RAM del sistema, los motores de inferencia deben mantener su conjunto de trabajo en la memoria de la GPU, que es costosa y limitada.
La caché KV es un componente crítico que almacena las claves y valores de atención para cada token en una conversación para evitar recalcular el historial. Para un modelo como Llama 3 70B, una sola conversación de 128K tokens puede requerir unos 40 GB de caché, lo que a menudo se convierte en el cuello de botella principal para la cantidad de usuarios concurrentes que una sola GPU puede atender.
Cuellos de botella de rendimiento y compensaciones
Las solicitudes de modelos se ejecutan en dos fases con cuellos de botella opuestos: la fase de 'prellenado' lee toda la entrada en paralelo y está limitada por la potencia de cómputo, mientras que la fase de 'decodificación' genera tokens uno por uno y está limitada por el ancho de banda de la memoria. Debido a que estas fases están limitadas por diferentes límites de hardware, las optimizaciones que mejoran la velocidad del primer token (TTFT) pueden tener poco efecto en la velocidad de los tokens posteriores (tokens por segundo).
Los ingenieros deben equilibrar la compensación entre la latencia y el rendimiento (throughput). Agrupar más solicitudes juntas aumenta el número total de tokens servidos por segundo (rendimiento), pero ralentiza el tiempo de respuesta para los usuarios individuales (latencia). Esto refleja la clásica compensación en la configuración de bases de datos entre el procesamiento de transacciones y las consultas analíticas.
Qué dicen los lectores de Hacker News
- Experiencia: Un comentarista compartió su experiencia utilizando un agente para construir manualmente una pila de servicio de clúster, señalando que pudieron manejar tareas complejas como la reutilización de la caché de kernels y la corrección de errores del motor. comentario ↗
- Escéptico: Otro lector expresó su preocupación de que la guía podría carecer de los fundamentos necesarios para los ingenieros de plataforma, sugiriendo que una comprensión profunda de la arquitectura transformer y los detalles internos de la caché KV es esencial para el rol. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗