En una prueba de rendimiento de una interfaz de usuario que contiene 3,000 filas activas, cambiar una sola etiqueta en el framework GPUI tomó 8.4 ms, un costo que escala linealmente con el tamaño del árbol de la interfaz de usuario en lugar del tamaño del cambio de estado. Este techo de rendimiento sugiere que, si bien frameworks como GPUI y egui ofrecen APIs atractivas y simples, sus modelos de estado subyacentes pueden ser 'callejones sin salida' para aplicaciones de escritorio nativas a gran escala.
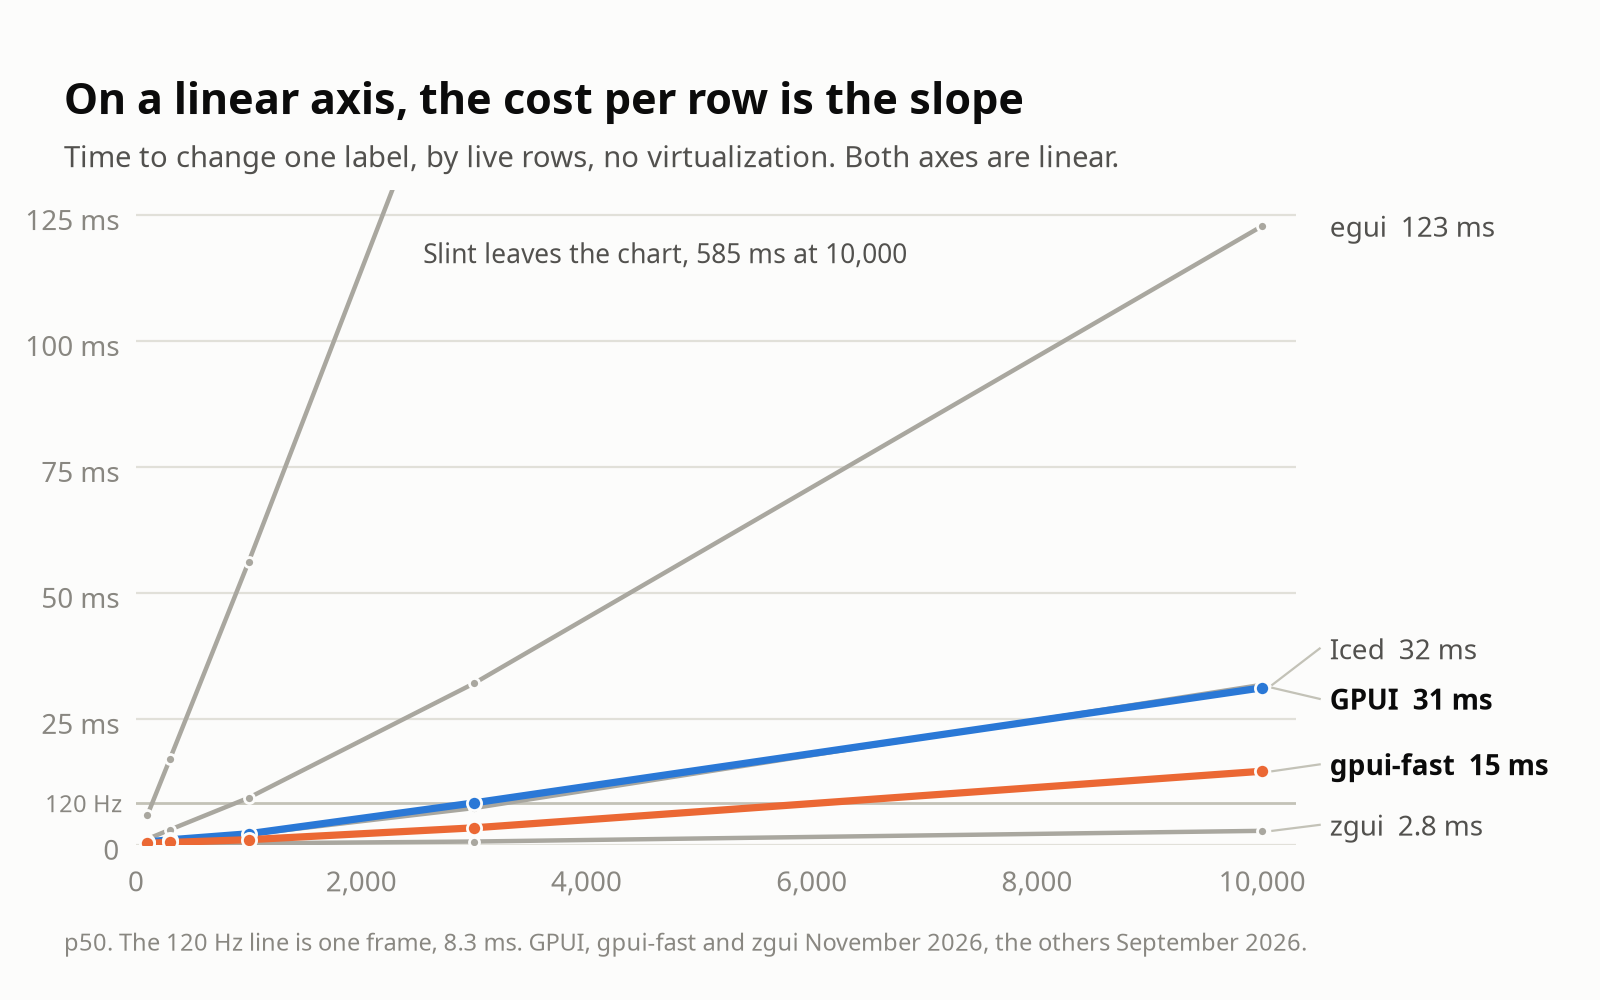
Este gráfico ilustra la escalabilidad lineal del rendimiento descrita en los resultados de las pruebas de rendimiento para GPUI.
El problema de la incrementalización de la interfaz de usuario
Cada framework de interfaz de usuario debe decidir eventualmente qué código ejecutar cuando cambia un solo valor. Si un framework no puede identificar las dependencias específicas de un componente de la interfaz de usuario, debe volver a ejecutar porciones más grandes del árbol de la interfaz de usuario, lo que provoca una degradación del rendimiento a medida que la aplicación crece.
El autor compara varios modelos: el modo inmediato (egui) ejecuta todo el código de la interfaz de usuario en cada cuadro; Elm (Iced) ejecuta toda la función de vista y compara el resultado; y GPUI utiliza un sistema de 'notificación'. Sin embargo, debido a que Rust carece de una barrera de escritura en las referencias mutables, el sistema de notificación de GPUI solo puede señalar que *algo* podría haber sucedido, obligándolo a volver a renderizar cada vista que no esté protegida por un límite de caché específico.
“Toma la precisión y pierdes la API agradable.”
— A Critique of GPUI
Evaluando el muro de escalabilidad
Para demostrar estas limitaciones, el autor realizó pruebas de rendimiento en un cambio de estado disperso en una interfaz de usuario grande. En GPUI, un movimiento del cursor o una pulsación de tecla costó lo mismo que una escritura de valor porque el costo sigue la estructura del árbol. Cuando las filas se escribieron como elementos simples sin caché, una sola actualización de etiqueta saltó de 8.4 ms a 92 ms.
Una protección de igualdad escrita a mano redujo ese costo de 92 ms a 0.9 µs, resaltando el rendimiento que se está perdiendo. Si bien el editor Zed se siente rápido, el autor señala que este omite las semánticas de diseño y vista de GPUI para su editor de texto, lo que significa que su rendimiento puede no reflejar los límites inherentes del framework en otros contextos.
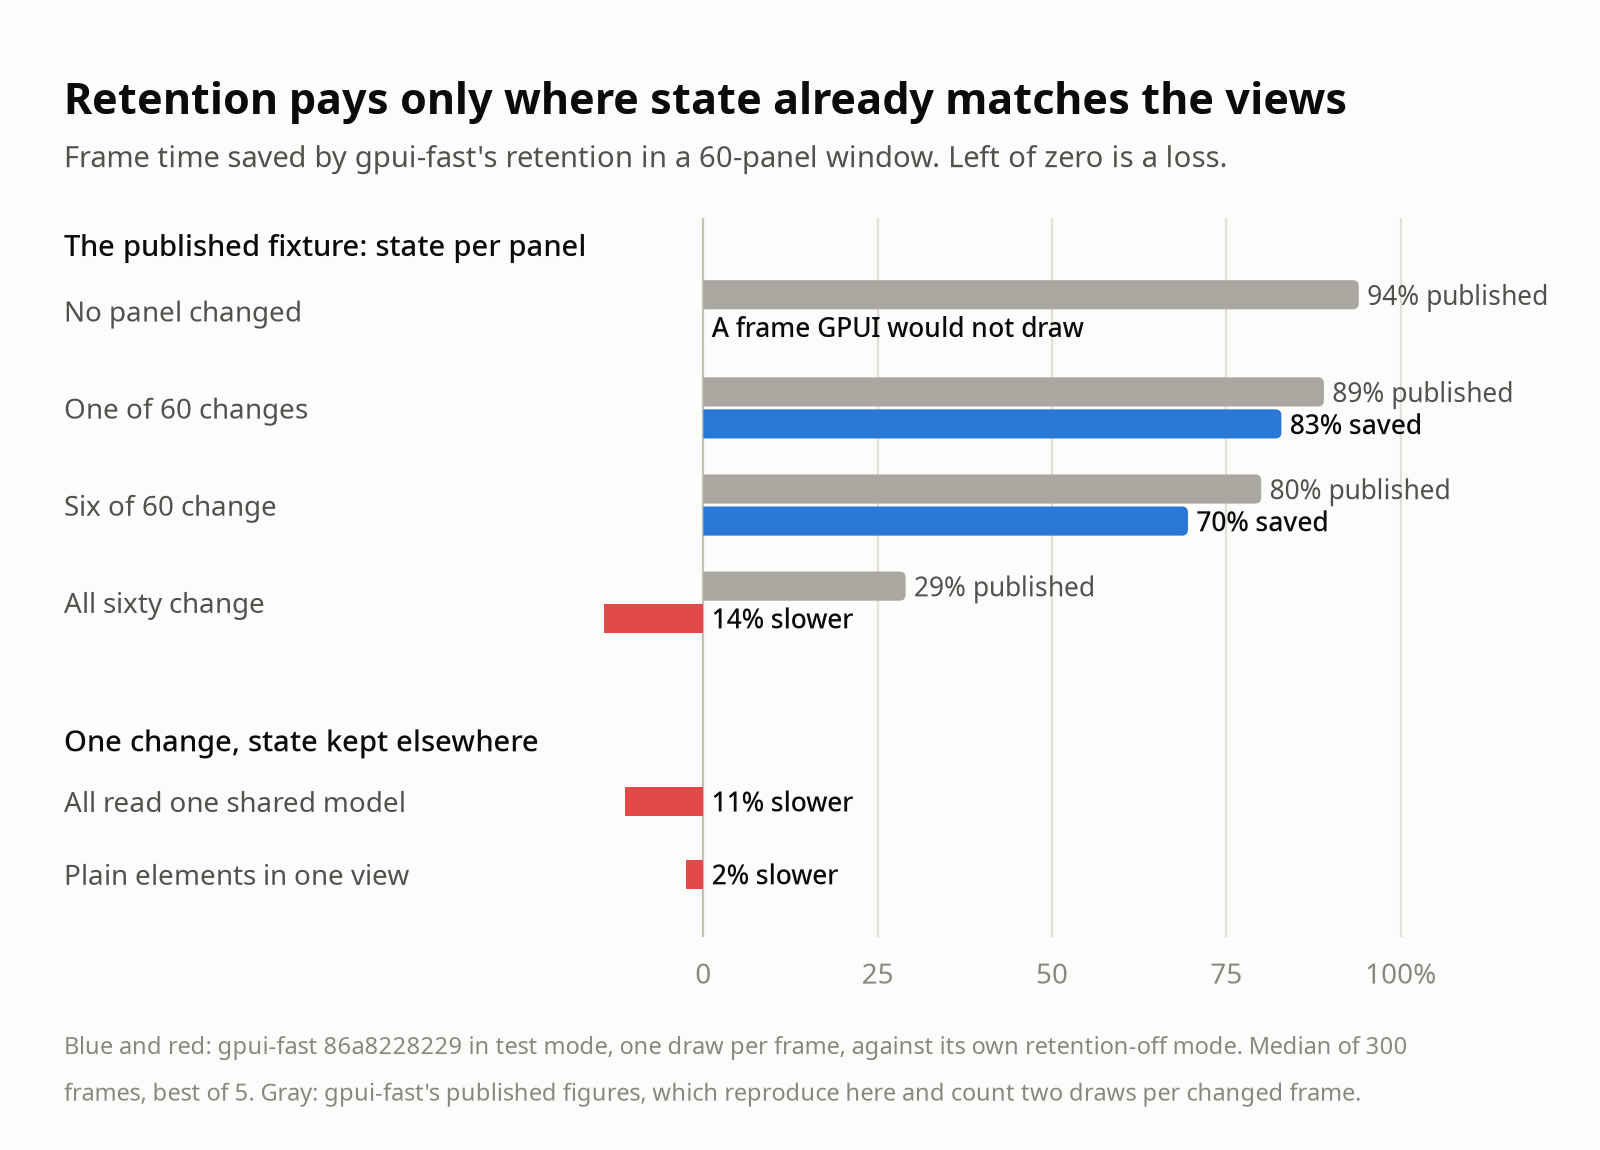
Esta figura explica las limitaciones de los modelos basados en retención discutidos en el análisis de escalabilidad.
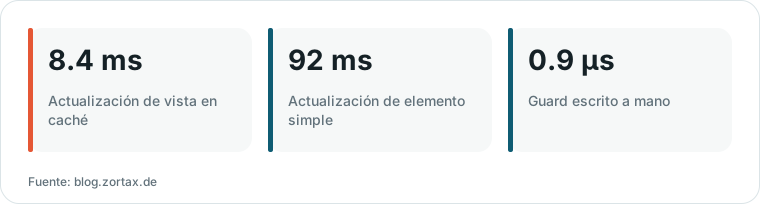
Gráfico elaborado por HN Digest a partir de las cifras de blog.zortax.de; los valores se muestran como en la fuente.
El compromiso entre simplicidad y precisión
El autor sostiene que hacer que GPUI sea lo suficientemente preciso para escalar requiere un cambio hacia un modelo basado en señales, donde los componentes son entidades de propiedad separada con suscripciones. Esto crea un 'grafo de señales' construido a mano, que es más complejo de razonar que el enfoque actual de 'función simple' de GPUI.
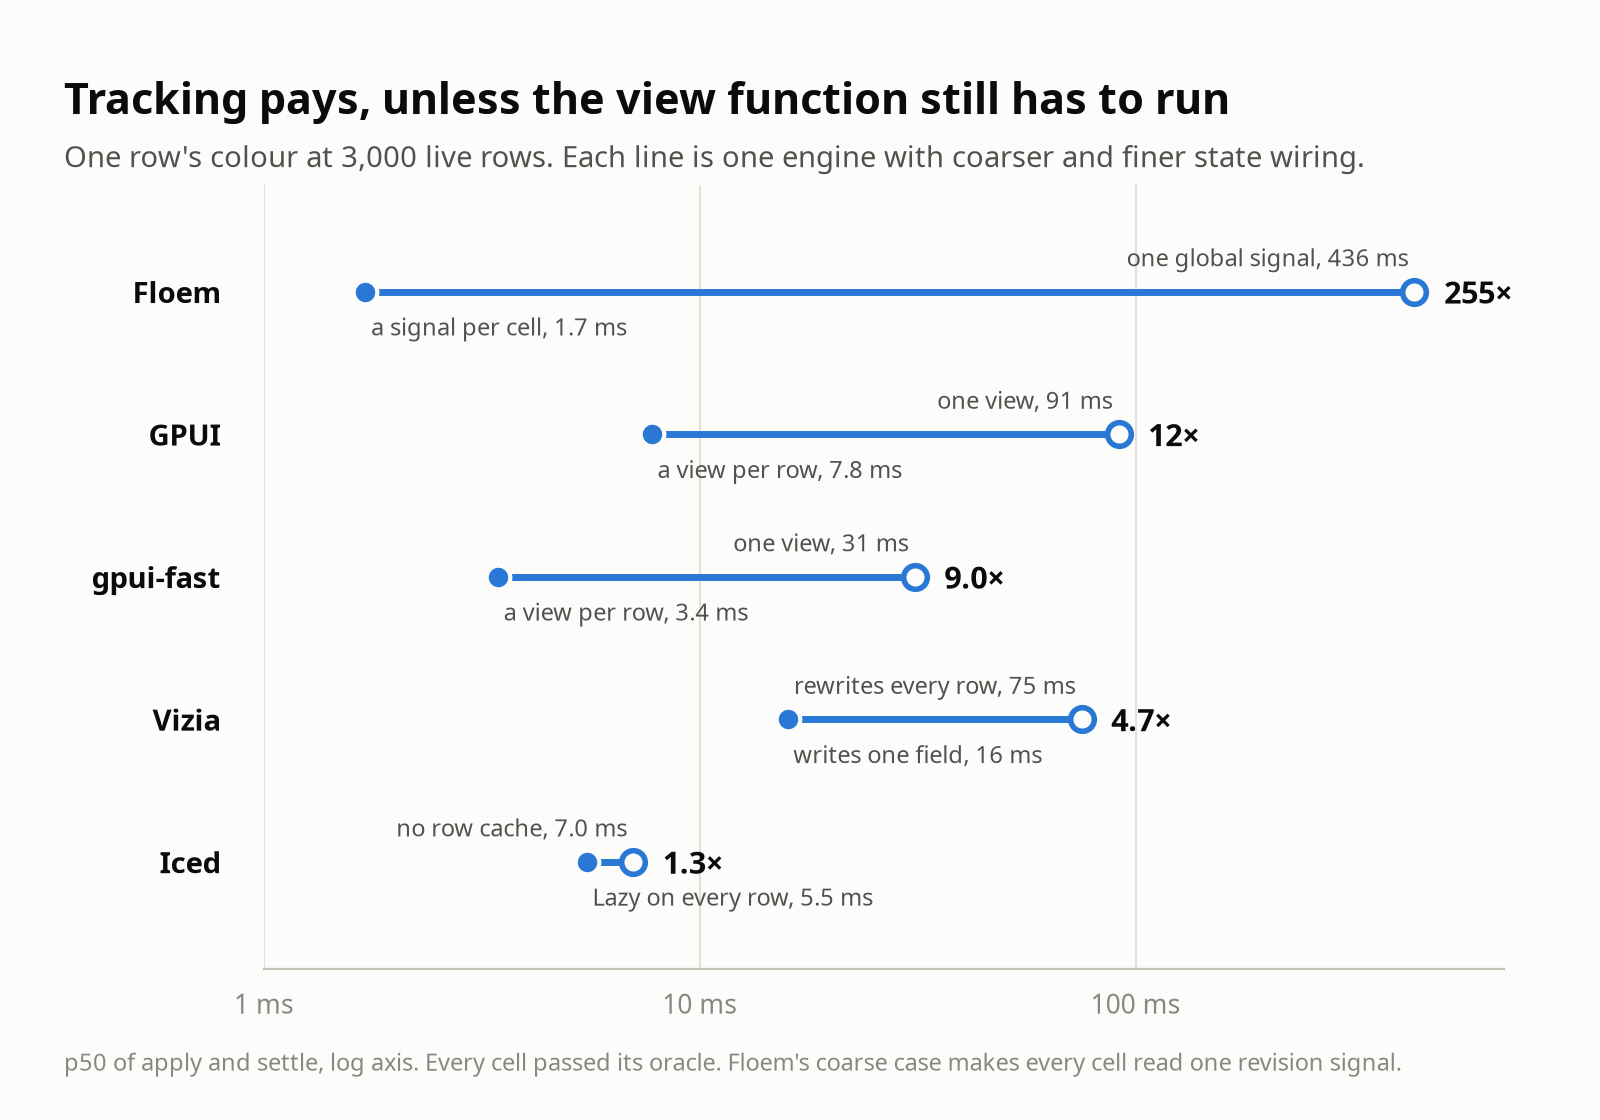
Esta visualización aclara el compromiso entre la precisión del seguimiento y la sobrecarga de ejecución real.
Del mismo modo, la arquitectura Elm proporciona una única fuente de verdad pero se vuelve difícil de gestionar a gran escala. En aplicaciones complejas, la lógica de un solo valor (como un contador de no leídos) puede dispersarse por cada variante de mensaje, lo que dificulta su mantenimiento en comparación con una definición de señal centralizada.
Qué dicen los lectores de Hacker News
- Pregunta abierta: Un comentarista cuestionó la premisa del autor señalando que el software complejo como los clones de Adobe actualmente funcionan bien a pesar de estas limitaciones arquitectónicas. comentario ↗
- Alternativa: Un comentarista sugirió que los problemas de escalabilidad podrían abordarse dividiendo las entidades en grupos más pequeños en lugar de gestionar una entidad masiva. comentario ↗
- Escéptico: Otro usuario argumentó que la complejidad de las interfaces estilo CAD podría no ser tan grave como se sugiere, señalando que los controles visibles suelen ser limitados en número. comentario ↗
- Escéptico: Un comentarista observó que muchas aplicaciones profesionales de GUI priorizan la experiencia del usuario sobre la eficiencia bruta, tratando a menudo la gestión de estado como una preocupación secundaria. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗