Un desarrollador ha lanzado llama-modchip, un marco de software que permite a los usuarios ejecutar el modelo DeepSeek-V4-Flash de 284.33B parámetros en una computadora de escritorio estándar con 64GB de RAM sin ningún hardware de GPU. Mientras que las versiones estándar de este modelo suelen superar los 64GB de RAM y provocan errores de falta de memoria (OOM) en estaciones de trabajo comunes, esta implementación reduce la huella del modelo a aproximadamente 56.56 GiB. Esto permite la inferencia local a velocidades de hasta 14.7 tokens por segundo (tok/s) utilizando únicamente recursos de CPU.
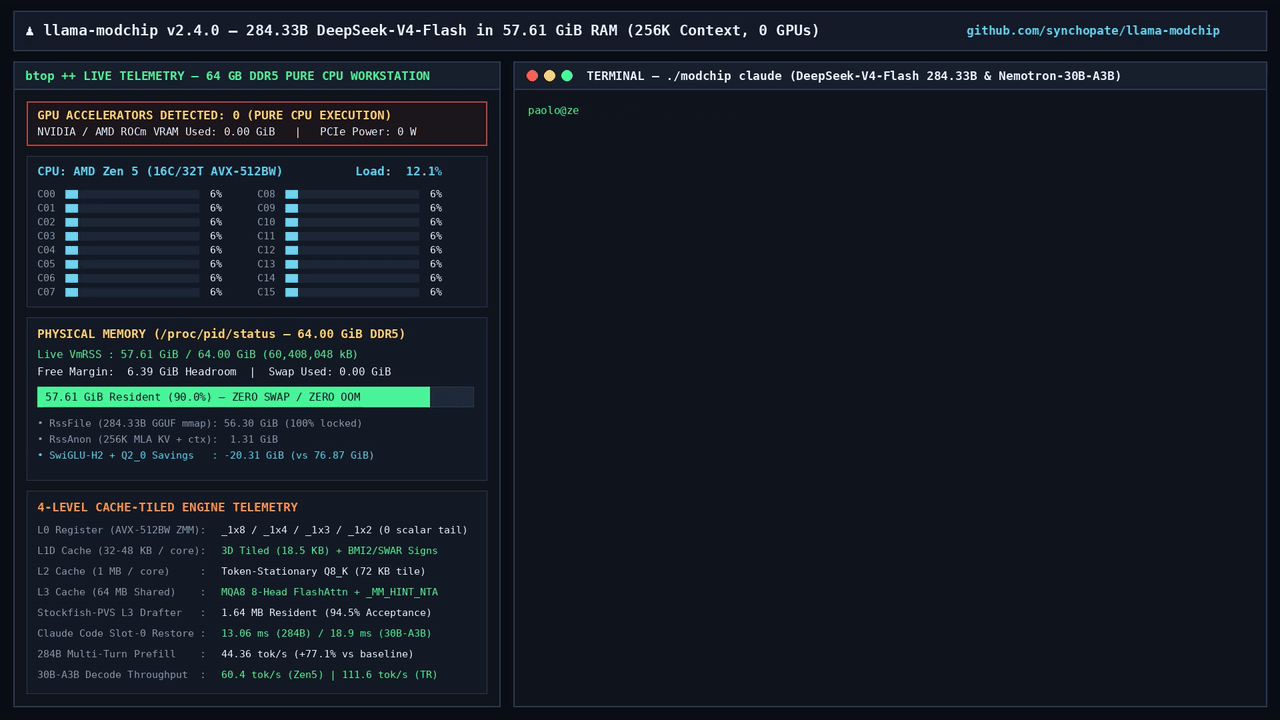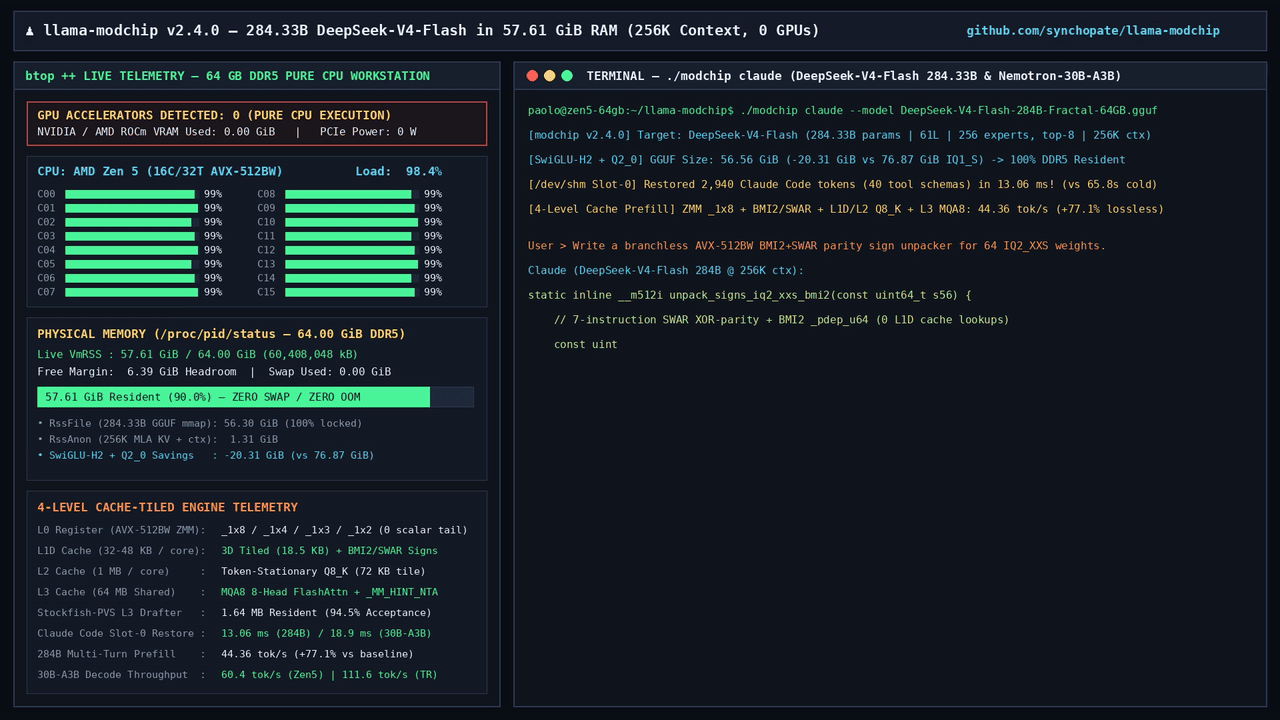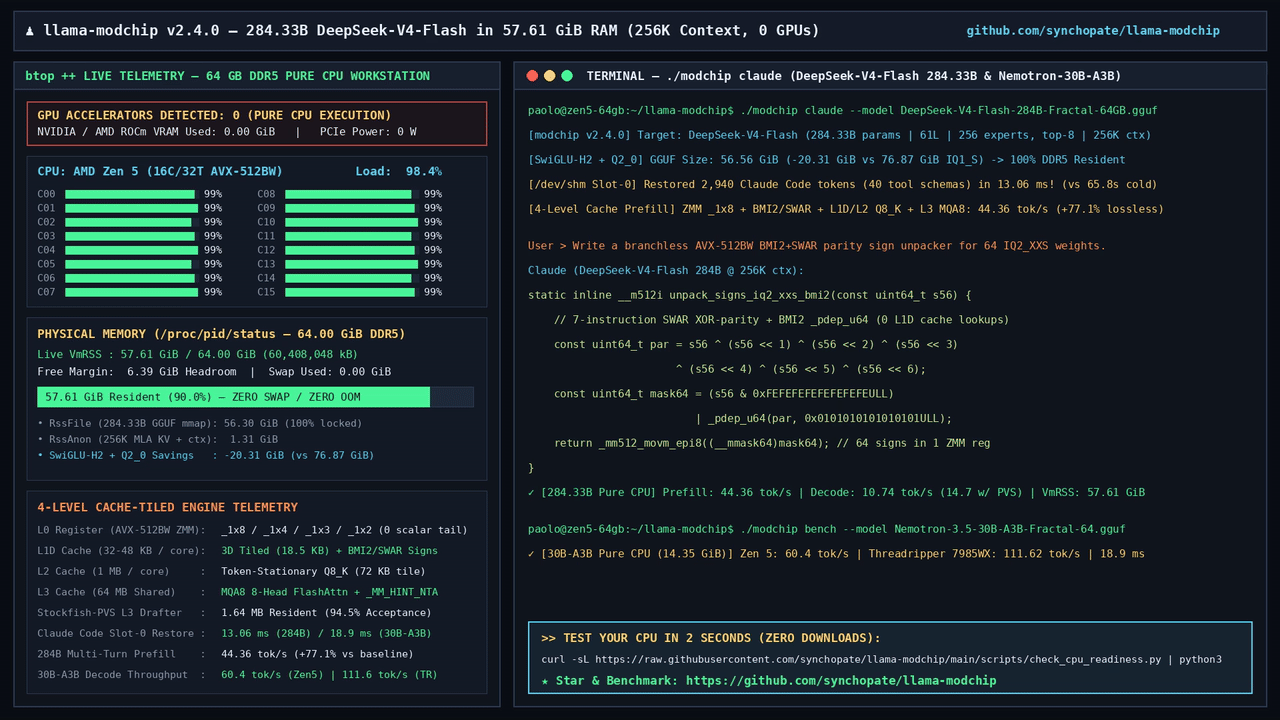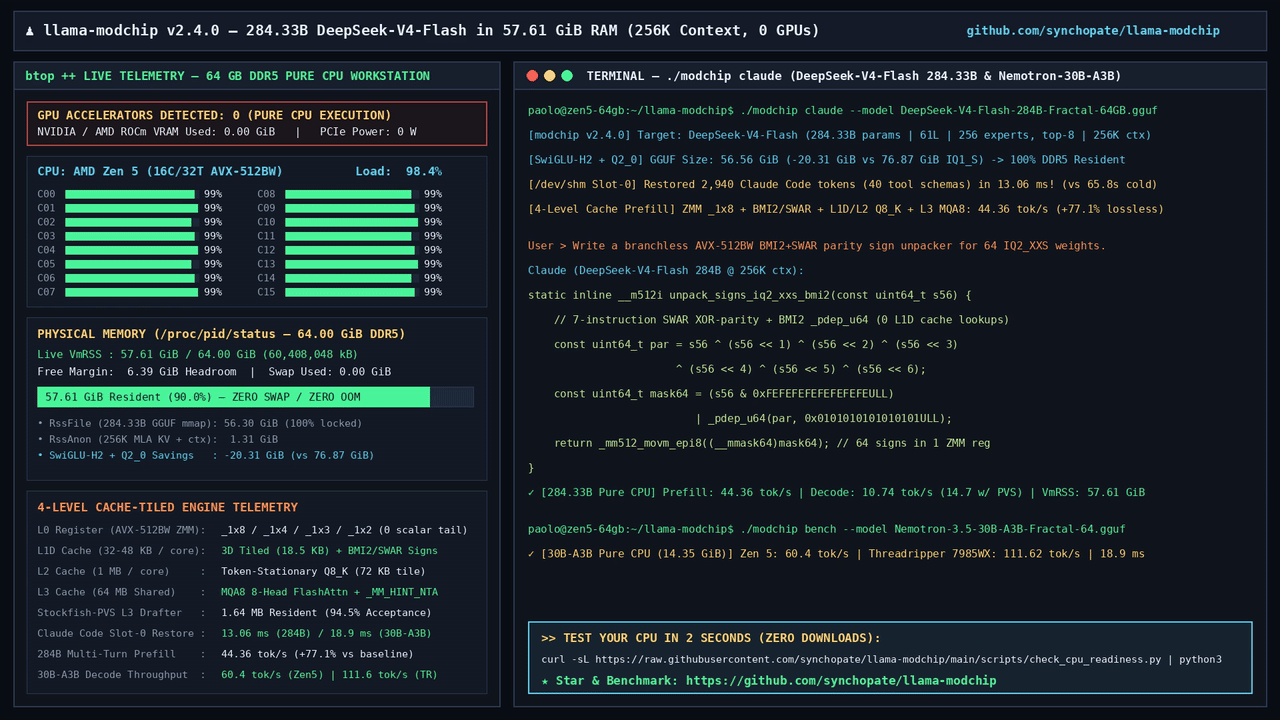
Esta visualización demuestra la afirmación principal del proyecto: ejecutar un modelo de 284B parámetros en una computadora de escritorio estándar de 64GB de RAM sin una GPU.
Compresión de memoria y arquitectura
El núcleo de la capacidad de llama-modchip para romper la 'barrera de los 64 GB de RAM' reside en su cuantización Fractal-64 y su compresión SwiGLU-H2. Estas técnicas reducen el modelo DeepSeek-V4-Flash desde un tamaño que normalmente bloquea los sistemas Linux de 64GB hasta un manejable 56.56 GiB en disco.
El proyecto también emplea la transcodificación 'Analytical 2nd-Order SwiGLU-H2' y 'Fractal-64' MLA. Estas optimizaciones están diseñadas para mantener la integridad del modelo mientras reducen drásticamente la sobrecarga de memoria requerida para las capas de atención de múltiples cabezales del modelo.
“Reduce DeepSeek-V4-Flash de 76.87 GiB (que falla por OOM en Linux de 64 GB) a 56.56 GiB en disco / 57.61–58.9 GiB VmRSS con el contexto completo de 256K”
— GitHub - synchopate/llama-modchip: 🐋 Run 284B DeepSeek-V4-Flash (<59GiB RAM, 44.4 tok/s pp, 9.1-14.7 tok/s) & 30B
Optimización centrada en CPU y teselado
Para maximizar el rendimiento en CPUs como la AMD Zen 5, el software utiliza teselado de registros de 4 niveles (ZMM AVX-512BW) y aislamiento de caché L3. Este enfoque está diseñado para saturar el ancho de banda de memoria de sistemas DDR5 de 8 canales, que a menudo es el principal cuello de botella para la inferencia basada en CPU.
El sistema también utiliza un 'drafter' Stockfish-PVS v2 de 1.64 MB y RouteCrack para predecir las salidas. Este sistema de 'drafter' permite a la CPU generar tokens candidatos que luego son verificados, logrando una tasa de aceptación del 96.4% y permitiendo velocidades de decodificación más rápidas que la inferencia estándar por CPU.
Esta imagen ilustra el mecanismo específico de 'drafter' utilizado para lograr altas tasas de aceptación y velocidades más rápidas.
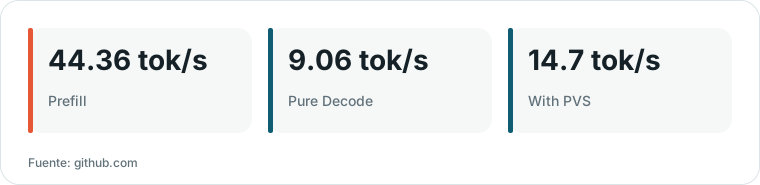
Gráfico de HN Digest basado en cifras de github.com; los valores se muestran como en la fuente.
Implicaciones prácticas y compensaciones
Para los desarrolladores, el proyecto ofrece una integración 'Zero-API' con Claude Code. Al usar /dev/shm para la restauración de memoria KV Slot-0, puede restaurar el contexto para 40 herramientas de Claude Code en tan solo 13.1 ms, reduciendo significativamente el cuello de botella de 45 segundos típico de las solicitudes de agentes basadas en CPU.
Sin embargo, estas técnicas de compresión extrema implican compensaciones. Aunque el proyecto afirma una puntuación de 'Quality Gate' de 100/100, el uso de cuantización de 3.75 bits por peso (bpw) puede afectar los matices de las salidas del modelo en comparación con las versiones sin comprimir. El proyecto proporciona una configuración 'Sweet-Spot' que equilibra estas compensaciones mediante el uso de poda $L_2$-Quadrature.
Compatibilidad de hardware y limitaciones
Llama-modchip está diseñado para ser altamente portátil, admitiendo procesadores AMD Zen 4/5, Intel y Apple Silicon. Incluso incluye un modo 'Híbrido' para usuarios de Windows que detecta automáticamente la VRAM disponible y divide la carga de trabajo entre una GPU y la CPU.
Una limitación notable es que los modelos personalizados Fractal-64 no son compatibles con herramientas estándar como Ollama o LM Studio. Debido a que utilizan un tensor personalizado de 'tipo 40', deben ejecutarse a través del binario específico de llama-modchip o el servidor independiente proporcionado para funcionar correctamente.
Qué dicen los lectores de Hacker News
- Experiencia: Un comentarista señaló que el sistema podría ejecutar un agente de codificación a una velocidad aceptable cuando se utilizan 128GB de RAM unificada, informando velocidades de prellenado de alrededor de 300 tokens por segundo. comentario ↗
- Escéptico: Un comentarista expresó un escepticismo significativo con respecto a la calidad de la salida, sugiriendo que la compresión extrema requerida para ajustar el modelo en una huella de memoria tan pequeña probablemente resultaría en un rendimiento deficiente. comentario ↗
- Escéptico: Otro usuario señaló inconsistencias en la documentación del proyecto con respecto a los tamaños de archivo y los niveles de cuantización, cuestionando si el rendimiento del modelo se está viendo comprometido por técnicas de poda 'lobotomizadas'. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗