Edge0-145B es el primer modelo de IA de código abierto para dispositivos con 145 mil millones de parámetros en el mundo, capaz de ejecutarse en una laptop personal compatible con un pico de memoria reportado de 29GB. Al trasladar las capacidades de razonamiento y codificación de alto parámetro desde la nube hacia el hardware local, el modelo elimina las tarifas recurrentes de API y las restricciones de manejo de datos, manteniendo al mismo tiempo un rendimiento que rivaliza con los modelos de nube de vanguardia.
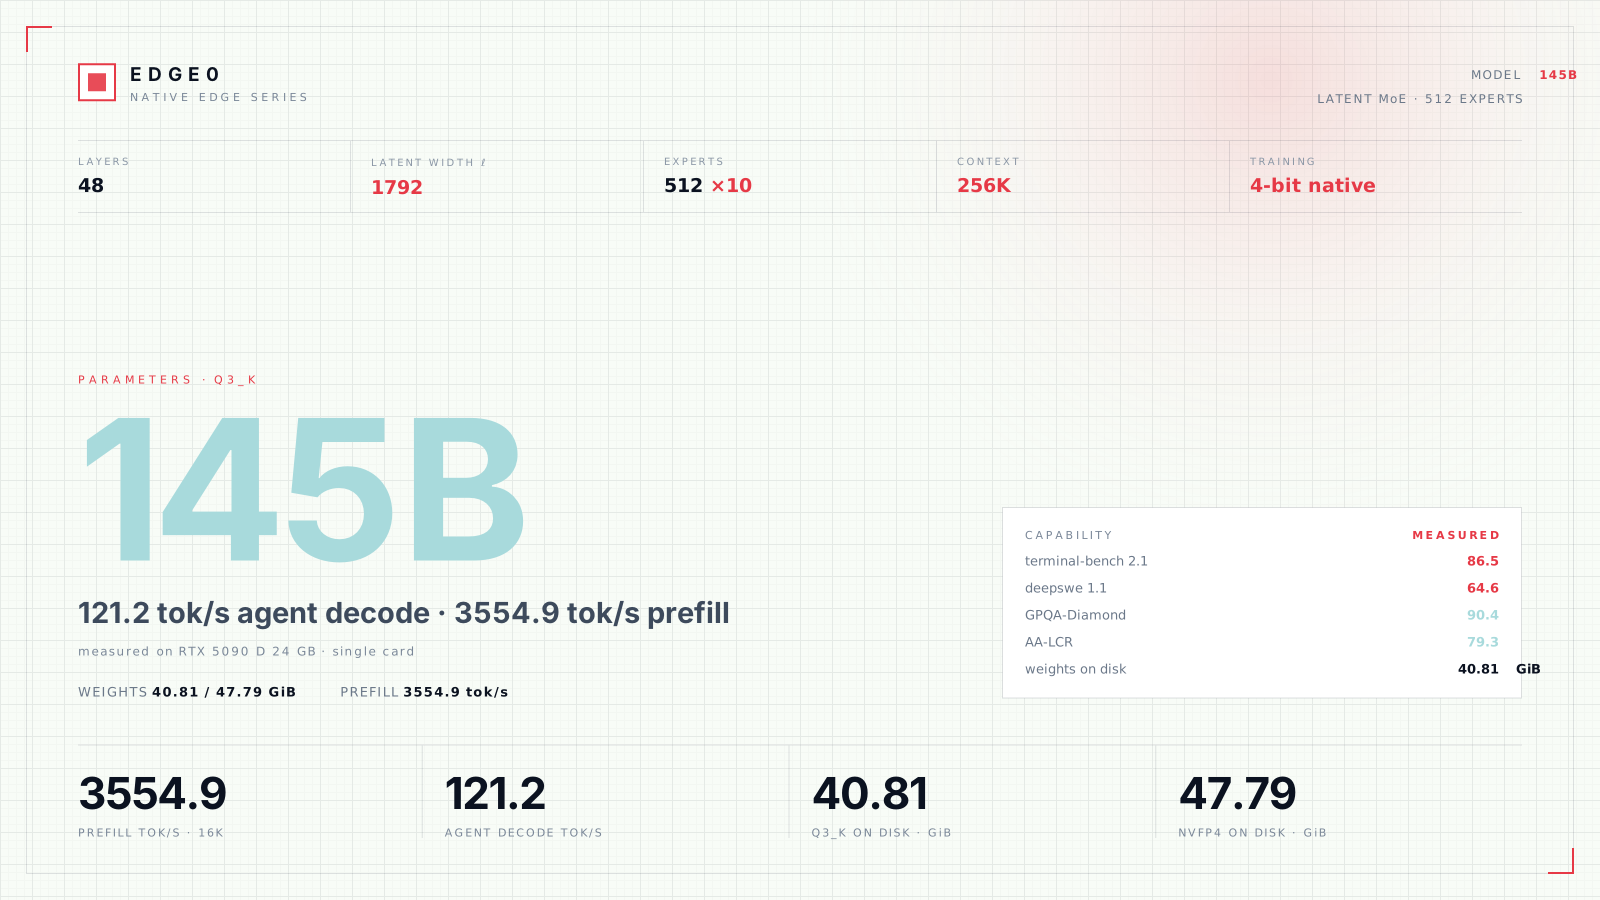
Este diagrama ilustra la arquitectura técnica y las métricas de rendimiento del modelo de 145 mil millones de parámetros.
Superando la barrera de la memoria
Históricamente, los modelos de IA en dispositivos han estado limitados a escalas más pequeñas, como los modelos de 1.8B a 3.25B de parámetros utilizados en bases móviles. Esto se debió a una 'barrera de memoria' donde los modelos grandes requerían más memoria y ancho de banda de lo que el hardware personal podía proporcionar, forzando un compromiso entre la capacidad del modelo y la ejecución local.
Edge0-145B aborda esto utilizando una arquitectura MoE latente. En este diseño, grupos de 64 expertos comparten dos matrices grandes, mientras que cada experto conserva un pequeño conjunto de parámetros para capturar sus diferencias específicas. Este intercambio reduce sustancialmente los pesos que deben moverse durante la inferencia, manteniendo al mismo tiempo un alto número de expertos.
“Edge0-145B es el primer modelo de IA de código abierto para dispositivos en el mundo con 145 mil millones de parámetros.”
— Edge0-145B: Open-Source On-Device AI with 145B Parameters
Motor de inferencia de múltiples niveles
Para manejar los 145 mil millones de parámetros, el marco Edge0 utiliza un diseño de cuatro capas que procesa en serie el acceso a la memoria GPU, la memoria del sistema y el SSD. Los 'expertos calientes' utilizados con frecuencia permanecen en la memoria GPU, mientras que una biblioteca de expertos de aproximadamente 40GB se sitúa en la memoria del sistema, y 48GB de datos de vocabulario residen en el SSD para ser leídos bajo demanda.
El sistema también emplea una programación paralela, utilizando la CPU y la GPU juntas. La GPU calcula los expertos en caché mientras la CPU maneja el trabajo restante, y se utiliza la decodificación especulativa para verificar múltiples tokens candidatos a la vez, distribuyendo el costo de lectura de los pesos a través de más tokens de salida.
Rendimiento y aplicaciones prácticas
En pruebas internas, Edge0-145B demostró una velocidad de prellenado de más de 1,100 tokens por segundo y una tasa de decodificación de más de 80 tokens por segundo. Estas velocidades permiten flujos de trabajo agénticos complejos, como generar escenas 3D en Blender o producir guiones de video, donde el modelo puede planificar, escribir, depurar e inspeccionar visualmente su propio trabajo.
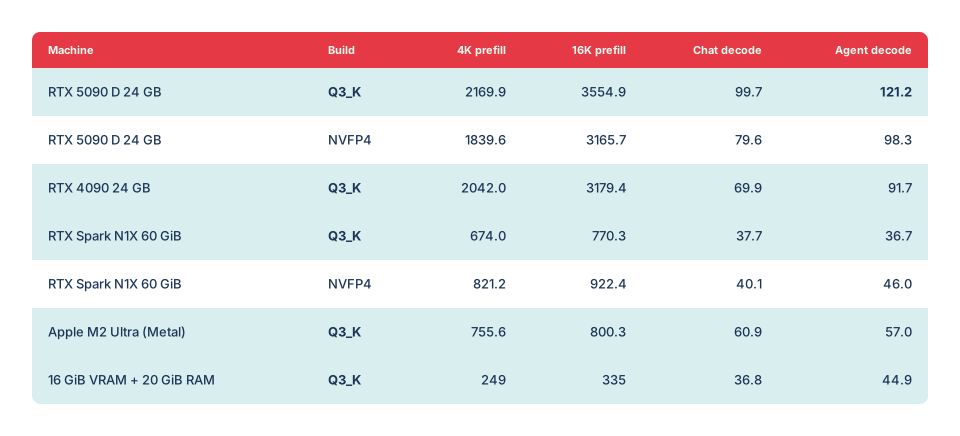
La tabla de velocidad proporciona puntos de datos específicos para el rendimiento del modelo en diferentes escenarios.
Si bien el modelo elimina las tarifas de tokens de los modelos en la nube y mantiene los datos locales, todavía requiere hardware específico. Los resultados reportados se lograron en una configuración con una huella de memoria pico de 29GB y un consumo de energía típico de aproximadamente 120W, lo que significa que los usuarios deben poseer hardware capaz de sostener estas demandas sin reducción de rendimiento.
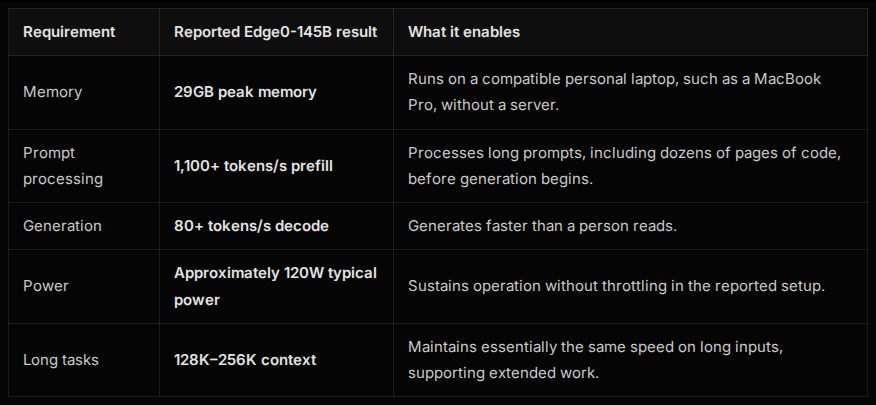
Esta tabla proporciona los requisitos de hardware específicos y las métricas de rendimiento mencionadas en el párrafo final.
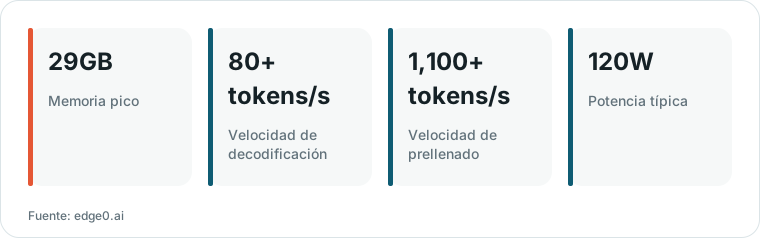
Gráfico elaborado por HN Digest a partir de cifras reportadas por edge0.ai; los valores se muestran tal como aparecen en la fuente.
Qué dicen los lectores de Hacker News
- Experiencia: Un comentarista que ha utilizado modelos similares para agentes de codificación sugirió que las puntuaciones del benchmark se alinean con el rendimiento del mundo real para trabajos de conocimiento complejos y recomendó una evaluación. comentario ↗
- Escéptico: Un comentarista expresó escepticismo sobre la utilidad práctica de los diseños creados por agentes, señalando que la limpieza manual de resultados desordenados a veces puede anular el tiempo ahorrado al usar IA. comentario ↗
- Escéptico: Otro usuario compartió una visión cautelosa, señalando que es escéptico sobre las capacidades del modelo dado su tamaño, pero sigue interesado en ver si las pruebas de terceros confirman los valores publicados. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗