Claude Fable 5.2 (Max) ha logrado una puntuación de 65 en el Índice de Inteligencia de Análisis Artificial, situándose muy por encima de la puntuación mediana de 40 para modelos de su clase. Si bien esto indica un alto nivel de inteligencia, el rendimiento del modelo conlleva notables compensaciones en eficiencia, requiriendo 45.0 minutos para completar una sola tarea del Índice de Inteligencia, en comparación con la mediana de 12.9 minutos para modelos similares.
Métricas de Inteligencia y Rendimiento
El modelo Claude Fable 5.2 (Max) demuestra una alta inteligencia en una serie de evaluaciones que incluyen trabajo de conocimiento, programación, ciencia y conocimientos generales. Logró una puntuación de 65 en el Índice de Inteligencia de Análisis Artificial, que incorpora nueve evaluaciones distintas como AA-Briefcase v1.1 y FrontierCode 2.0.
A pesar de su alta puntuación de inteligencia, el rendimiento del modelo se ve obstaculizado por una latencia significativa. Registró un tiempo de primer token de respuesta de 171.16 segundos y una velocidad de salida de 101 tokens por segundo, lo que contribuye a un tiempo de finalización de tarea general lento.
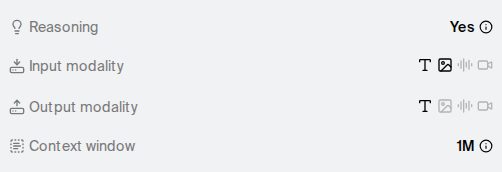
Esta captura de pantalla proporciona los puntos de datos técnicos específicos, como las velocidades de tokens y las puntuaciones de inteligencia, mencionados en la sección de métricas de rendimiento.
“Claude Fable 5.2 (Max, Default Fallback) obtiene una puntuación de 65 en el Índice de Inteligencia de Análisis Artificial, situándose muy por encima del promedio entre modelos comparables (mediana: 40).”
— Claude Fable 5.2 (max) - Intelligence, Performance & Price Analysis | Artificial Analysis
Compensaciones de Costo y Verbosidad
Los costos operativos del modelo son significativamente más altos que el promedio de la industria para su clase. Cuesta $8.00 por 1M de tokens de entrada y $40.00 por 1M de tokens de salida, lo que resulta en un costo promedio de $26.54 por tarea del Índice de Inteligencia.
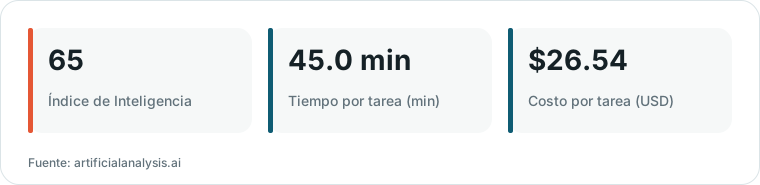
Gráfico elaborado por HN Digest a partir de cifras de artificialanalysis.ai; los valores se muestran como en la fuente.
Un factor principal de estos costos es la extrema verbosidad del modelo. Durante la evaluación del Índice de Inteligencia, generó 275M de tokens de salida, lo que es casi cuatro veces la mediana de 72.8M de tokens utilizados por modelos comparables.
Variantes del Modelo y Limitaciones
El lanzamiento de Claude Fable 5.2 incluye cinco modelos diferentes adaptados a distintas necesidades. Por ejemplo, la variante 'Low' ofrece la mejor velocidad con 6.5 minutos por tarea y el costo más bajo con $3.10 por tarea, ilustrando una amplia gama de características de rendimiento dentro del lanzamiento.
Si bien la variante Max proporciona la inteligencia más alta, las razones específicas de su alta verbosidad y sus lentos tiempos de finalización en comparación con sus pares no se abordan en el análisis actual. Además, los nombres y métricas específicos de los otros tres modelos en el lanzamiento, más allá de la variante 'Low', no se detallan actualmente.
Qué dicen los lectores de Hacker News
- Alternativa: Un comentarista señaló que el costo del modelo por tarea se ha duplicado en comparación con su predecesor debido a un aumento significativo en los tokens de salida. comentario ↗
- Escéptico: Otro usuario sugirió que el rendimiento del modelo podría estar influenciado por el acceso temprano a las pruebas de rendimiento, señalando que podría no haber terminado de ejecutarse antes del lanzamiento público. comentario ↗
- Experiencia: Un comentarista argumentó que la versión 'Max' puede estar en un territorio de rendimientos decrecientes y solo debería usarse cuando cada bit de rendimiento sea estrictamente necesario. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗