Edge0-145Bは、世界初の1450億パラメータを持つオープンソースのオンデバイスAIモデルであり、報告されたピークメモリ29GBを備えた互換性のある個人用ノートPCで動作可能です。高パラメータの推論およびコーディング能力をクラウドからローカルハードウェアへ移行することで、このモデルは、最先端のクラウドモデルに匹敵するパフォーマンスを維持しながら、継続的なAPI料金やデータ処理の制約を排除します。
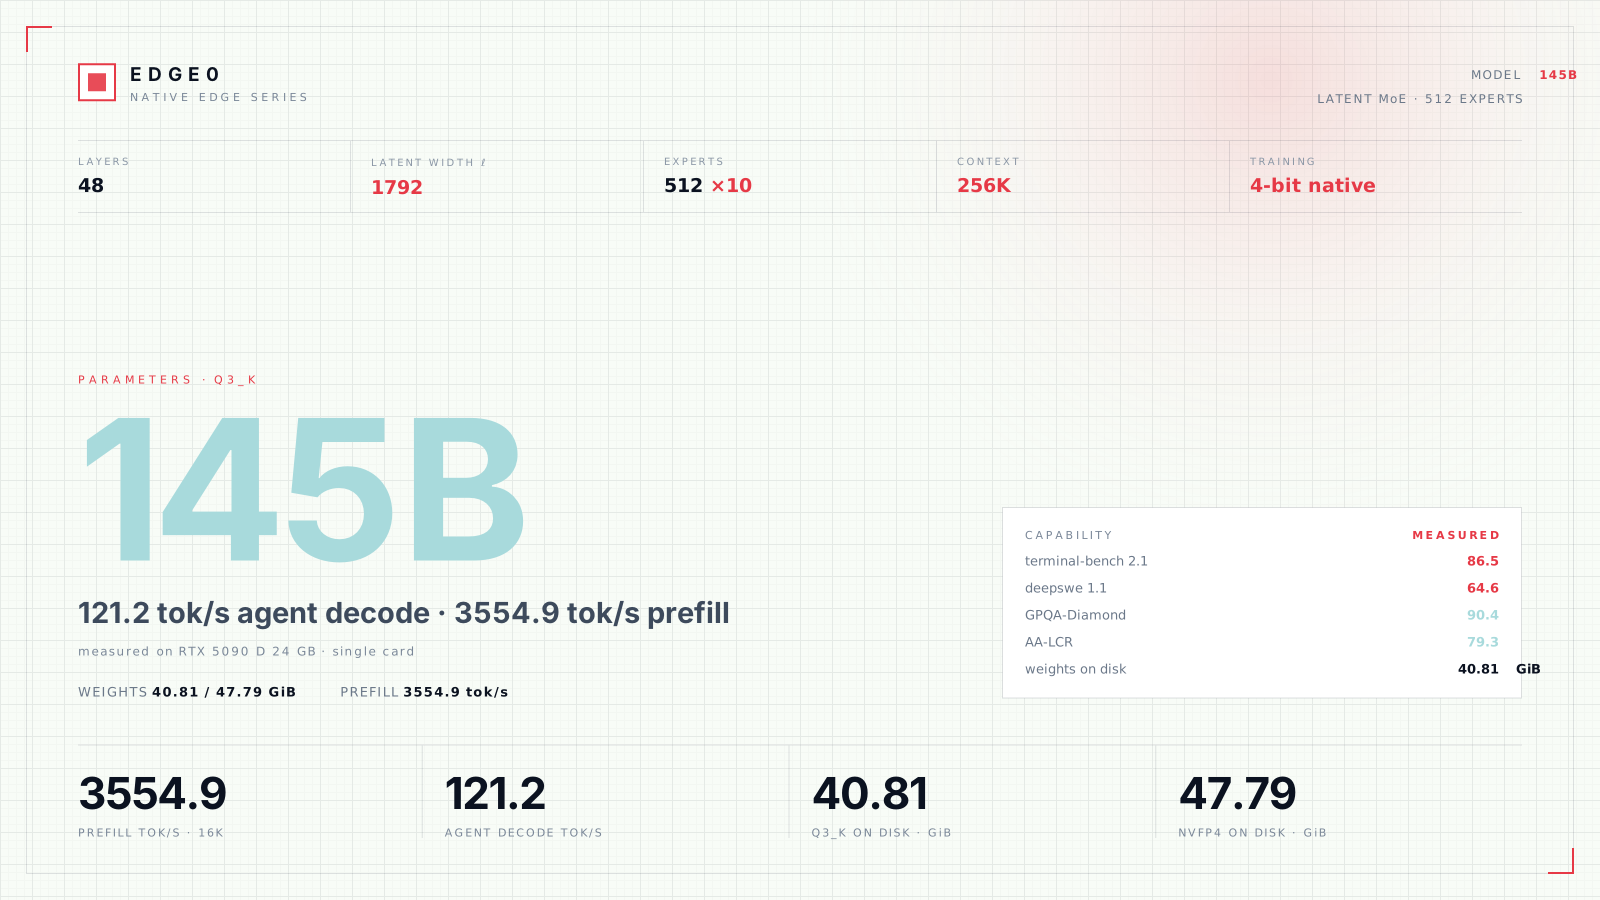
この図は、1450億パラメータモデルの技術的アーキテクチャとパフォーマンス指標を説明しています。
メモリの壁を克服する
歴史的に、オンデバイスAIモデルは、モバイル基盤で使用される18億から32.5億パラメータのモデルなど、より小規模なスケールに制限されてきました。これは、大規模なモデルが個人用ハードウェアで提供できる以上のメモリと帯域幅を必要とする「メモリの壁」によるものであり、モデルの能力とローカル実行の間のトレードオフを強いていました。
Edge0-145Bは、潜在的なMoEアーキテクチャを使用することでこの課題に対処しています。この設計では、64の専門家グループが2つの大きな行列を共有し、各専門家は特定の差異を捉えるための小さなパラメータセットを保持します。この共有により、推論中に移動する必要のある重みを大幅に削減しながら、高い専門家数を維持しています。
「Edge0-145Bは、1450億パラメータを持つ世界初のオープンソースのオンデバイスAIモデルです。」
— Edge0-145B: Open-Source On-Device AI with 145B Parameters
多層推論エンジン
1450億のパラメータを処理するために、Edge0フレームワークはGPUメモリ、システムメモリ、およびSSDへのアクセスをパイプライン化する4層設計を採用しています。頻繁に使用される「ホットな専門家」はGPUメモリに留まり、約40GBの専門家ライブラリはシステムメモリに配置され、48GBの語彙データはSSDに格納され、必要に応じて読み取られます。
システムはまた、CPUとGPUを併用する並列スケジューリングを採用しています。GPUがキャッシュされた専門家を計算する一方で、CPUが残りの作業を処理し、投機的デコーディングを使用して複数の候補トークンを一度に検証することで、重みの読み取りコストをより多くの出力トークンに分散させます。
パフォーマンスと実用的なアプリケーション
内部テストにおいて、Edge0-145Bは毎秒1,100トークン以上のプリフィル速度と、毎秒80トークン以上のデコード速度を実証しました。これらの速度により、Blenderでの3Dシーン生成やビデオスクリプトの制作など、モデルが自身の作業を計画、執筆、デバッグ、および視覚的に検査できる複雑なエージェント的ワークフローが可能になります。
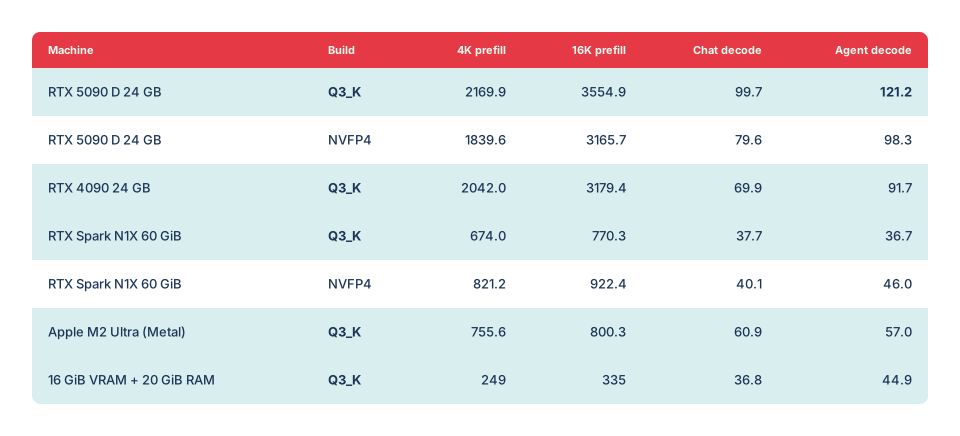
速度表は、さまざまなシナリオにおけるモデルのパフォーマンスの具体的なデータポイントを提供します。
このモデルはクラウドモデルのトークン料金を排除しデータをローカルに保持しますが、依然として特定のハードウェアを必要とします。報告された結果は、29GBのピークメモリフットプリントと約120Wの典型的な消費電力を持つセットアップで達成されており、ユーザーはスロットリングなしでこれらの要求を維持できるハードウェアを所有している必要があります。
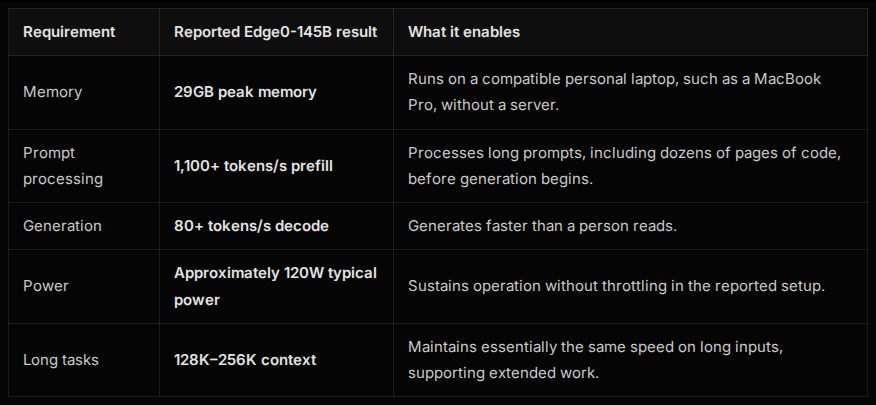
この表は、最終段落で言及されている特定のハードウェア要件とパフォーマンス指標を提供します。
HN Digestによる図表(edge0.aiの報告数値に基づく)。数値はソースの表記通りです。
Hacker Newsの読者の反応
- 体験談: コーディングエージェントに同様のモデルを使用したあるコメント主は、ベンチマークスコアが複雑な知識作業の現実的なパフォーマンスと一致していることを示唆し、評価を推奨しました。 コメント ↗
- 懐疑的: あるコメント主は、エージェントが作成したデザインの実用的な使いやすさについて懐疑的な見方を示し、乱雑な出力の手動クリーンアップが、AIを使用することで節約できる時間を相殺することがあると指摘しました。 コメント ↗
- 懐疑的: 別のユーザーは慎重な見解を共有し、そのサイズを考慮するとモデルの能力に懐疑的であるものの、サードパーティのテストが公開された数値を裏付けるかどうかに関心を持ち続けていると述べました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗