13年前のiPad Airや標準的なXiaomi TVボックスで、16BパラメータのMixture-of-Experts(MoE)モデルを毎秒2.6〜5.1トークンの速度で実行できるようになりました。これは「smolmaxxing」プロジェクトによって実現されたもので、低電力デバイス特有のハードウェアのボトルネック(限られたRAM、低速なフラッシュストレージ、基本的なCPU命令)に最適化することで、これまでそのようなハードウェアでは不可能と考えられていた機能を解放しました。
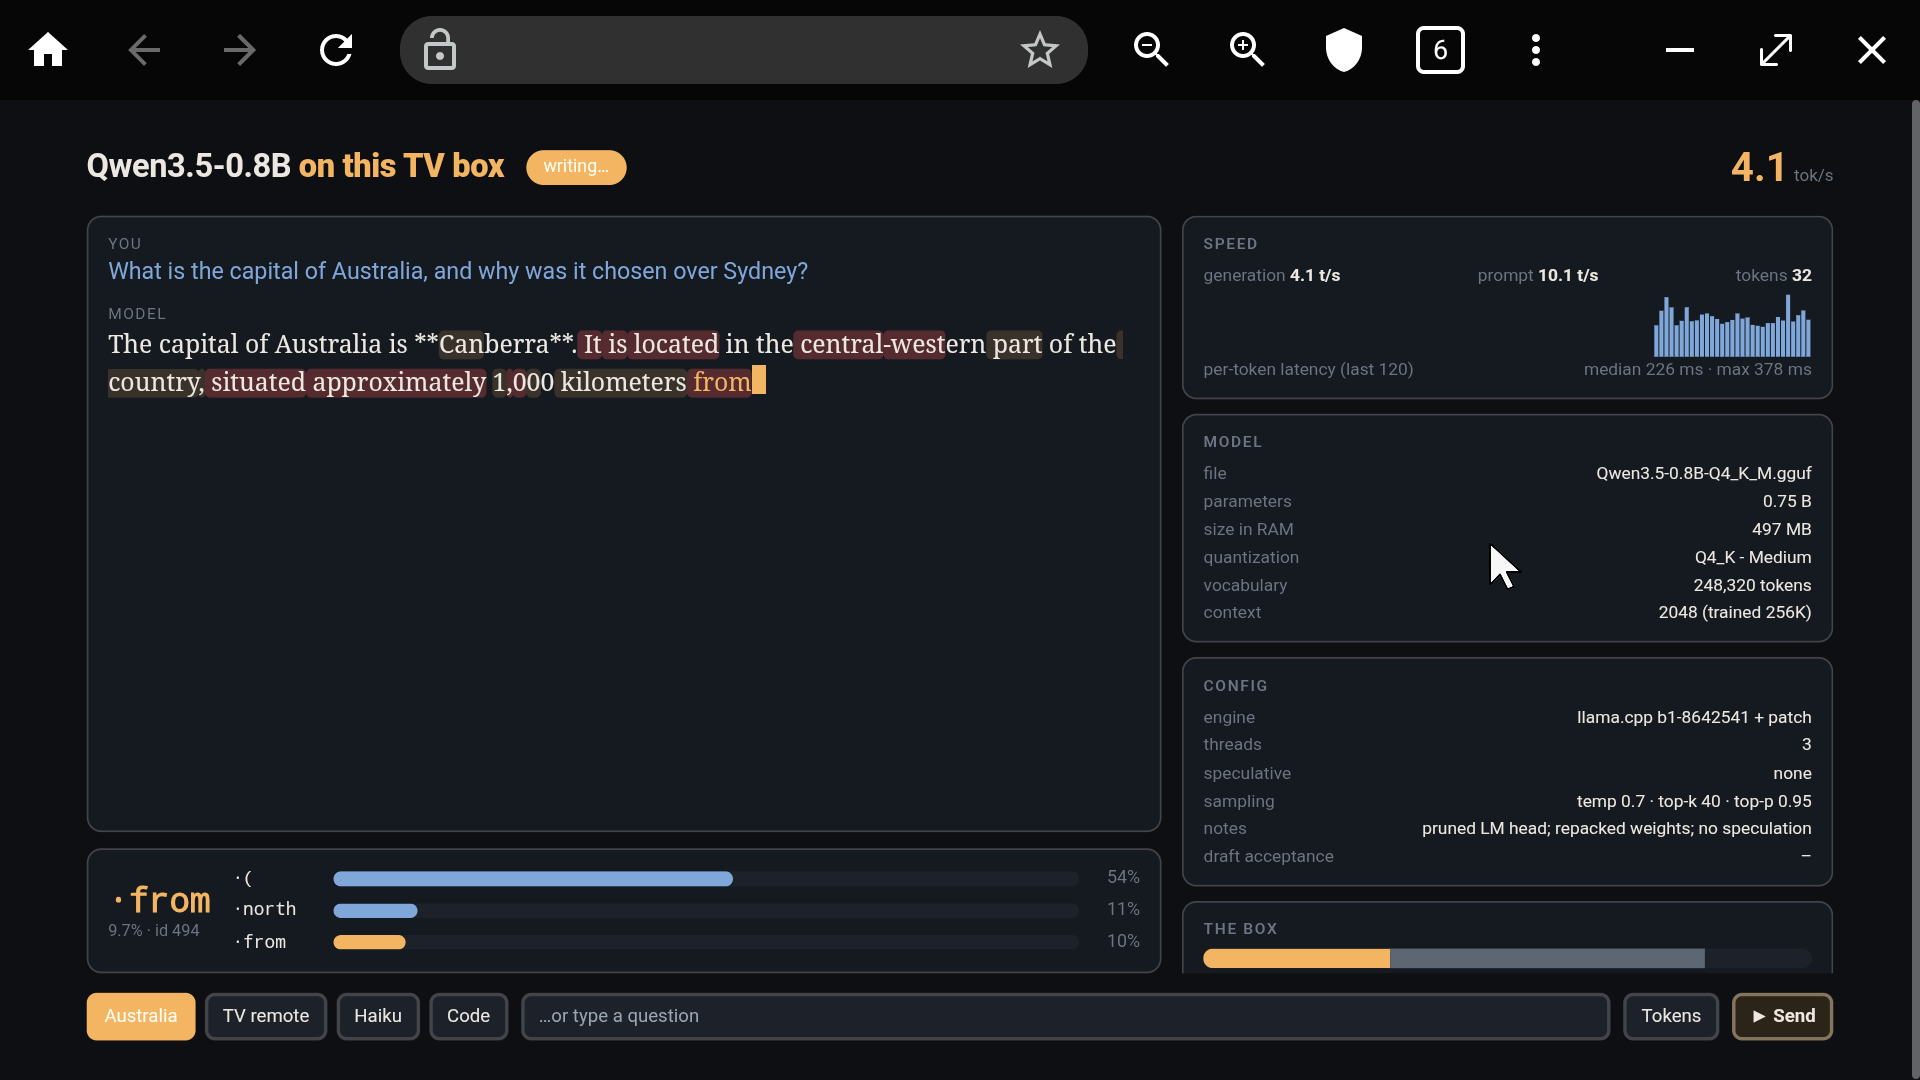
このスクリーンショットは、TVボックスのハードウェア上でのモデル出力の実際のユーザーインターフェースを示しています。
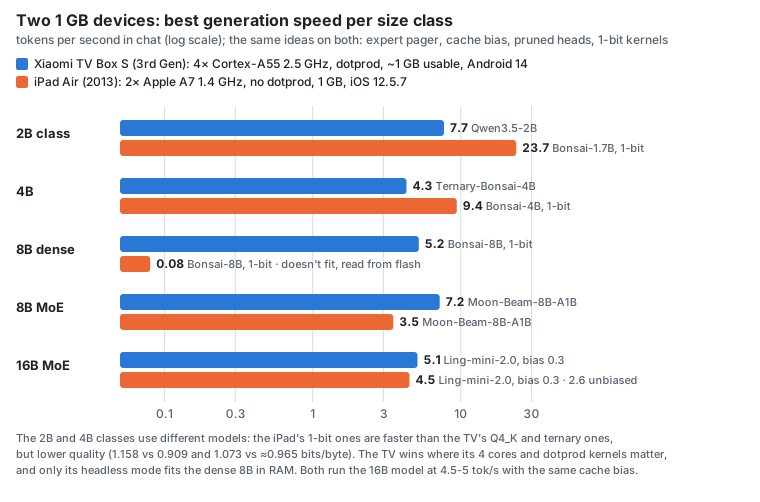
このチャートは、異なるモデルサイズにおけるパフォーマンスの向上を可視化しており、特に両方のデバイスにおける16B MoEモデルの性能を強調しています。
計算とメモリの制限を克服する
Amlogic S7Dチップを搭載し、RAMがわずか1.9GBしかないXiaomi TV Box Sのようなデバイスでモデルを実行するために、このプロジェクトはいくつかの計算に焦点を当てた革新を実装しています。これには、vdotq_laneq命令のためのQ2_Kおよびternaryリパック、1ビットビットプレーン、そしてdotprodサポートを必要とせずに基本NEON命令で動作する特殊な1ビットルックアップテーブルカーネルが含まれます。
メモリの制約は、「ヘッドレス」モードとプルーニングされたLMヘッドによって対処されており、モデルごとに0.2〜0.5GBのRAMを解放できます。これらの最適化により、システムはより大きなフリーメモリプールを維持することができ、これはモデルをディスクに絶えずスワップするのではなく、RAM内に常駐させるために極めて重要です。
「あなたの周りにあるすべてのデバイスは、見た目よりも能力が高いのです。」
— GitHub - hyperionaidev/smolmaxxing: maxxing the ability to run different LLMs on the smallest devices possible
ウェイトストリーミングとエキスパートページング
デバイスの物理RAMよりも大きなモデルに対して、smolmaxxingはO_DIRECTと「expert pager」を備えたウェイトストリーミングエンジンを利用します。このメカニズムは、非エキスパートのウェイトをオンデマンドでフラッシュメモリからページングし、レイヤーを事前にプリフェッチすることでレイテンシを最小限に抑えます。これは、いかなる時点でも全ウェイトのわずか一部だけがアクティブになればよいMixture-of-Experts(MoE)モデルにおいて特に効果的です。
2013年製のiPad Airでは、このアプローチにより16B MoEモデルを毎秒2.6〜4.5トークンの速度で実行することが可能になりました。システムはキャッシュを意識したルーティングと減衰周波数エビクションポリシーを使用することで、最も頻繁に使用されるエキスパートがアクセス可能な状態に保たれるようにし、フラッシュストレージの278MB/sという速度制限による影響を軽減しています。
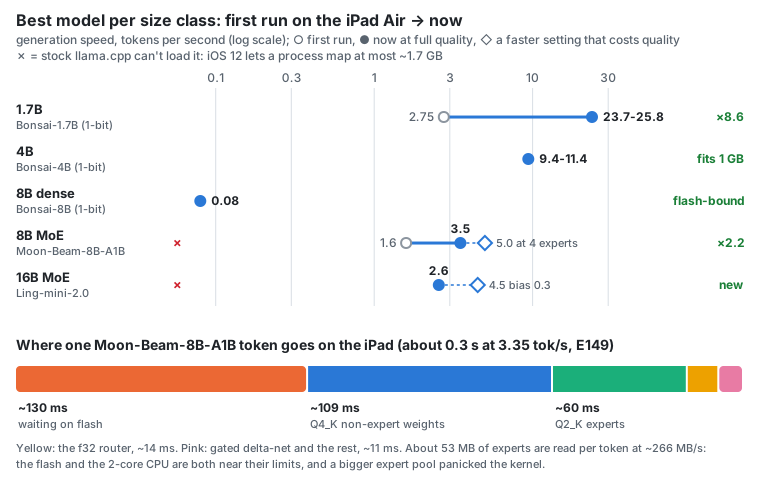
このスコアボードは、16B MoEモデルの速度を含む、iPad Airのパフォーマンスに関する具体的なデータポイントを提供します。
パフォーマンスのトレードオフとボトルネック
このプロジェクトは、2Bパラメータを超えるモデルの場合、主なボトルネックがCPUの計算能力からフラッシュストレージの速度へと移行することを示しています。モデルの生成速度は、デバイスがフラッシュからウェイトをストリーミングする能力によって厳格に制限されます。例えば、TVボックスで動作する9Bモデルは、フラッシュに強く依存しているため、毎秒わずか0.27トークンしか達成できません。
速度と出力品質の間には測定可能なトレードオフが存在します。iPad Airにおいて、Moon-Beam-8B-A1Bモデルのアクティブなエキスパート数を増やすことで、生成速度を毎秒5.0トークンまで高めることができますが、その結果としてパープレキシティが27%増加し、モデルの回答の首尾一貫性が低下することになります。
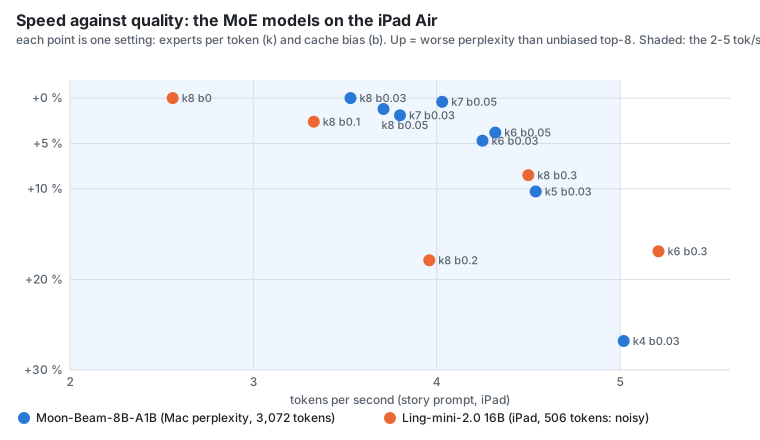
このグラフは、アクティブなエキスパートを増やすことに関する最終段落で言及された特定のトレードオフを例示しています。
Hacker Newsの読者の反応
- 体験談: あるコメント投稿者は、1GB未満のメモリしか持たない第1世代iPad AirやXiaomi TVボックスで16Bモデルの実行に成功した経験を共有しました。 コメント ↗
- 体験談: 別のユーザーは、GPU加速を利用してNintendo Wiiでモデルを実行することに成功した同様の取り組みがすでに存在することに言及しました。 コメント ↗
- 代替案: 数人のコメント投稿者は、古いフラグシップモバイルデバイス、第1世代Raspberry Pi、またはESP32デバイスでこのプロジェクトをテストすることを提案しました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗