開発者がllama-modchipをリリースしました。これは、GPUハードウェアを一切使用せずに、標準的な64GB RAMを搭載したデスクトップ上で284.33BパラメータのDeepSeek-V4-Flashモデルを実行できるソフトウェアフレームワークです。このモデルの標準バージョンは通常64GBのRAMを超え、一般的なワークステーションでOut-of-Memory(OOM)エラーを引き起こしますが、この実装ではモデルのフットプリントを約56.56 GiBまで縮小します。これにより、CPUリソースのみを使用して最大14.7 tokens per second(tok/s)の速度でローカル推論が可能になります。
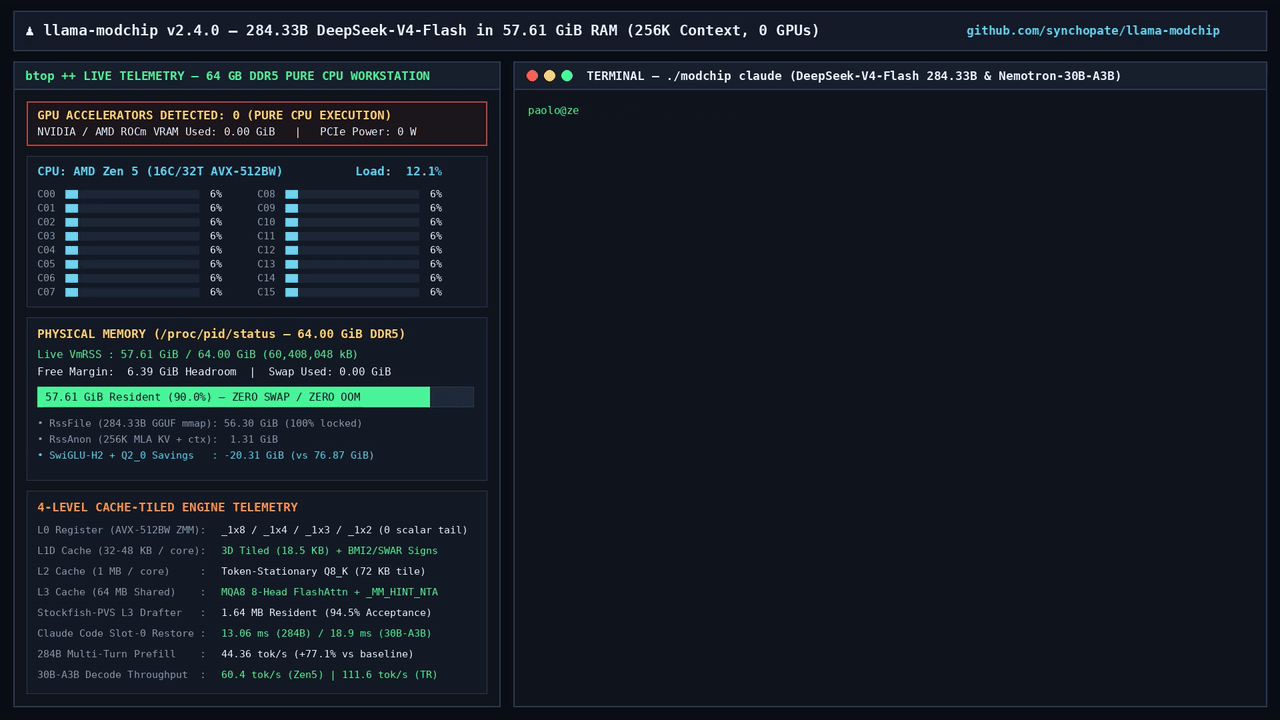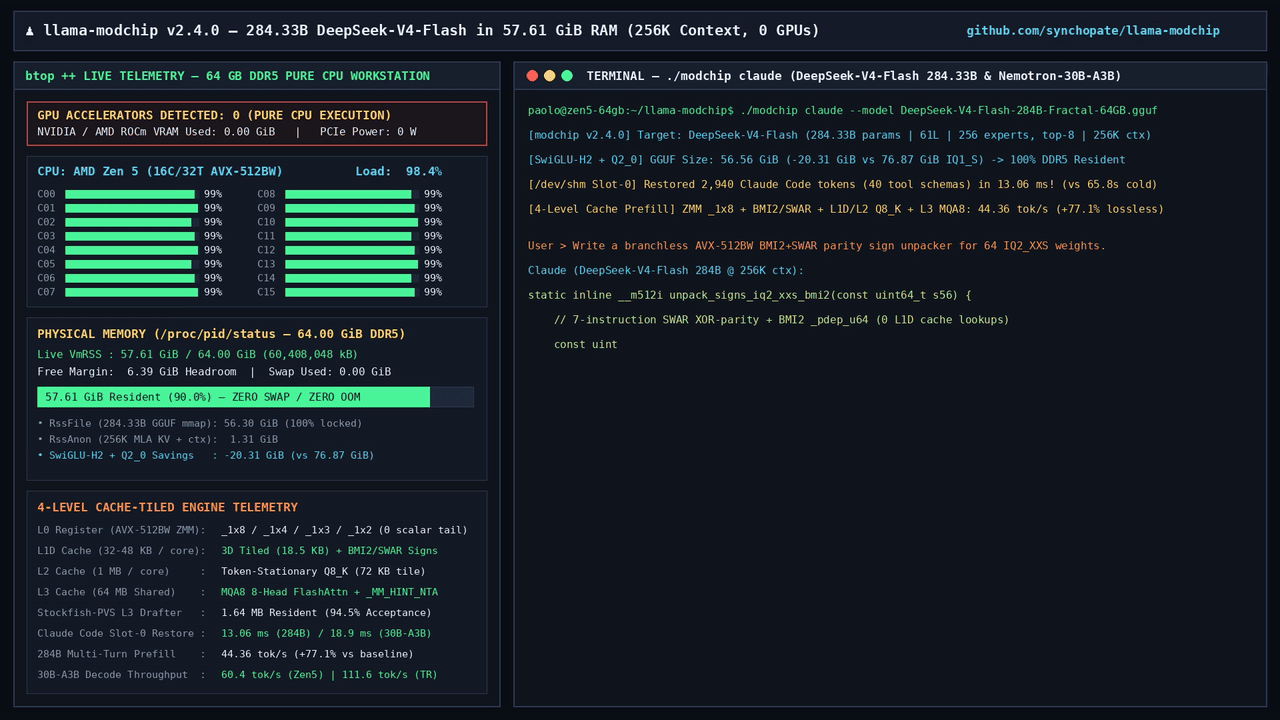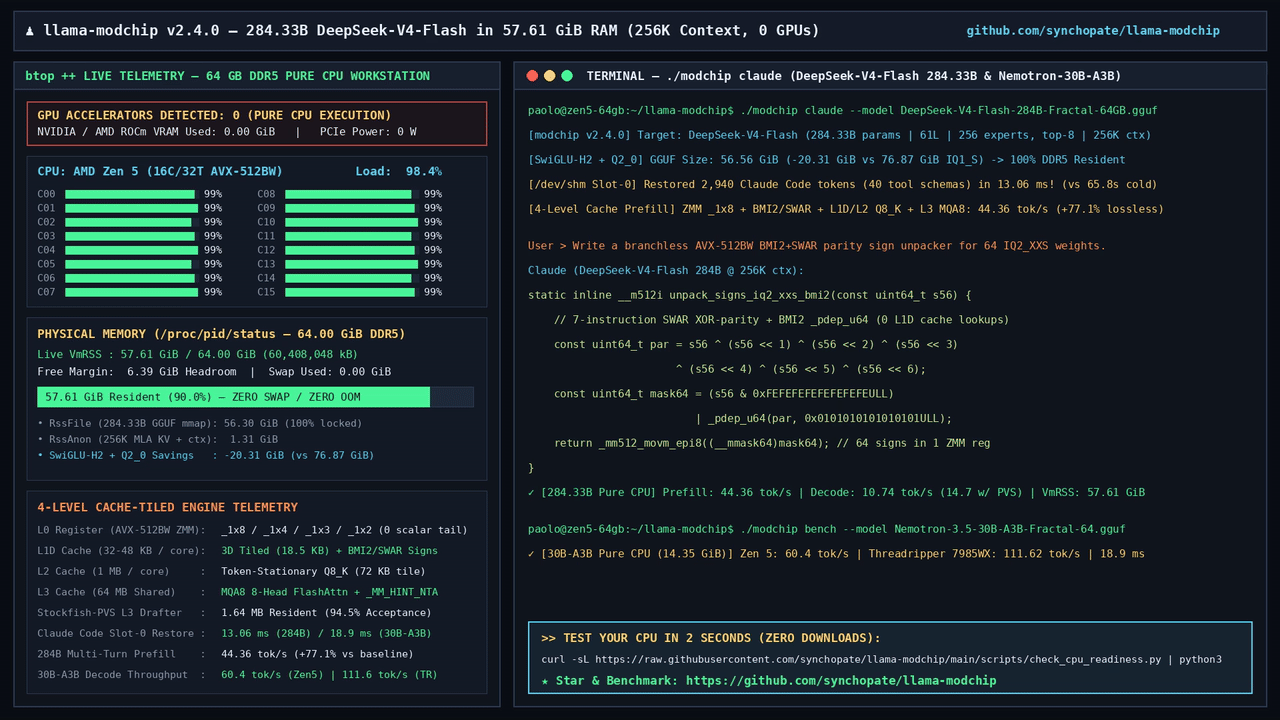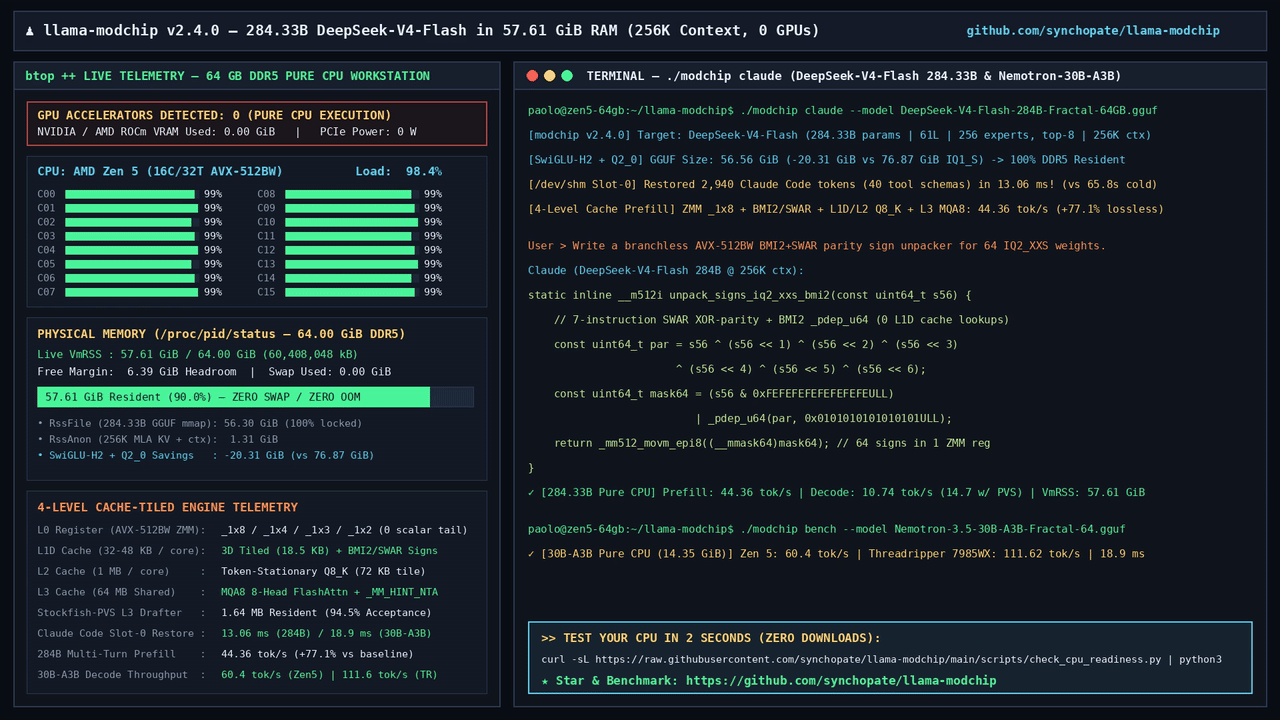
このビジュアルは、プロジェクトの主要な主張である、GPUなしで標準的な64GB RAMデスクトップ上で284Bパラメータのモデルを実行することを実証しています。
メモリ圧縮とアーキテクチャ
llama-modchipが「64GB RAMの壁」を突破できる核心的な能力は、Fractal-64量子化とSwiGLU-H2圧縮にあります。これらの技術により、通常は64GBのLinuxシステムをクラッシュさせるサイズのDeepSeek-V4-Flashモデルを、ディスク上で管理可能な56.56 GiBまで縮小します。
プロジェクトはまた、「Analytical 2nd-Order SwiGLU-H2」および「Fractal-64」MLAトランスコーディングを採用しています。これらの最適化は、モデルのマルチヘッドアテンションレイヤーに必要なメモリオーバーヘッドを劇的に削減しながら、モデルの完全性を維持するように設計されています。
「DeepSeek-V4-Flashを、64GBのLinuxでOOM(メモリ不足)を引き起こす76.87 GiBから、ディスク上で56.56 GiBへ、フル256Kコンテキストで57.61–58.9 GiBのVmRSSへと縮小」
— GitHub - synchopate/llama-modchip: 🐋 Run 284B DeepSeek-V4-Flash (<59GiB RAM, 44.4 tok/s pp, 9.1-14.7 tok/s) & 30B
CPU中心の最適化とタイリング
AMD Zen 5のようなCPUでパフォーマンスを最大化するために、このソフトウェアは4レベルのレジスタタイリング(ZMM AVX-512BW)とL3キャッシュの隔離を使用します。このアプローチは、CPUベースの推論において主要なボトルネックとなることが多い、8チャネルDDR5システムのメモリ帯域幅を飽和させるように設計されています。
システムはまた、出力を予測するために1.64 MBのStockfish-PVS v2 drafterとRouteCrackを利用します。この「drafter」システムにより、CPUは候補となるトークンを生成し、その後検証を行うことで、96.4%の採択率を達成し、標準的なCPU推論よりも高速なデコード速度を実現します。
この画像は、高い採択率と高速な速度を達成するために使用される特定の「drafter」メカニズムを説明しています。
HN Digestによるグラフ(github.comの報告数値に基づく)。数値はソースの表記通り。
実用的な影響とトレードオフ
開発者にとって、このプロジェクトは「Zero-API」のClaude Code統合を提供します。Slot-0 KV Warm Restoreに/dev/shmを使用することで、わずか13.1 msで40のClaude Codeツールのコンテキストを復元でき、CPUベースのエージェントプロンプトで典型的な45秒のボトルネックを大幅に削減します。
しかし、これらの極端な圧縮技術にはトレードオフが伴います。プロジェクトは100/100の「Quality Gate」スコアを主張していますが、3.75 bits per weight(bpw)の量子化を使用すると、非圧縮バージョンと比較してモデルの出力のニュアンスに影響を与える可能性があります。プロジェクトは、$L_2$-Quadratureプルーニングを使用してこれらのトレードオフのバランスをとる「Sweet-Spot」構成を提供しています。
ハードウェアの互換性と制限
Llama-modchipは高い移植性を備えるように設計されており、AMD Zen 4/5、Intelプロセッサ、およびApple Siliconをサポートしています。さらに、Windowsユーザー向けに、利用可能なVRAMを自動的に検出し、GPUとCPUの間でワークロードを分割する「Hybrid」モードも含まれています。
注目すべき制限として、カスタムのFractal-64モデルはOllamaやLM Studioなどの標準的なツールとは互換性がありません。これらはカスタムの「type 40」テンソルを使用するため、正しく機能させるには特定のllama-modchipバイナリまたは提供されているスタンドアロンサーバーを介して実行する必要があります。
Hacker Newsの読者の反応
- 体験談: あるコメントでは、128GBのユニファイドRAMを使用した場合、システムでコーディングエージェントを許容可能な速度で実行でき、プリフィル速度は約300 tokens per secondであったと報告されています。 コメント ↗
- 懐疑的: あるコメントは、出力の品質に対して大きな懐疑心を表しており、モデルをこれほど小さなメモリフットプリントに収めるために必要な極端な圧縮は、おそらくパフォーマンスの低下を招くと示唆しています。 コメント ↗
- 懐疑的: 別のユーザーは、ファイルサイズと量子化レベルに関するプロジェクトのドキュメント内の不整合を指摘し、「去勢された」プルーニング技術によってモデルの性能が損なわれているのではないかと疑問を呈しています。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗