GPT-6 Astraと名付けられた最先端のLLMは、Qwen3.5-0.8Bモデルの重みのわずか0.016%を編集するだけで、MATH-500の精度を7.9%から48.1%に向上させることができました。この成果は「重み空間プログラミング」を通じて達成されました。これは、LLMが特定の重みが何を計算しているかを推論し、従来のトレーニングループや勾配降下法を使用せずにそれらを直接修正する手法です。
思考ループの問題
小型の推論モデルは、同じ数行の推論を際限なく繰り返す「思考ループ」に陥ることがよくあります。Qwen3.5-0.8Bの場合、MATH-500ベンチマークにおける回答の93%が、結論に達することなく32,768トークンの制限に達してしまいました。
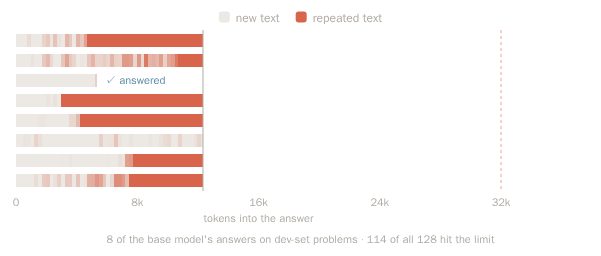
この図は、モデルが推論を際限なく繰り返す「思考ループ」の問題を描写している。
重み空間プログラミングは、これらの挙動の原因となっている特定の重みを特定することでこの問題に対処します。これらの重みを編集することで、開発者は必要な容量が不足しているモデルに新しい能力を訓練させようとするのではなく、モデルが既に備えている能力への障害を取り除くことができます。
この図は、重み空間プログラミングによる実用的な成果を、ナビゲーションタスクの成功を通じて示している。
「Astraは重みのわずか0.016%を変更しただけで、MATH-500の精度は7.9%から48.1%へと跳ね上がりました。」
— Can a Linear Program Do Weight-Space Programming?
重み編集のメカニズム
Transformerは、各層の出力が「残差ストリーム」に加算される残差接続を使用します。モデルがループに陥ると、このストリームは一貫した方向にシフトします。研究者はこれを「ループ方向(u)」と呼んでいます。
編集では、MLP層の重みを修正して、残差ストリームをループとは逆の方向に押し出すようにします。Astraは、層15と19にランク1の変化を適用することでこれを達成し、ループするトークンに対するモデルの出力方向を効果的に反転させました。
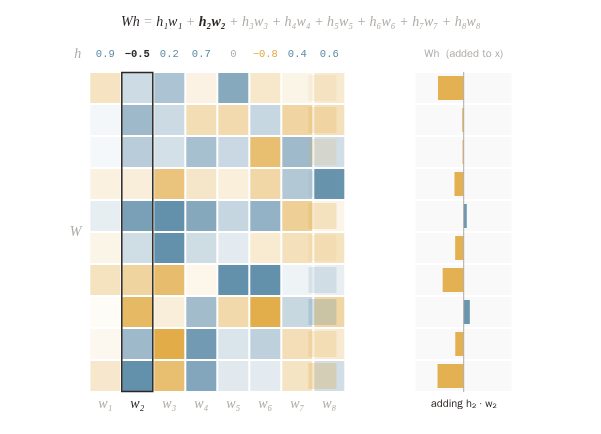
この図は、ループ方向に対抗するためにMLPの重みを修正するメカニズムを説明している。
Astraの手法には試行錯誤的な探索が含まれており、どの重みをどれだけ変更するかを決定するために、約8時間と28回の順伝播を費やしました。
試行錯誤から線形計画へ
最適な重み変化の探索は、線形計画問題として定式化できます。トークンを「ループ中」または「生産的」とラベル付けし、それらの活性化を記録することで、問題は、生産的なトークンにはほとんど影響を与えず、ループ中のトークンをループ方向から遠ざけるベクトル(v)を見つけることになります。
これをL1ノルムの最小化を伴うLPとして解くことで、最も重要な重み列のみを選択して修正するスパースな解が自然に生成されます。Astraの探索には数時間を要しましたが、GPU加速されたLPソルバーであれば、約1分で同等の解を見つけることができます。
テストの結果、LPから導き出された編集は、MATH-500やGSM8KなどのベンチマークにおいてAstraと同等の性能を示しつつ、修正する重みの数は大幅に少なくなりました(Astraの130,188に対し、LPは16,291)。
HN Digest による図表(nathan.rs の報告数値に基づく)。数値はソースの表記通り。
限界とステアリングベクトル
現在のLP法は、特定の層とループ方向ベクトルを特定するために依然としてAstraに依存しています。介入のための最適な層を自律的に選択するまでには至っていません。
興味深いことに、LPによる押し出しはトークン間でほぼ一定であることが判明しました。これは、修正を「ステアリングベクトル」として実装できることを意味します。これは、すべてのトークンにおいて残差ストリームに加えられる固定値です。これにより、恒久的な重み編集と、実行時の推論修正との間のトレードオフが可能になります。