大規模言語モデルにおける推論は、モデルが高次元の「トークン空間」をナビゲートして妥当な結論に到達する経路探索問題として再定義できます。この視点の転換は、単なる次トークン予測を超え、推論の連鎖を、論理的な行き止まりを回避するように設計された動的なナビゲーション戦略として捉えるものです。
トークン経路探索としての推論
この枠組みにおいて、推論はテキストの線形な進行ではなく、可能なトークンの空間を通るナビゲーションタスクです。モデルは正しい答えを目的地として扱い、推論の連鎖をそこに至るまでの経路として扱います。
推論を経路探索と見なすことで、目的は解決策への最も実行可能なルートを特定することになります。これには、トークン空間における複数の潜在的な方向を評価し、論理的一貫性を維持するものを選択することが含まれます。
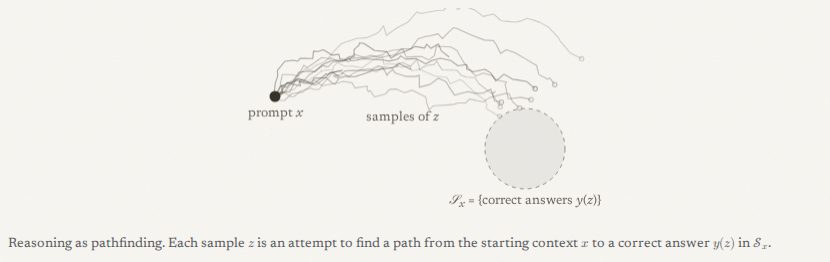
この図は、目的地点に到達するためのトークン空間におけるナビゲーションタスクとしての推論という、この記事の核心的な概念を説明しています。
山登りと論理の回避
ナビゲーションのプロセスは山登りアルゴリズムのように振る舞い、モデルは正解の「頂点」に向かって移動します。このプロセスの重要な部分は、誤った結論へと導く論理的誤謬を特定し、そこから遠ざかることにあります。
このメカニズムの主な利点は、「完全に愚かな」論理的欠陥を防ぐことです。これらのエラーを早期に認識することで、モデルはエラーが残りの出力全体に伝播する前に、推論の経路を転換することができます。
修正のメカニズム
内部的な「思考」を露出するモデルは、「待てよ!」といった自己修正のパターンを示すことがよくあります。これらは、意図した論理的経路からの逸脱を示す内部フラグとして機能し、モデルが障害を回避することを可能にします。
モデルが特定のプロンプトを解決するためにトークン空間をナビゲートしている一方で、トレーニング中にはモデルの重みが最適化されるという並行したプロセスが発生します。これにより、単語のシーケンスを通る経路探索と、基礎となるパラメータを通る経路探索という、二重の経路探索のナラティブが生まれます。
トレードオフと不確実性
このモデルにおける主要なトレードオフは、解決策への経路を露出することと、問題をフラグ立てする能力のバランスです。効果的な推論には、モデルが正しい方向を知っているだけでなく、コースを外れたことを認識することも必要です。
これらの「山登り」の動きの効率を正確に測定する方法は、依然として未解決の問いです。この概念的枠組みは推論を視覚化する方法を提供しますが、モデルが「論理的欠陥」と「正しい経路」をどのように比較衡量しているかについての具体的な指標は、まだ探索の途上にあります。
Hacker Newsの読者の反応
- 代替案: あるコメント投稿者は、推論は解決策を特定する能力と問題をフラグ立てする能力の両方で測定されるべきであり、基本的な論理的欠陥を防ぐことが主要な利点であるように見えると指摘しました。 コメント ↗
- 懐疑的: ある読者は、著者の枠組みが「知能はより多くの推論を通じて必ず向上する」という考えと矛盾しており、再帰的な自己改善に関する仮定を損なう可能性があると主張しました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗