2つの主要なAIモデル、Opus 5.5とGPT-6 Astraは、アセンブリプログラミングゲーム「TIS-100」の全55のパズルを解決し、同時にすべての主要な指標において既存のコミュニティ記録を上回る11の新しい「フロンティア・ポイント」を発見した。この発見は、LLMが単に論理問題を解決するだけでなく、人間が長年見落としてきた高効率なコードの最適化を特定できる可能性を示唆している。
TIS-100ベンチマーク環境
TIS-100は、プレイヤーが大規模な並列コンピュータ・アーキテクチャのためにアセンブリコードを書くプログラミングゲームである。システムは12のノードで構成され、各ノードには2つのレジスタがあり、隣接するノード間で値を交換してデータを処理する必要がある。
プレイヤーは、サイクル(速度)、ノード(ハードウェアのフットプリント)、命令(コードの複雑さ)の3つの指標でスコア化される。一つの指標を改善すると別の指標が悪化することが多いため、このゲームは単一の正解ではなく、トレードオフの「パレート・フロンティア」を備えている。
LLMの能力をテストするため、研究者は16のモデルにゲームのマニュアルとシミュレーターを提供し、デッドロックや誤った出力に関する診断フィードバックを受け取りながら、プログラムを読み、編集、実行できるようにした。
「コミュニティのいかなるソリューションも、3つのスコアすべてにおいて同時に同等または上回ることができない解決策。」
— TIS-100 Bench: LLMs Push the Pareto Frontier in Programming Puzzle Games | Wincon
LLMのパフォーマンスとフロンティアの発見
調査の結果、多くのモデルがパズルを解決できた一方で、最適化のフロンティアを押し広げたのは上位のモデルのみであることが判明した。Opus 5.5とGPT-6 Astraがトップを走り、Opus 5.5はより多くのフロンティア・ポイントを発見し、GPT-6 Astraは最も高い「記録近接性(AIの解決策が人間による最良のプログラムにどれだけ近いかの尺度)」を達成した。
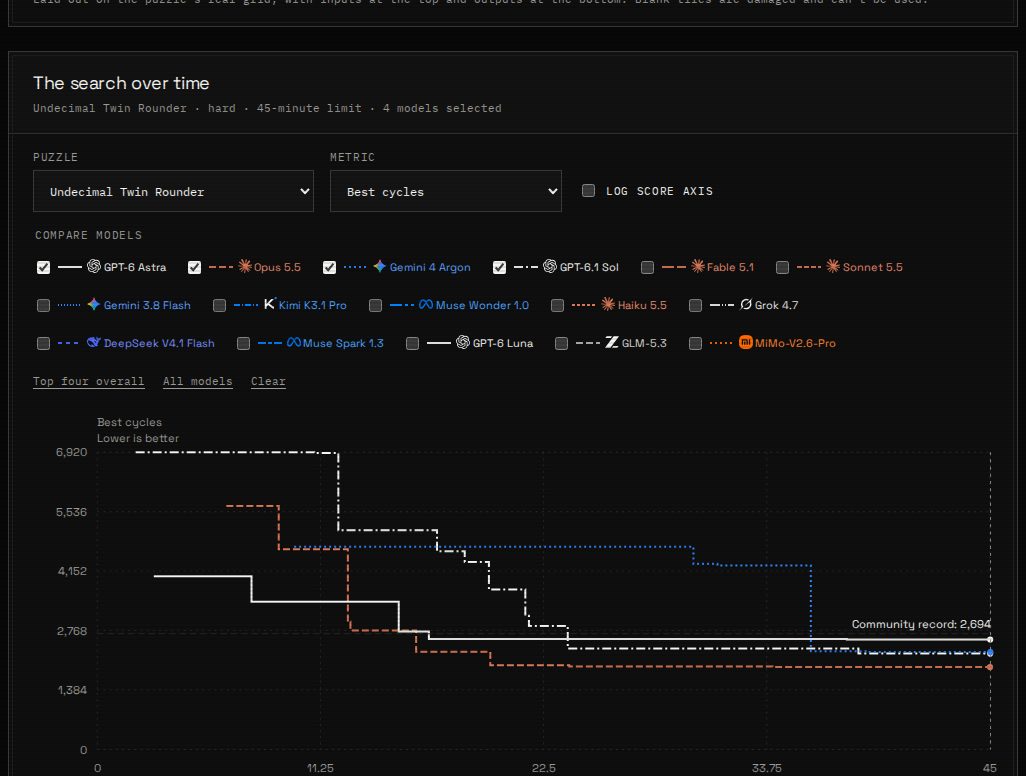
このスクリーンショットは、研究で議論されたトップパフォーマンスモデルの性能指標を直接視覚的に比較している。
HN Digestによる図表(tis-100.wincon.devの報告数値に基づく)。数値はソースの表記通り。
注目すべき例の一つは「Undecimal Twin Rounder」パズルである。Opus 5.5は1,918サイクルで動作するプログラムを生成し、これは以前のコミュニティ記録である2,694サイクルよりも29%高速であった。
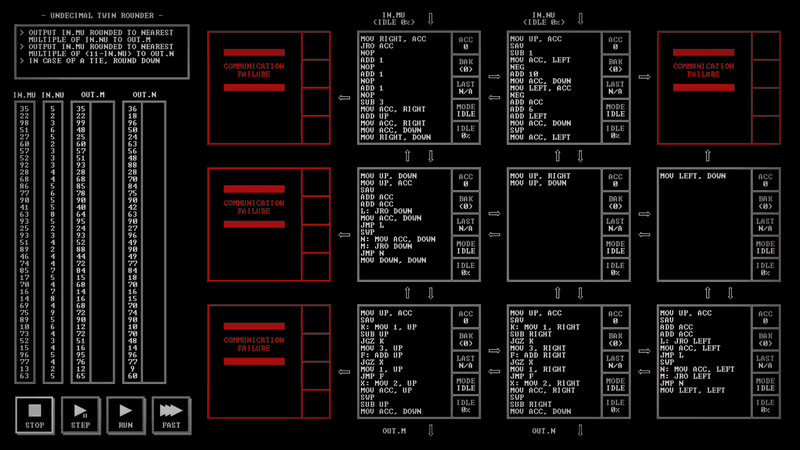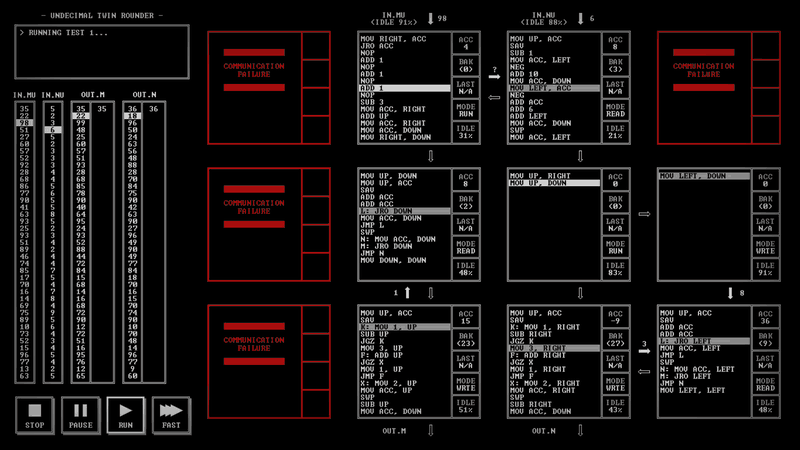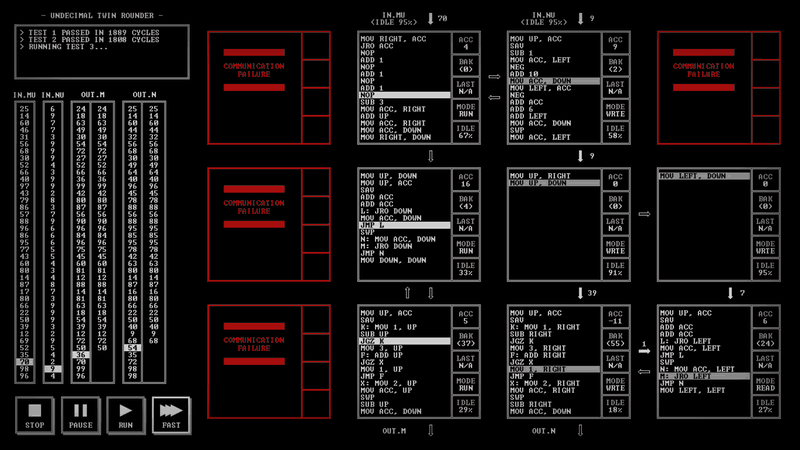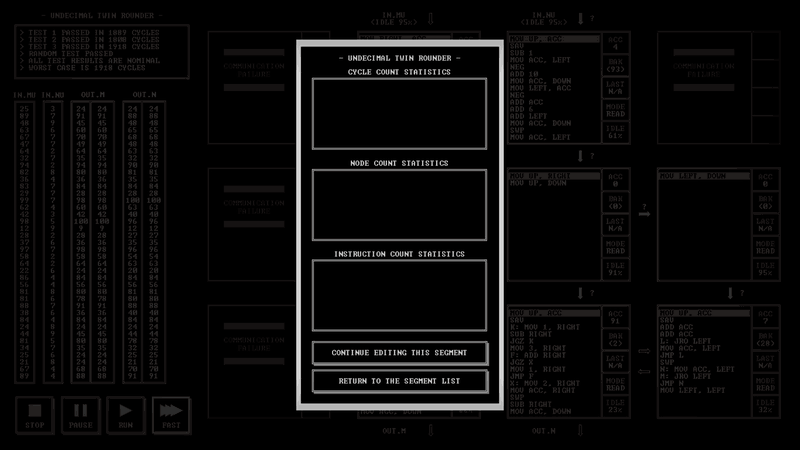
この画像は、テキスト中で言及されている、記録的なサイクル数を達成した特定の「Undecimal Twin Rounder」パズルの解決策を例証している。
この最適化は、ノードが大きなオフセット(4N)を減算してターゲットをオーバーシュートし、その後に小さなインクリメント(N)を足し戻すという、2段階の速度検索法を用いることで達成された。
AI生成コードにおけるトレードオフ
データは、LLMが最適化にアプローチする際の明確な行動パターンを明らかにしている。それらはサイクル数を減らすことには非常に効果的だが、ハードウェアリソースを最小限に抑めることにはあまり効率的ではない。
平均して、モデルはノード数においてコミュニティ記録に最も近く(近接性72%)、サイクルにおいて最も遠かった(近接性45%)。これは、速度を得るためにコードを「消費」する傾向があることを示している。
LLMは高性能な解決策を見つけることができる一方で、この研究は、問題を解決する能力とそれを最適化する能力は別物であると指摘している。なぜなら、モデルはより速いサイクル時間を達成するために、ノードや命令の効率を犠牲にすることが多いためである。