Un investigador con diabetes tipo 1 desarrolló un 'zoológico de modelos' para probar 15 arquitecturas de pronóstico diferentes, descubriendo que los modelos clásicos de aprendizaje automático como XGBoost y LightGBM superan actualmente a los modelos de aprendizaje profundo en la predicción de los niveles de glucosa en sangre a 2 horas vista.
Rendimiento del modelo y evaluación comparativa
La evaluación comparó una amplia gama de modelos, incluyendo regresiones clásicas (ARIMA, SARIMAX), arquitecturas de aprendizaje profundo (LSTM, GluNet) y modelos base a gran escala (Chronos-2, TimesFM 2.5). Las pruebas se llevaron a cabo en dos conjuntos de datos distintos: un conjunto de datos personal de 115 días de datos de monitor de glucosa continuo (CGM) y el conjunto de datos público MetaboNet.
En el conjunto de datos personal, XGBoost lideró con un RMSE de 22.2 mg/dL en el horizonte de 60 minutos. El transformer personalizado del autor, T1DMAI D16 DILATE, le siguió de cerca en tercer lugar con un RMSE de 22.8 mg/dL. En el conjunto de datos MetaboNet, aunque XGBoost siguió siendo el líder, el modelo T1DMAI logró el RMSE más bajo de todos los modelos probados en la marca de 90 minutos.
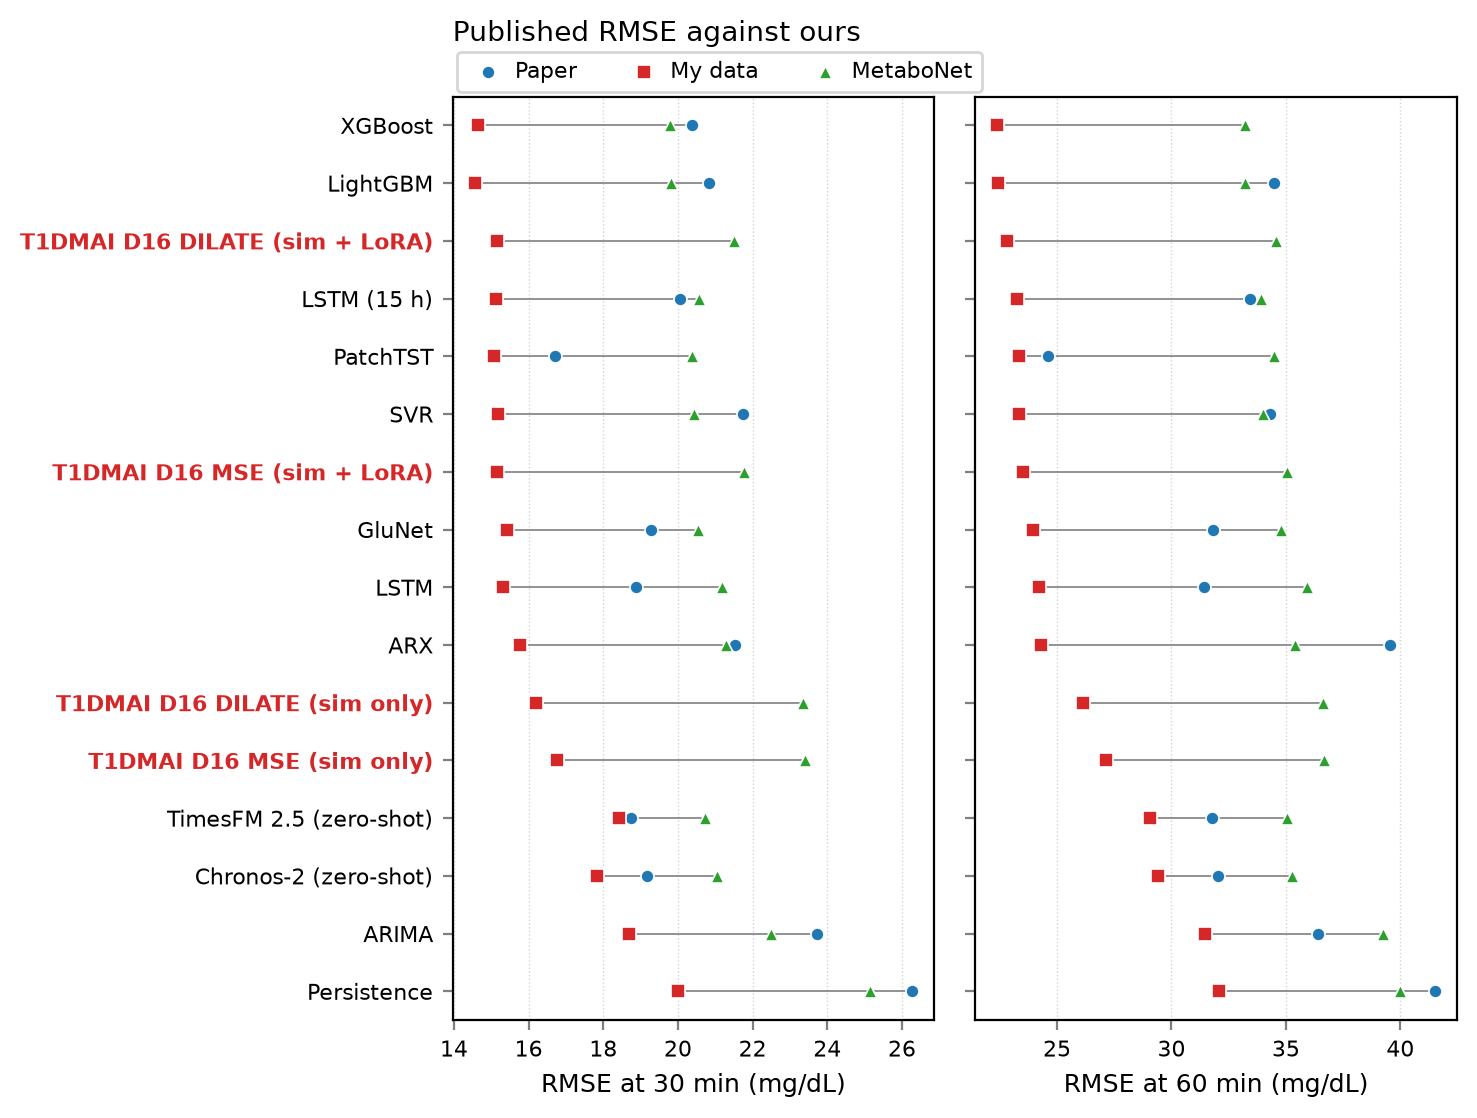
Esta figura ilustra los principales resultados de la evaluación comparativa donde se comparan XGBoost y el modelo personalizado T1DMAI frente a otras arquitecturas.
“Todos los modelos son malos. XGBoost es el mejor, pero mi propio modelo se acerca.”
— GitHub - 0xdeadf1sh/T1DMAI: A model zoo of blood glucose forecasters trained & tested on my own data
Arquitectura y metodología de entrenamiento
El modelo T1DMAI es un transformer de solo codificador diseñado para la eficiencia, que utiliza 16 capas de ancho 16 y un total de 31,253 parámetros. Procesa datos de CGM, curvas de absorción de carbohidratos y curvas de acción de la insulina para generar siete cuantiles (que representan el rango del 5% al 95%) para cada paso de 5 minutos en una ventana de 2 horas.
Para mejorar el rendimiento, el investigador utilizó un adaptador de Adaptación de Bajo Rango (LoRA), un pequeño componente de 3,771 parámetros, para ajustar los modelos con datos de entrenamiento reales. Este adaptador mejoró significativamente la precisión, reduciendo el RMSE de 60 minutos en el conjunto de datos personal de 26.1 mg/dL a 22.8 mg/dL.
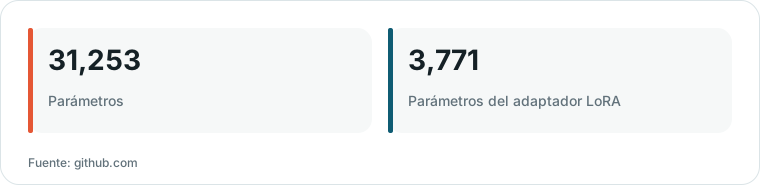
Gráfico elaborado por HN Digest a partir de cifras reportadas por github.com; los valores se muestran como aparecen en la fuente.
Compensaciones en complejidad y velocidad
Existe una compensación significativa entre el costo computacional de los modelos base y la velocidad de los modelos clásicos. Mientras que los modelos base como Chronos-Bolt mini contienen más de 21 millones de parámetros y requieren varios segundos por pronóstico, el modelo T1DMAI puede realizar inferencias en aproximadamente 5.6 a 7.3 milisegundos.
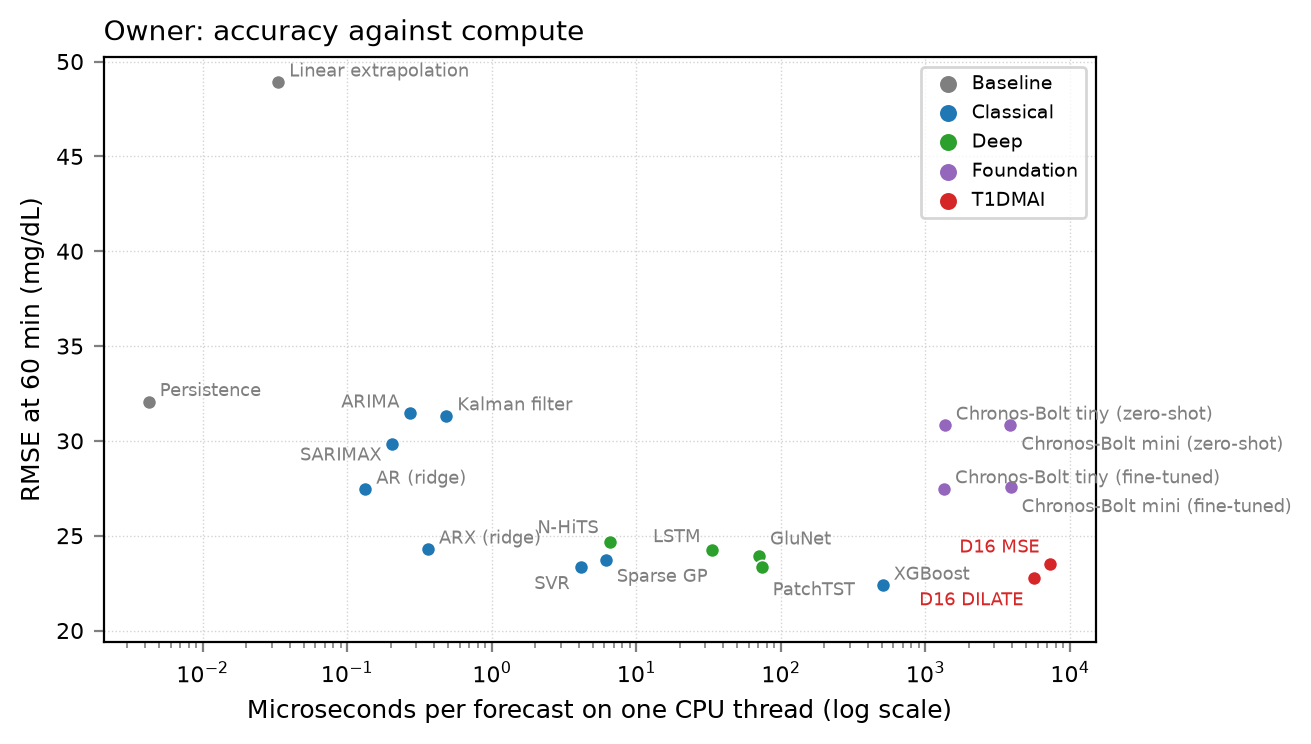
Esta imagen apoya la discusión sobre la eficiencia del modelo T1DMAI en comparación con modelos base más grandes.
A pesar de la alta precisión de algunos modelos de aprendizaje profundo, el investigador señaló que muchos de los modelos con bajo RMSE no lograron detectar las 'bajadas' (eventos de hipoglucemia) en el conjunto de datos MetaboNet, donde la extrapolación lineal en realidad funcionó mejor para detectar esos eventos específicos. Esto resalta la dificultad de equilibrar la precisión general con la detección de eventos clínicos críticos y poco frecuentes.
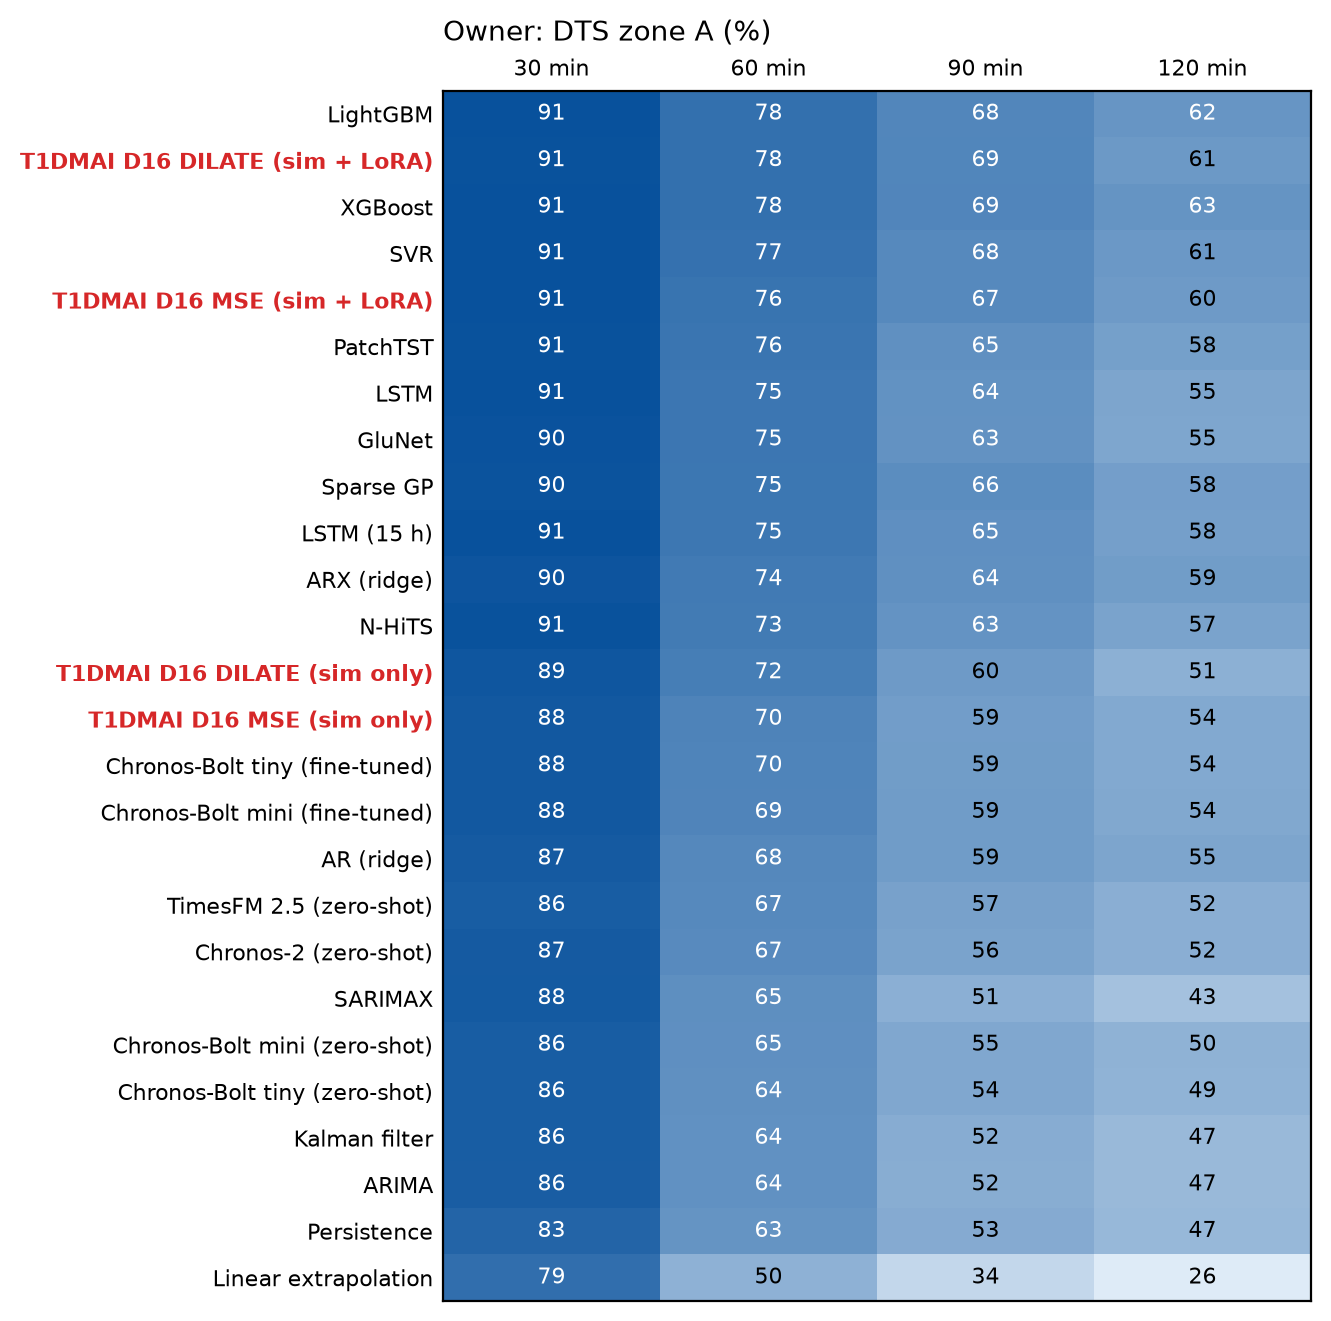
Esta visualización ayuda a explicar la dificultad de equilibrar la precisión general con la detección de eventos clínicos específicos como las bajadas de hipoglucemia.
Limitaciones de la investigación y seguridad
El estudio está actualmente limitado por un tamaño de muestra pequeño para los datos personales (N=1 durante 35 días) y por el hecho de que los modelos son artefactos de investigación. El investigador declara explícitamente que el software no es un dispositivo médico validado clínicamente y no debe usarse para tomar decisiones médicas, diagnósticas o de tratamiento.
Los resultados también muestran que el rendimiento del modelo varía significativamente entre diferentes sujetos. Por ejemplo, en el conjunto de datos MetaboNet, la banda de predicción del 90% mantuvo la verdad entre el 75-78% de las veces para algunos modelos, mientras que alcanzó el 81-85% al usar el adaptador LoRA.
Qué dicen los lectores de Hacker News
- Alternativa: Un comentarista compartió su experiencia personal construyendo un panel personalizado para correlacionar carbohidratos, insulina, sueño y datos de movimiento para gestionar su propia salud. comentario ↗
- Pregunta abierta: Un lector cuestionó si los modelos incorporan información dietética específica y solicitó aclaraciones sobre cómo se procesan esos datos. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗