En el modelo de lenguaje Qwen3-1.7B, una sola conversación no es un único punto de datos, sino una secuencia de estados internos donde cada token está representado por un vector de 2,048 números. Al mapear miles de estos estados en una proyección tridimensional, los investigadores descubrieron que las conversaciones en inglés ocupan una forma geométrica notablemente plana, con el 99.3% de su variación contenida dentro de un único plano 3D.
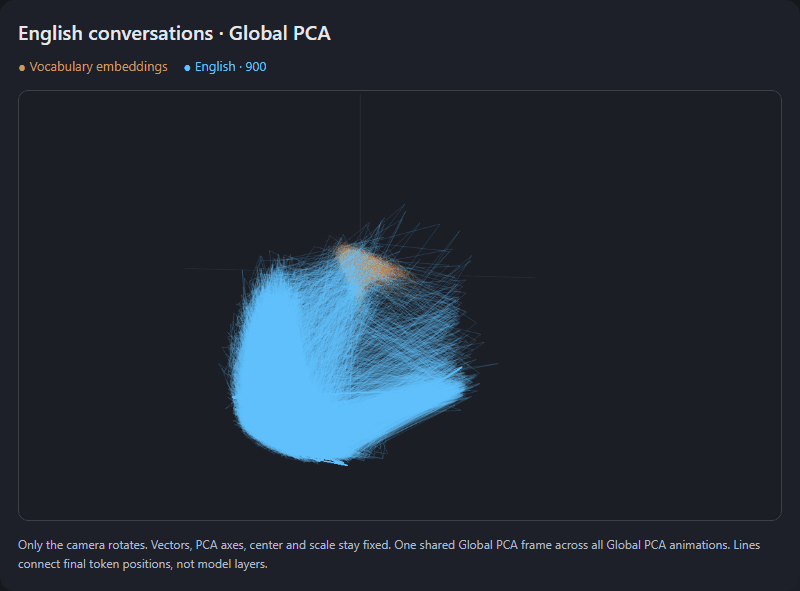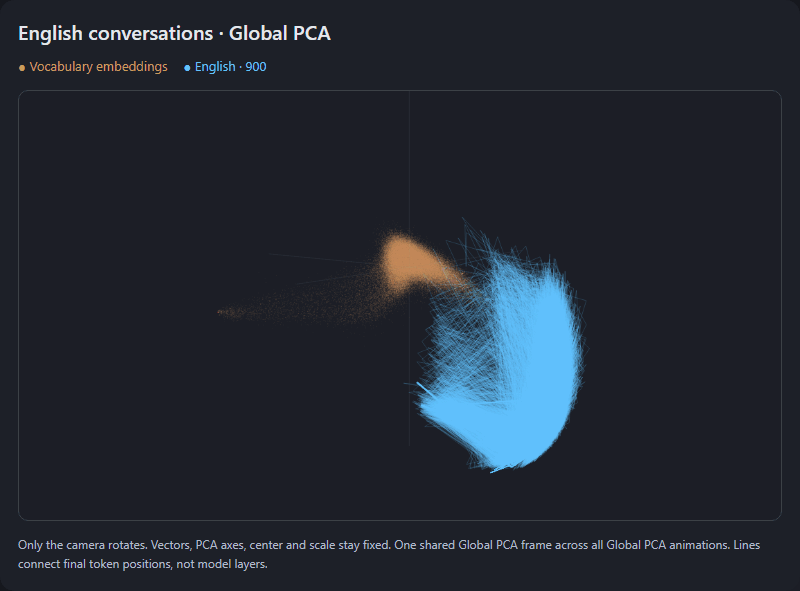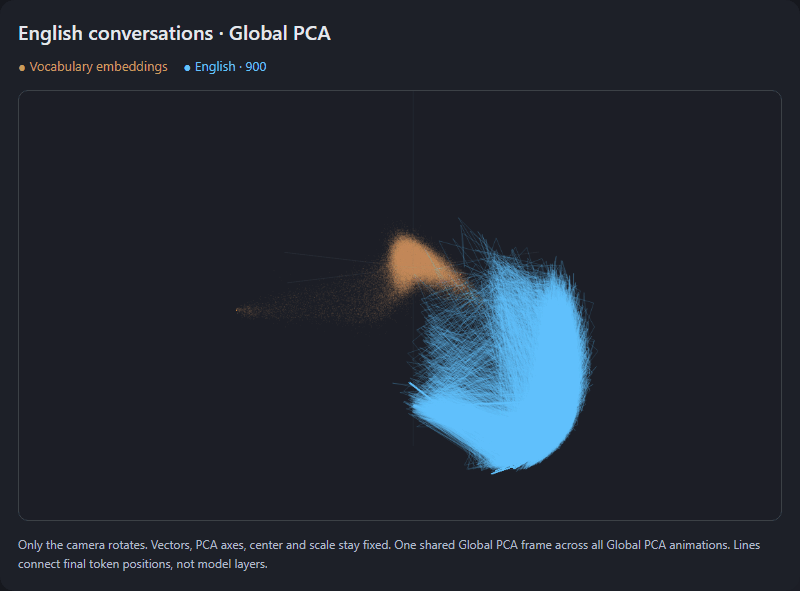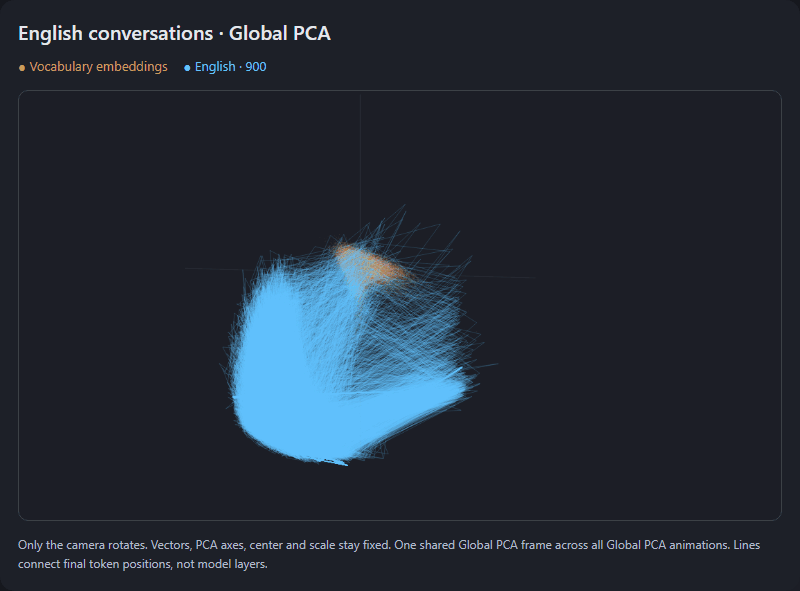
Esta animación ilustra el hallazgo de que los estados de conversación en inglés están altamente comprimidos en una fina lámina geométrica.
El flujo residual como un espacio de trabajo compartido
El estudio se centra en el 'flujo residual', que sirve como el espacio de trabajo compartido central donde un modelo de lenguaje procesa el texto. Cada token —ya sea una palabra, parte de una palabra o un signo de puntuación— comienza como un vector aprendido de una tabla de embeddings y luego es refinado por las capas del modelo basándose en el contexto circundante.
Al registrar estos estados finales de los tokens y normalizar sus longitudes, los investigadores pudieron visualizar las 'rutas' que una conversación toma a través de las representaciones internas del modelo. Estas rutas revelan cómo el modelo transforma los embeddings iniciales en estados conscientes del contexto.
“La geometría por sí sola no podría desenredar esas posibilidades.”
— What thousands of conversations look like inside a language model
Geometría lingüística y separación de idiomas
El mapeo reveló comportamientos espaciales distintos para diferentes idiomas. Mientras que los estados en inglés formaron una lámina delgada, los estados en chino aparecieron en una región vecina, visiblemente desplazada del grupo del inglés. Esto sugiere que las representaciones internas del modelo portan información tanto sobre el tema como sobre la forma lingüística específica utilizada para expresarlo.
El alemán y el croata ocuparon un vecindario amplio que se superpone con el inglés, lo que sugiere una estructura geométrica compartida entre estos idiomas de alfabeto latino. Sin embargo, los investigadores señalaron que la densidad de estas regiones estaba influenciada por la construcción de los datos; por ejemplo, las respuestas en croata contenían más tokens, lo que resultó en un parche de puntos más denso que no necesariamente indica una mayor capacidad del modelo.
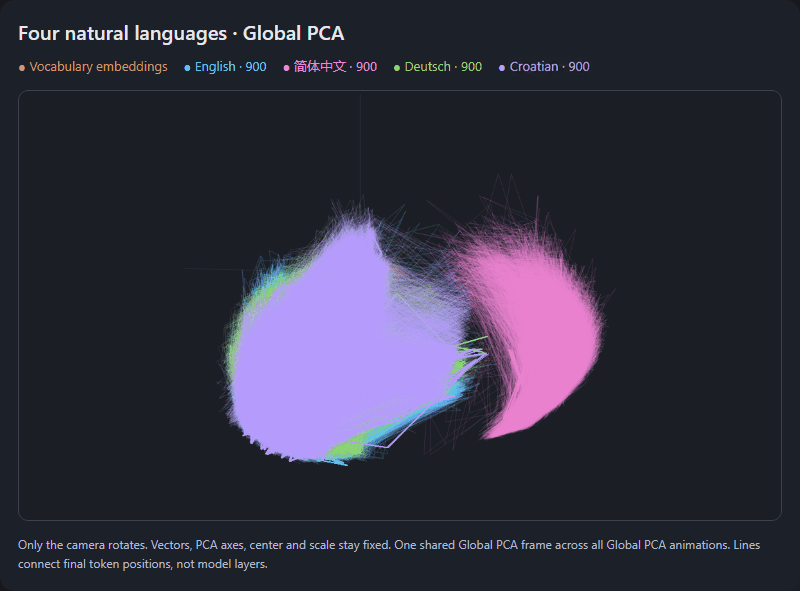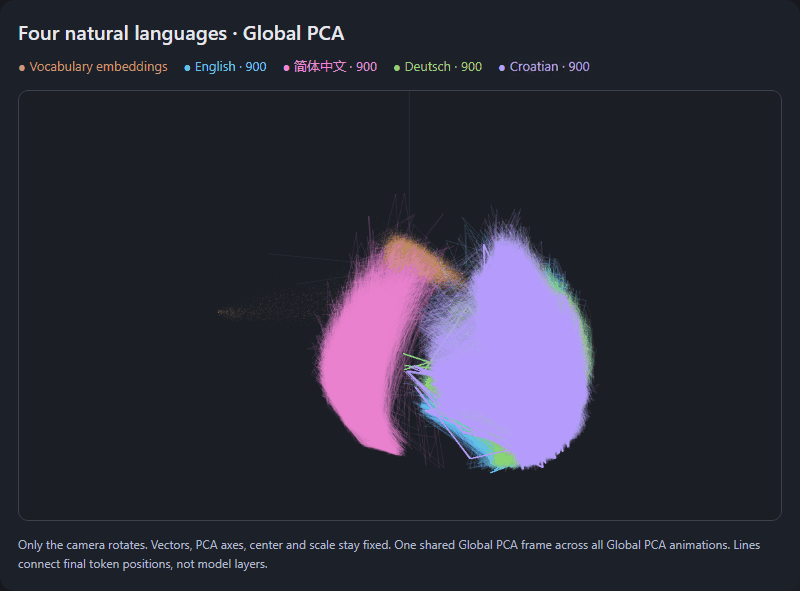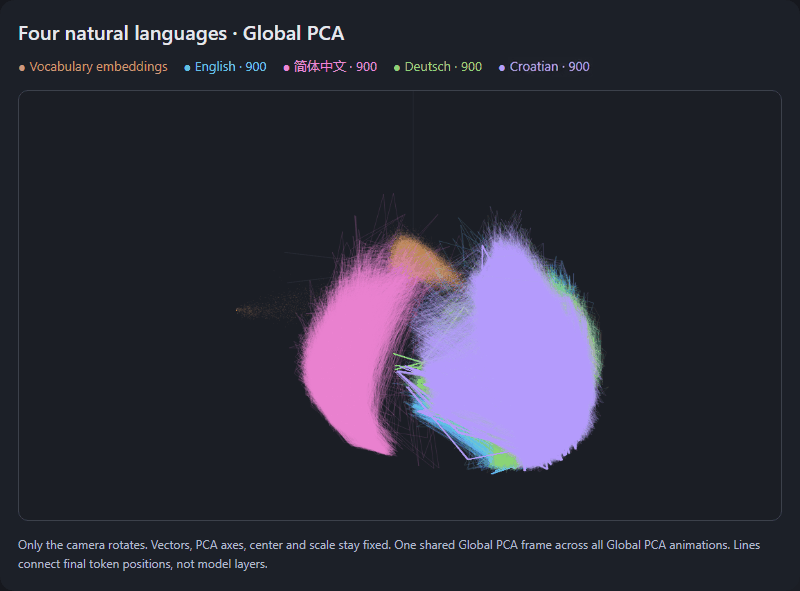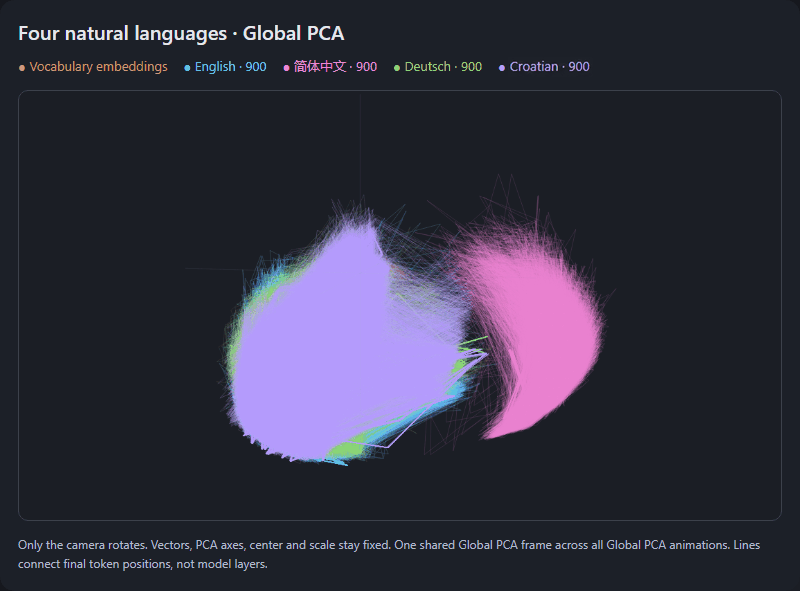
La animación demuestra los comportamientos espaciales distintos y las superposiciones entre diferentes idiomas en el flujo residual del modelo.
Código y el marco orientado al vocabulario
Cuando se introdujeron ejemplos de programación en Python, aparecieron en el mismo vecindario amplio que los conjuntos de datos de lenguaje natural. Curiosamente, una simple comparación de distancias mostró que el conjunto de datos de programación estaba numéricamente más cerca del alemán y del croata que del inglés, a pesar de que tanto el código como el inglés comparten palabras clave y estructuras similares.
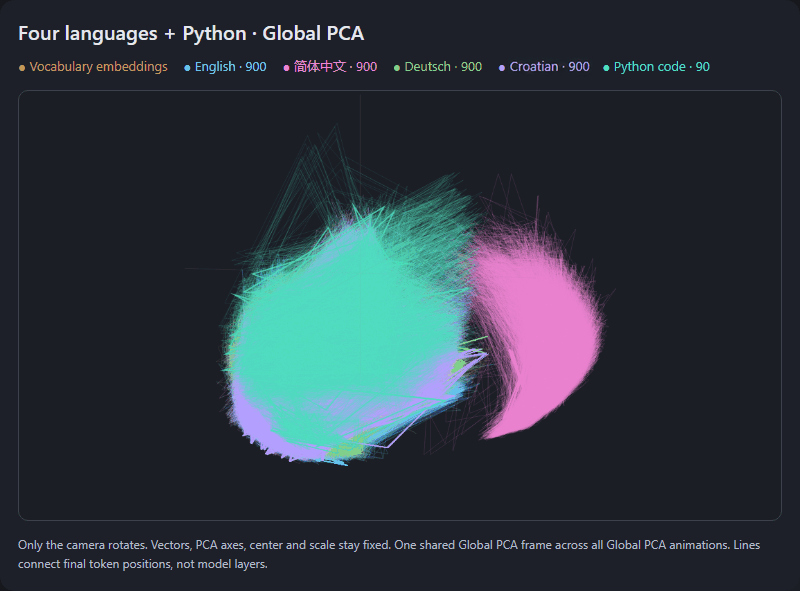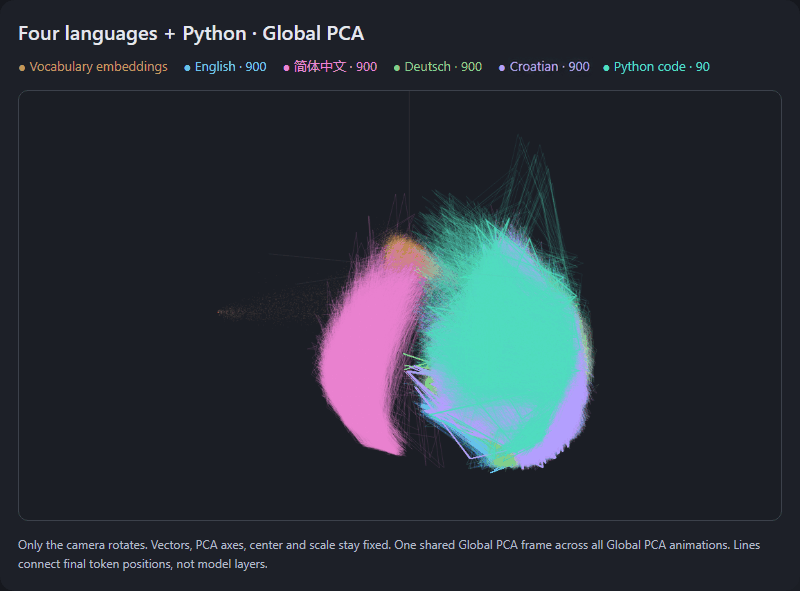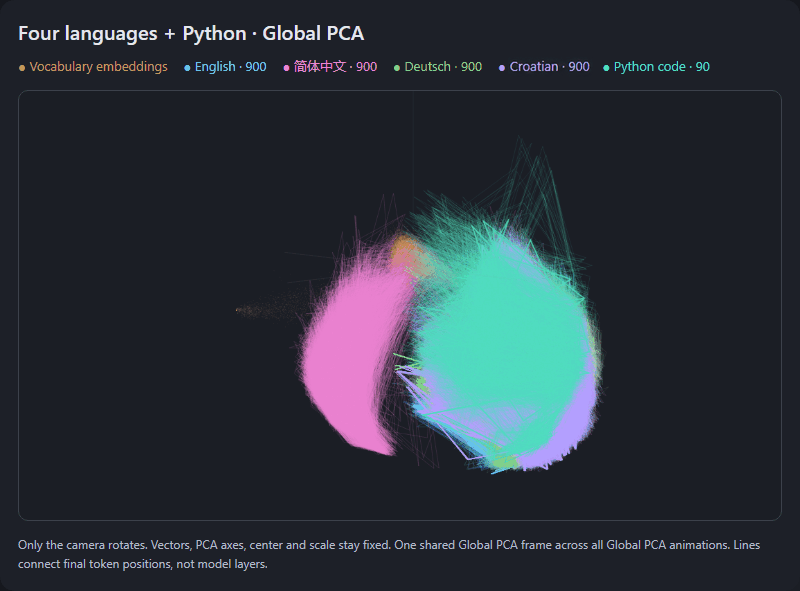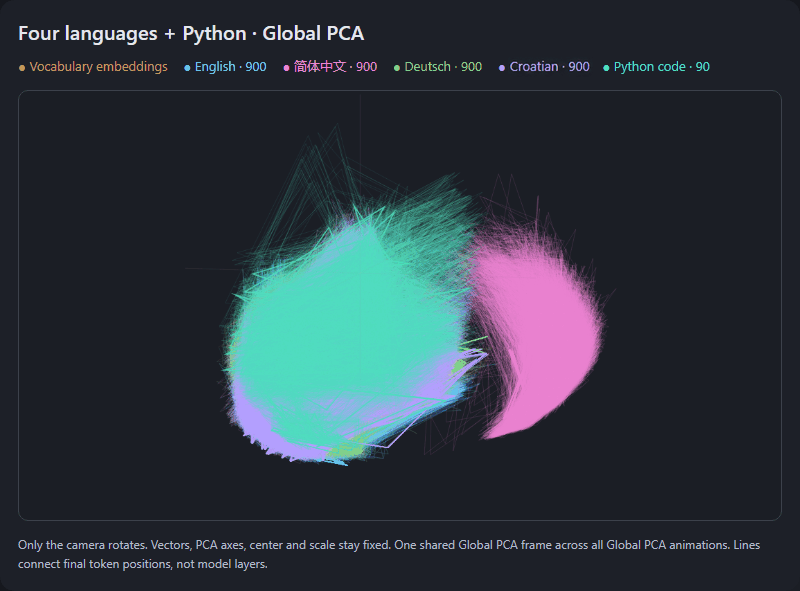
Esta visualización ayuda a explicar cómo los ejemplos de programación en Python residen en el mismo vecindario amplio que los conjuntos de datos de lenguaje natural.
El estudio también demostró que el 'mapa' de estos estados internos depende en gran medida de la perspectiva del observador. El uso de un 'Conversation PCA' —que optimiza la variación entre los promedios de conversación— reveló regiones más distinguibles para el alemán y el croata que el marco 'Global PCA', el cual estaba fuertemente influenciado por los 151,936 embeddings de vocabulario.
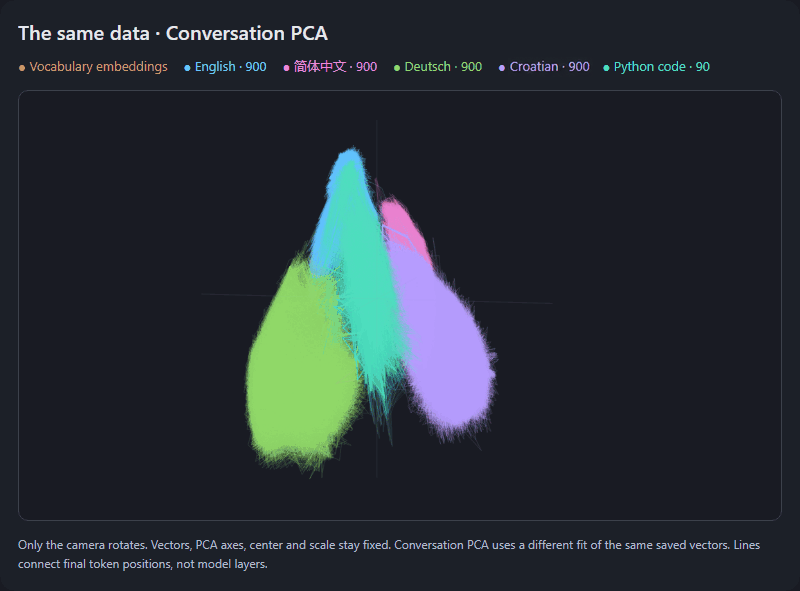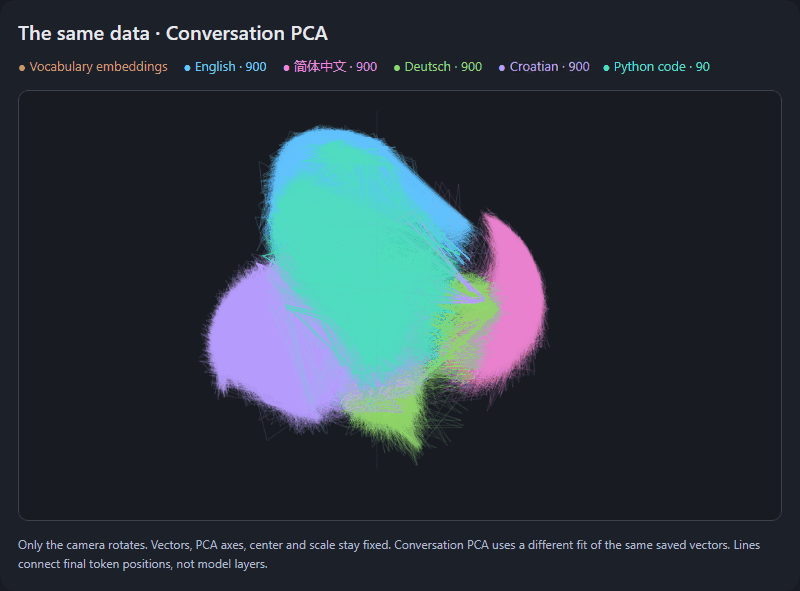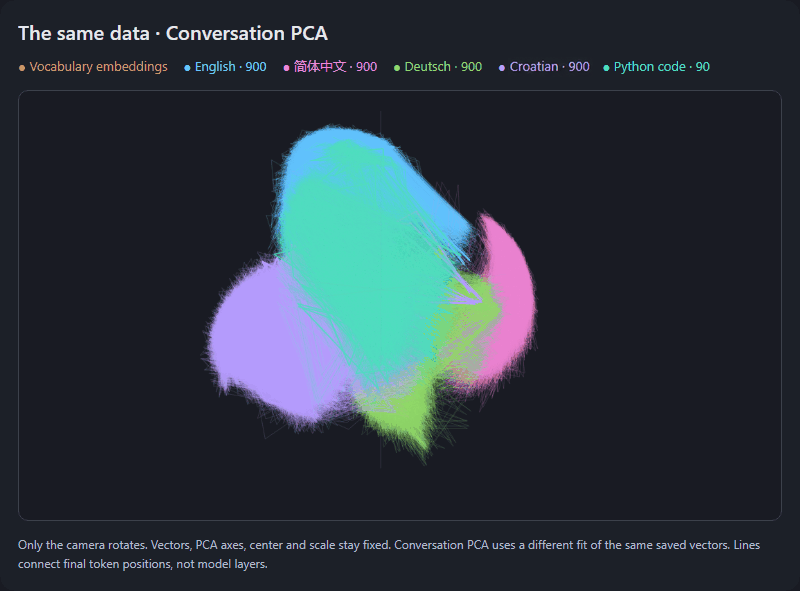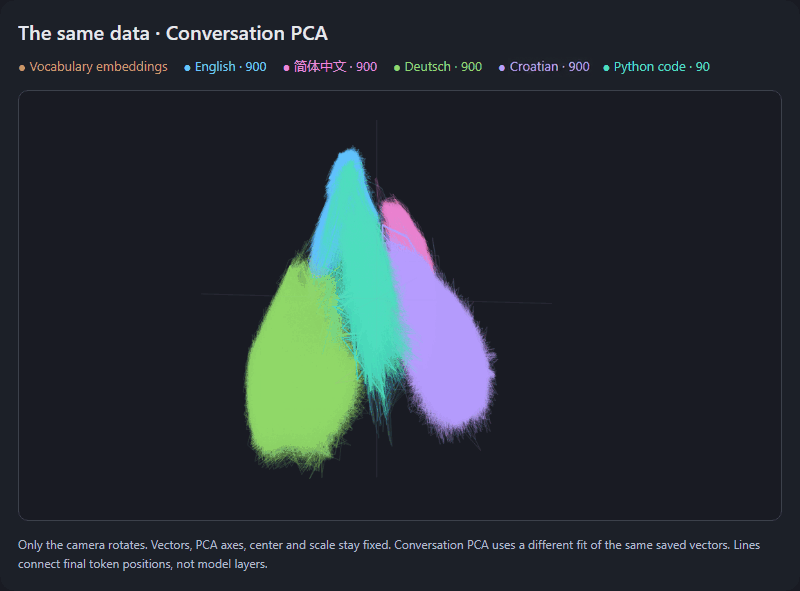
Esta visualización demuestra cómo el 'mapa' de los estados internos cambia cuando la perspectiva del observador se desplaza hacia Conversation PCA.
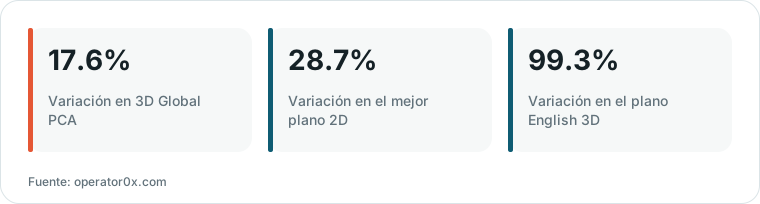
Gráfico elaborado por HN Digest a partir de las cifras reportadas por operator0x.com; los valores se muestran tal como aparecen en la fuente.
Limitaciones de las proyecciones 3D
Si bien las visualizaciones en 3D proporcionan una mirada clara a la geometría interna del modelo, representan una reducción significativa de los datos reales. Los investigadores descubrieron que la vista en 3D capturó solo el 17.6% de la variación total en los estados de tokens de 2,048 dimensiones, lo que significa que más del 82% de la variación interna del modelo permanece invisible en la proyección.
Además, el estudio utilizó una muestra pequeña y deliberadamente construida de 100 temas y 90 ejemplos de programación. Si bien esto proporcionó un entorno controlado para observar la geometría lingüística, es posible que no capture completamente la vasta diversidad de las capacidades del modelo a través de todo el conocimiento humano y los tipos de conversación posibles.