Investigadores de la Universidad Simon Fraser (SFU) han desarrollado un método que permite a los usuarios manipular la iluminación en una fotografía con la misma precisión que se encuentra en las herramientas de gráficos 3D como Blender o Unreal Engine. Al alejarse de los modelos de IA generativa de 'caja negra' que adivinan la iluminación basándose en instrucciones, este sistema permite a los creadores colocar y ajustar tipos de luz específicos —como luces de foco, luces puntuales o iluminación ambiental— directamente dentro de una escena.
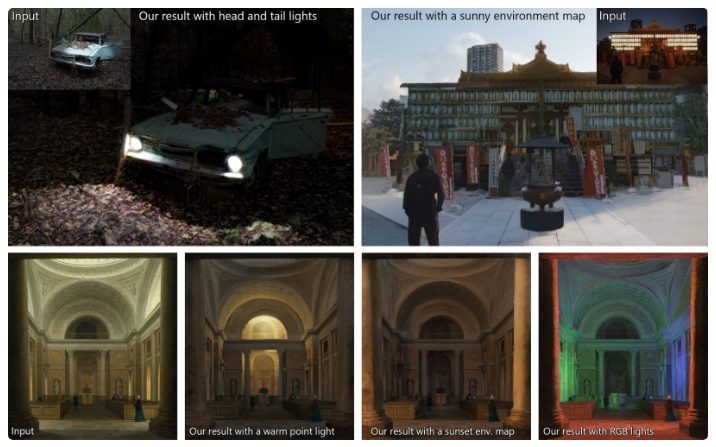
Esta imagen ilustra la capacidad central del sistema para manipular la iluminación manteniendo la precisión física.
Más allá de las 'cajas negras' de la IA generativa
Las herramientas actuales de IA generativa a menudo tienen dificultades con la reiluminación porque dependen de redes neuronales a gran escala para predecir cómo podría interactuar la luz con una escena. Esto a menudo resulta en resultados impredecibles donde la IA puede desviarse del contenido original de la fotografía, obligando a los usuarios a entrar en un ciclo de ingeniería de prompts y ensayo y error.
El enfoque de la SFU reemplaza esta conjetura con un control físico explícito. Al simular la física de la luz, los investigadores aseguran que el resultado de la reiluminación sea una representación físicamente precisa de la visión creativa específica del usuario.
“Al simular las luces, nos aseguramos de que nuestro resultado sea una representación físicamente precisa de la iluminación deseada por el usuario.”
— CS Researchers Develop A New Tool That Brings Blender-like Lighting Control to Any Photograph
El flujo de trabajo de reconstrucción y renderizado
El proceso comienza infiriendo una representación de malla coloreada de una escena a partir de una sola fotografía. Este modelo 3D captura la forma y los colores de la superficie de los objetos mientras elimina intencionadamente la información de iluminación original.
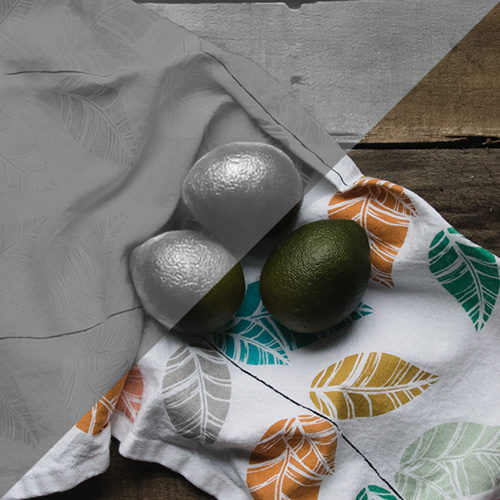
Esta visualización apoya la explicación técnica de la fase de reconstrucción donde se establecen los modelos 3D.
Una vez establecida la escena en 3D, los usuarios pueden colocar fuentes de luz virtuales en el entorno. Un motor de trazado de rayos simula entonces estas luces para crear una vista previa aproximada de la escena. Finalmente, un renderizador neuronal de alimentación directa transforma esa vista previa aproximada en una fotografía fotorrealista, combinando la precisión física con una apariencia de alta fidelidad.
Entrenamiento y aplicaciones futuras
Para asegurar que el sistema funcione en imágenes diversas del mundo real, el equipo desarrolló una metodología de entrenamiento auto-supervisado. Esto utiliza renderizado diferenciable para reconstruir la iluminación de la escena, permitiendo que el renderizador neuronal sea entrenado en colecciones de imágenes sin necesidad de datos etiquetados manualmente.
Aunque la herramienta está actualmente limitada a imágenes estáticas, los investigadores tienen la intención de expandirla al video. Esto podría reducir significativamente los costos para cineastas independientes y creadores de contenido al permitirles ajustar la iluminación después de que se haya capturado una escena, eliminando la necesidad de equipos de iluminación costosos o múltiples rodajes de repetición.