Google ha lanzado la API Gemini Decisions, una herramienta especializada diseñada para evaluar hasta 1,000 preguntas independientes —como comprobaciones de sí/no, selecciones de opción múltiple y puntuaciones por rúbrica— en un solo paso hacia adelante. Impulsada por el nuevo modelo Gemini Decision 1, la API logra una latencia de extremo a extremo de 150 a 250 ms, lo que la hace adecuada para aplicaciones en tiempo real como el enrutamiento dinámico de modelos y las capas de seguridad.
Diseñada específicamente para opciones delimitadas
A diferencia de los modelos generativos estándar que producen texto token por token, la API Gemini Decisions califica las opciones candidatas en un solo paso. Esta arquitectura está optimizada para decisiones de 'conjunto cerrado', donde el objetivo es seleccionar de una lista predefinida de opciones en lugar de generar contenido abierto.
La API admite tres tipos de decisiones específicas: 'noul' para condiciones de sí/no, 'choice' para seleccionar entre 2 y 255 opciones, y 'score' para calificar entradas frente a una rúbrica ordenada. Cada respuesta incluye probabilidades normalizadas y puntuaciones de confianza para ayudar a los desarrolladores a evaluar la certeza del modelo.
“En lugar de generar texto de respuesta token por token, Gemini Decision 1 califica tus opciones candidatas en un solo paso hacia adelante, devolviendo probabilidades y puntuaciones de confianza con una latencia de extremo a extremo de 150 a 250 ms a $0.10 por cada 1M de tokens de entrada con cero tokens de salida facturados.”
— Gemini Decisions API: Fast, calibrated multimodal decisions
Procesamiento multimodal y latencia
El modelo Gemini Decision 1 está construido sobre una arquitectura multimodal nativa, lo que le permite procesar entradas diversas —como emparejar una grabación de llamada con metadatos de cuenta o un PDF escaneado con fotos— simultáneamente. Mantiene un perfil de latencia casi plano incluso cuando el número de preguntas por solicitud aumenta de 1 a 100.
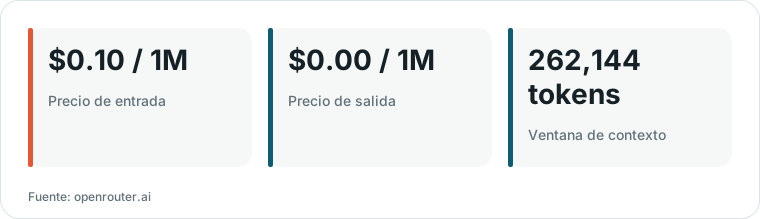
Gráfico elaborado por HN Digest a partir de cifras de openrouter.ai; los valores se muestran como en la fuente.
Al evitar la sobrecarga de la decodificación token por token, el modelo mantiene una latencia de computación mediana entre 50 y 100 ms. Esta eficiencia permite a los equipos utilizar la API como un 'plano de control' de baja latencia para tareas como detectar comportamientos adversarios en consultas de búsqueda o elegir reacciones de emoji en tiempo real.
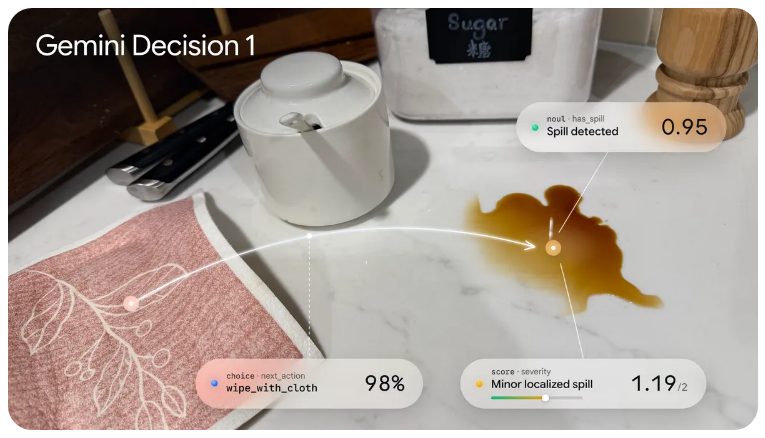
La API está diseñada para aplicaciones en tiempo real y planos de control de baja latencia, como la detección de comportamientos o acciones específicas.
Eficiencia de costos y disponibilidad
La estructura de precios está diseñada para favorecer tareas de alto volumen y baja complejidad. Debido a que la API no factura por los tokens de salida, proporciona una ventaja de costo significativa sobre modelos de propósito general como Gemini 3.5 Flash-Lite cuando se realizan tareas de pruebas comparativas compartidas.
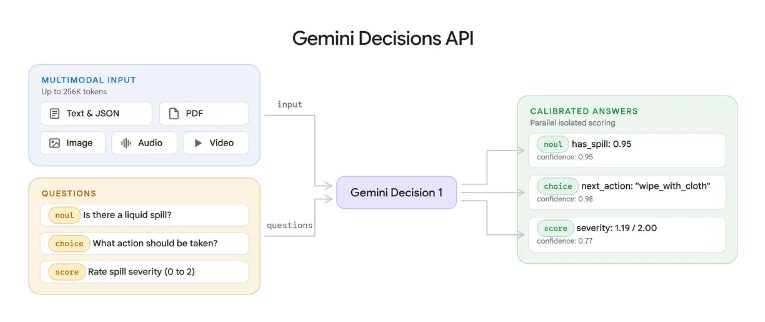
El artículo analiza cómo la API Gemini Decisions logra ventajas significativas de costo y rendimiento sobre los modelos generativos estándar.
Si bien la herramienta es accesible actualmente a través de Google AI Studio y proveedores externos como OpenRouter, su disponibilidad en la plataforma Vertex AI de Google Cloud aún no ha sido confirmada. Los desarrolladores pueden utilizar actualmente la API para construir prototipos rápidos para la clasificación de intenciones, la calificación de contenido y la selección de herramientas.
Qué dicen los lectores de Hacker News
- Nota técnica: Un comentarista sugirió que, aunque la API es más cara que algunos competidores, su capacidad para aceptar entradas de audio y video la hace únicamente útil para casos de uso específicos. comentario ↗
- Escéptico: Un lector expresó escepticismo sobre los motivos de Google, sugiriendo que el producto podría ser una forma de capturar cuota de mercado de clientes existentes ofreciendo una alternativa sólida pero no superior. comentario ↗
- Nota técnica: Un usuario compartió su experiencia utilizando un sistema construido a medida para la indexación de archivos, señalando que prefiere su propia configuración optimizada para procesar imágenes y documentos sobre las ofertas estándar. comentario ↗
- Pregunta abierta: Un comentarista planteó preguntas sobre la mecánica subyacente de cómo estos modelos calculan las probabilidades, preguntándose si el proceso es fundamentalmente diferente de otros clasificadores. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗