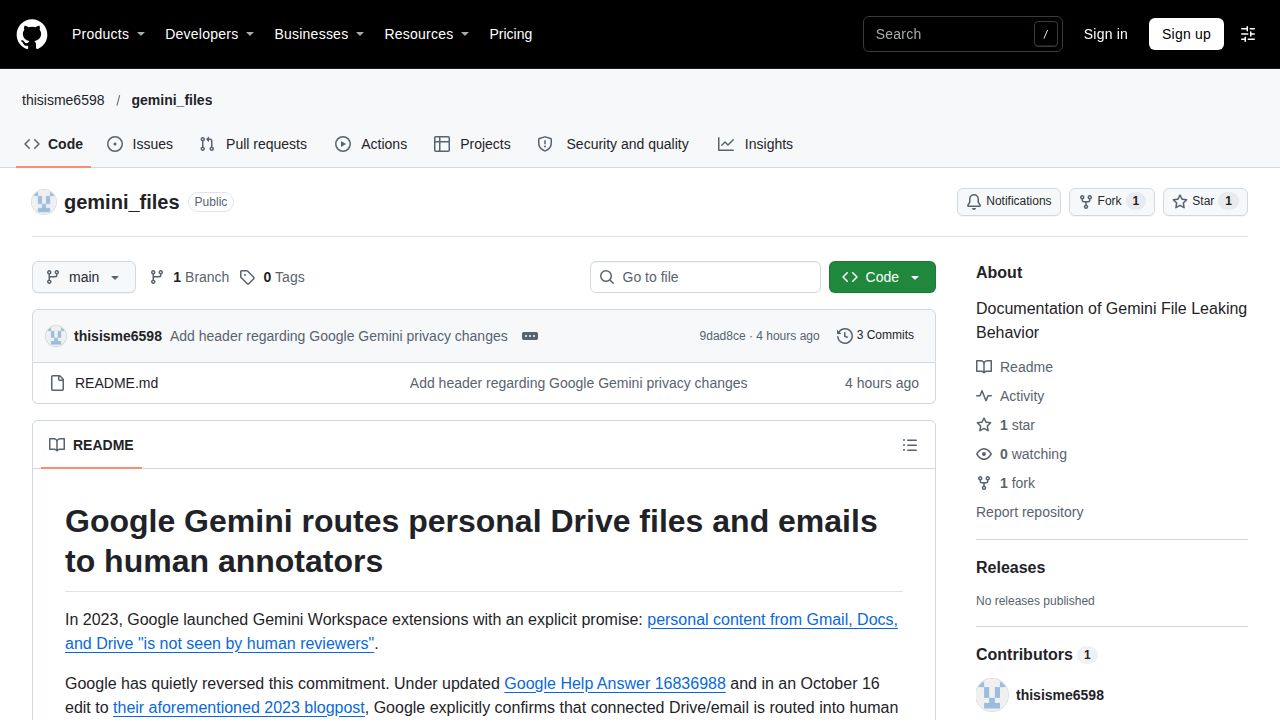
Google ha actualizado sus avisos de privacidad para confirmar que el contenido personal de Gmail, Docs y Drive —cuando está conectado a la IA Gemini— ya no está protegido frente a los revisores humanos. Este cambio contradice una promesa de 2023 de que dichos datos permanecerían aislados, creando un escenario en el que los archivos y correos personales pueden ser ingeridos en los flujos de revisión humana durante las interacciones estándar con la IA.
Reversión de la política sobre el aislamiento de datos
En 2023, Google lanzó las extensiones de Gemini Workspace con la garantía explícita de que el contenido personal de Gmail, Docs y Drive no sería visto por revisores humanos. Sin embargo, una actualización reciente en la documentación de ayuda de Google y una edición posterior en su publicación de blog de 2023 confirman que este compromiso ha sido revertido.
La documentación actualizada ahora incluye advertencias claras de que los revisores pueden ver los correos electrónicos o archivos específicos conectados al servicio. Google aconseja a los usuarios no conectar aplicaciones a Gemini si contienen información confidencial que no desearían que un revisor humano viera.
“Google ha revertido este compromiso discretamente.”
— GitHub - thisisme6598/gemini_files: Documentation of Gemini File Leaking Behavior
Mecanismo de ingesta autónoma
Las pruebas revelan que la ingesta de datos personales ocurre de forma autónoma en segundo plano. Cuando un usuario chatea con la versión de consumo de Gemini y tiene activadas las 'Aplicaciones conectadas', las menciones ambientales de temas personales —como reservas, nombres o facturas— pueden activar una búsqueda en Workspace sin que el usuario utilice explícitamente las etiquetas @Drive o @Gmail.
Debido a que la llamada a herramientas de LLM y la inyección de contexto son probabilísticas, el comportamiento del sistema es no determinista. La consulta de un usuario puede dar lugar a uno de cuatro escenarios: cero recuperación, un resumen de metadatos de alto nivel, una extracción parcial no editada de 2 a 4 frases, o una ingesta de archivo completo donde el texto completo y sin editar de un documento o correo electrónico se extrae al contexto de la sesión.
Limitaciones de la depuración automática
Un obstáculo técnico significativo identificado en la documentación es la incapacidad de los sistemas automáticos para proteger completamente la privacidad del usuario. Los depuradores de Google basados en regex y Reconocimiento de Entidades Nominales (NER) a menudo no pueden desidentificar suficientemente los datos narrativos.
Esto significa que, incluso cuando los datos se procesan, detalles sensibles como números de cuenta, números de confirmación y fechas de transacciones pueden permanecer visibles. Estos elementos, combinados con otra información identificativa como ciudades o eventos específicos, aún pueden vincularse a un usuario individual durante el proceso de revisión humana.
Qué dicen los lectores de Hacker News
- Nota técnica: Un comentarista señaló que, si bien la versión de consumo de Gemini puede involucrar revisión humana, Gemini Workspace y Workspace Intelligence todavía afirman excluir los datos de los flujos de revisión humana. comentario ↗
- Experiencia: Un usuario compartió una experiencia personal en la que una transcripción de Gemini tardó más de 24 horas, lo que le llevó a especular que la intervención manual podría haber sido la causa. comentario ↗
- Alternativa: Varios comentaristas sugirieron que el autoalojamiento de datos en hardware personal es una alternativa viable para aquellos que buscan evitar problemas de privacidad en la nube. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗