Un equipo de investigadores identificó 138 errores de redacción en el código tributario de EE. UU. al traducir los estatutos a Lean, un lenguaje de programación cuyo verificador de tipos puede validar pruebas matemáticas. Al tratar la ley como un conjunto de definiciones verificables, el equipo pudo señalar automáticamente referencias cruzadas rotas, erratas y subdivisiones inconsistentes que existen en el texto oficial del Título 26 del Código de EE. UU.
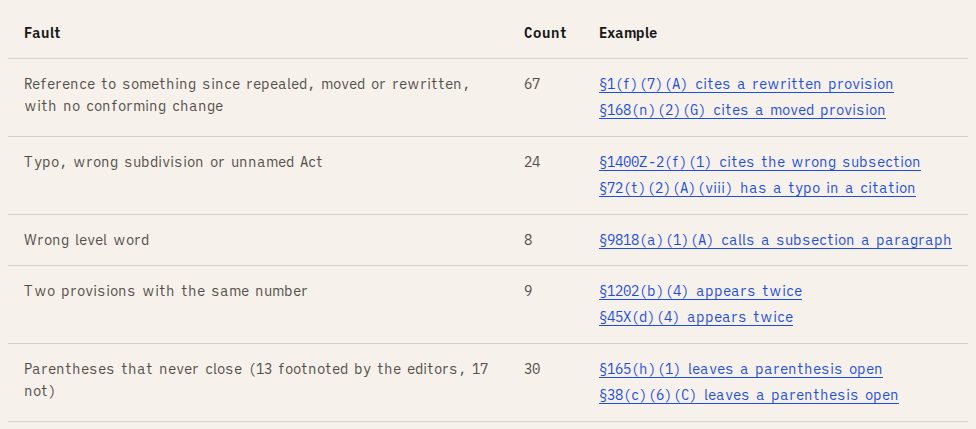
La tabla proporciona ejemplos específicos de los errores de redacción encontrados durante la fase inicial de auditoría.
Auditoría automatizada del Código de Impuestos Internos
Los investigadores utilizaron un analizador para leer cada referencia cruzada en la ley fiscal, incluidas aquellas escritas en texto plano como 'párrafo (2) de la subsección (b)'. Debido a que estas referencias carecen de hipervínculos en el texto oficial, son propensas a convertirse en 'muertas' cuando la ley se actualiza.
Lean verificó cada referencia contra un historial versionado del Código. La suite de pruebas informó 257 hallazgos, que luego un agente de IA categorizó. Aunque muchos eran reglas previstas para períodos pasados, 138 fueron confirmados como fallos reales, tales como citas a disposiciones trasladadas o nombres de subdivisiones incorrectos.
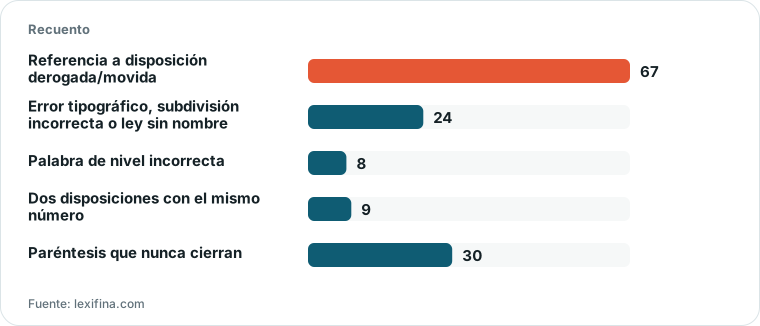
Gráfico elaborado por HN Digest a partir de las cifras reportadas por lexifina.com; los valores se muestran como aparecen en la fuente.
“Nuestro argumento es que apuntar la IA y un verificador de pruebas a un registro versionado de la ley encuentra las contradicciones y errores mecánicos que las personas pasan por alto.”
— Formalizing the US tax code | Lexifina
Reescritura de la lógica fiscal como código verificable
Para ir más allá de las simples comprobaciones de texto, el equipo reescribió el cálculo del impuesto federal sobre la renta de 2025 en Lean. Esto implicó modelar cuatro componentes distintos: ingresos (hasta el ingreso bruto ajustado), deducciones, el cálculo del impuesto (incluyendo el impuesto mínimo alternativo) y créditos.

Este diagrama visualiza la escala y organización del modelo formal en Lean utilizado para representar el código tributario o fiscal de EE. UU.
Debido a que traducir el lenguaje natural a código formal es un paso con 'pérdida de información', el equipo reforzó el modelo probándolo contra cifras publicadas por el IRS y tres programas fiscales independientes. También emplearon un agente de IA adversarial para revisar el código en busca de 'trampas': lógica diseñada para pasar las pruebas sin seguir realmente el estatuto.
Descubrimiento de vacíos ocultos y errores de software
El modelo formal permitió al equipo realizar una 'búsqueda ciega' de estrategias de planificación fiscal. Esto reveló tres nuevos vacíos legales no encontrados en las guías de profesionales, como una ventana específica donde una pareja que vive junta podría ahorrar dinero al presentar declaraciones por separado debido a cómo se limitan los beneficios del Seguro Social.
El proyecto también expuso discrepancias en las herramientas existentes. Por ejemplo, un software fiscal popular no adjuntó el Schedule C a las declaraciones, provocando que los ingresos por trabajo por cuenta propia desaparecieran. Además, el equipo demostró que la Tabla de Impuestos del IRS no es un reflejo perfecto de la fórmula de la ley, mostrando una variación de hasta $6 para muchos contribuyentes.
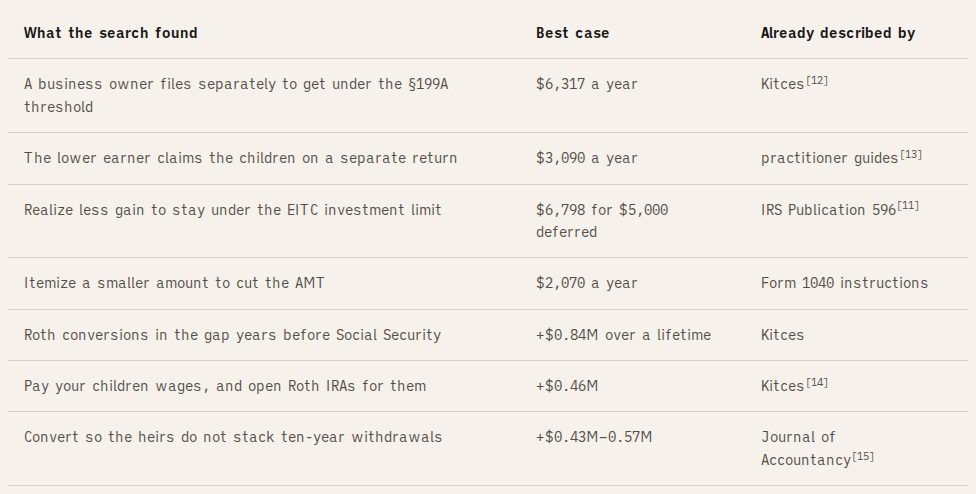
Esta tabla destaca los vacíos legales específicos y los errores de software descubiertos por el equipo de investigación.
Limitaciones y el papel de la interpretación humana
Si bien Lean proporciona una comprobación rigurosa del texto literal de la ley, el proyecto destaca un límite significativo: el 'espíritu' de la ley. Una máquina puede demostrar lo que el texto permite, pero un juez humano sigue siendo el árbitro final de si una interpretación específica es legalmente aceptable en un tribunal de justicia.
Además, la transición del estatuto al código sigue siendo un proceso manual de interpretación. Los investigadores señalaron que, si bien Lean puede demostrar que ciertas deducciones nunca crecen cuando los ingresos aumentan en cada entrada posible, la traducción inicial de la ley a esas definiciones todavía requiere supervisión humana para asegurar que la formalización capture con precisión la intención legislativa.
Qué dicen los lectores de Hacker News
- Experiencia: Un comentarista que trabajó anteriormente en análisis legal señaló que las regulaciones gubernamentales a menudo son intencionadamente inconsistentes, y sugirió que requerir que las leyes sean 'compilables' podría ser una forma interesante de hacer visibles esos conflictos. comentario ↗
- Escéptico: Un lector cuestionó la utilidad específica de usar Lean para este proyecto, preguntando si realmente hay algo que 'probar' en el código tributario o si la herramienta simplemente se está utilizando como un lenguaje de scripting. comentario ↗
- Escéptico: Otro comentarista expresó escepticismo sobre la viabilidad a largo plazo del proyecto, sugiriendo que podría ser otro intento de formalizar leyes que finalmente será abandonado. comentario ↗
- Experiencia: Un comentarista argumentó que muchos vacíos legales son intencionales y que la interpretación final de la ley a menudo recae en jueces humanos que fallan sobre el 'espíritu' de la ley en lugar de solo el texto literal. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗