El nuevo modelo Muse Ember de Meta puede igualar el rendimiento de Claude Haiku 5.5 a aproximadamente un tercio del costo, posicionándolo como una opción de alta eficiencia para flujos de trabajo 'agénticos'. Diseñado específicamente para tareas repetibles como llamadas a herramientas, enrutamiento y análisis de documentos largos, el modelo tiene como objetivo proporcionar una alta inteligencia por dólar para los desarrolladores que construyen sistemas automatizados.
Esta ilustración abstracta sirve como el elemento visual principal para el anuncio de Muse Ember, representando el papel del modelo en flujos de trabajo agénticos complejos.
Eficiencia en la frontera
Muse Ember está diseñado para situarse en la 'frontera de eficiencia' de la tabla de clasificación de Artificial Analysis, lo que significa que ningún otro modelo obtiene actualmente una puntuación más alta por un costo menor por tarea. En las pruebas, demostró un equilibrio superior de inteligencia y precio en comparación con tanto Claude Haiku 5.5 como GPT-6 Luna en diversos entornos de razonamiento.
El modelo tiene un precio de $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida. Estos costos están destinados a facilitar el trabajo de 'subagentes', donde un modelo más grande delega pasos estructurados más pequeños a una base más rápida y económica.
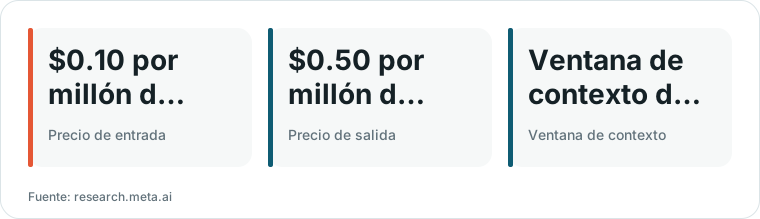
Gráfico de HN Digest basado en cifras de research.meta.ai; los valores se muestran como en la fuente.
Meta estima el costo de Muse Ember en aproximadamente $0.14 por tarea de Artificial Analysis, un punto de precio destinado a hacerlo accesible para el uso de producción de alto volumen en diversos productos.
“Muse Ember ofrece más inteligencia por dólar que Claude Haiku 5.5 o GPT-6 Luna en cualquier entorno de razonamiento: iguala la mejor puntuación de Haiku a aproximadamente un tercio del costo y supera cada configuración de Luna.”
— Introducing Our Smallest, Most Efficient Model: Muse Ember
Rendimiento en codificación y automatización
En las pruebas de codificación, Muse Ember mostró ventajas significativas en latencia y eficiencia de tokens. Por ejemplo, en las pruebas de You.com, el modelo completó misiones de codificación con una latencia p95 de 2.2 segundos, lo que fue de 4 a 13 veces más rápido que los principales modelos de pesos abiertos, mientras utilizaba entre un 36% y un 48% menos de tokens de salida.
El modelo también destacó en las pruebas de automatización, obteniendo un 37.8% en AutomationBench-AA, casi el doble de la puntuación de Claude Haiku 5.5 (13.9%). Esto lo convierte en un candidato para flujos de trabajo empresariales de extremo a extremo, como la evaluación de candidatos frente a informes detallados o la calificación de contratos frente a manuales de negociación.
El modelo está construido para las subtareas de codificación específicas que un agente envía cientos de veces por sesión, como leer archivos, ejecutar pruebas y realizar correcciones específicas.
Seguridad y límites de despliegue
Meta evaluó Muse Ember bajo su Marco de Escalamiento de Superinteligencia, cubriendo riesgos como la ciberseguridad y la pérdida de control. El modelo se mantuvo por debajo de los umbrales de alto riesgo y recibió el mismo entrenamiento de seguridad básico que los modelos fronterizos más grandes de Meta.
A pesar de su eficiencia, Muse Ember no está destinado a ser un reemplazo de propósito general para las tareas de razonamiento más difíciles. La estrategia de Meta implica un enfoque por niveles: Muse Wonder maneja los problemas más difíciles, mientras Muse Ember gestiona las tareas repetitivas de alto volumen que los agentes realizan a lo largo de una sesión.
Límites de evidencia
Si bien la fuente principal destaca la eficiencia y el rendimiento de Muse Ember en codificación y automatización, no confirma explícitamente una ventana de contexto de 1M de tokens ni el soporte nativo para modalidades de audio y video en el texto proporcionado. Estas especificaciones técnicas específicas permanecen sin verificar por la documentación suministrada.
La fuente también señala que algunos resultados de evaluación, como los de OSWorld 2.1, están marcados como 'parciales' o 'binarios', lo que indica que ciertas métricas de rendimiento pueden tener limitaciones en el alcance o en la metodología de puntuación.
Qué dicen los lectores de Hacker News
- Alternativa: Un comentarista señaló que el rendimiento del modelo no pareció mejorar con más tokens de razonamiento, observando que la calidad visual de la salida se mantuvo similar en diferentes niveles de esfuerzo. comentario ↗
- Escéptico: Un usuario sugirió que el sistema de puntuación actual para las negativas del modelo es defectuoso porque trata una negativa a realizar una tarea de la misma manera que una falta de capacidad. comentario ↗
- Experiencia: Un comentarista expresó el deseo de que Meta lance estos modelos para uso local para ayudar a construir una base de usuarios mientras la empresa se queda atrás frente a sus competidores. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗