Google está expandiendo su cartera de Unidades de Procesamiento de Tensores (TPU) de octava generación con dos nuevos sistemas especializados: el TPU 8tx y el TPU 8i Max. Estas adiciones están diseñadas para abordar la 'era de los agentes' de la IA, donde las cargas de trabajo requieren cada vez más entornos de alta seguridad para datos sensibles y la capacidad de razonar a través de grandes cantidades de información simultáneamente.
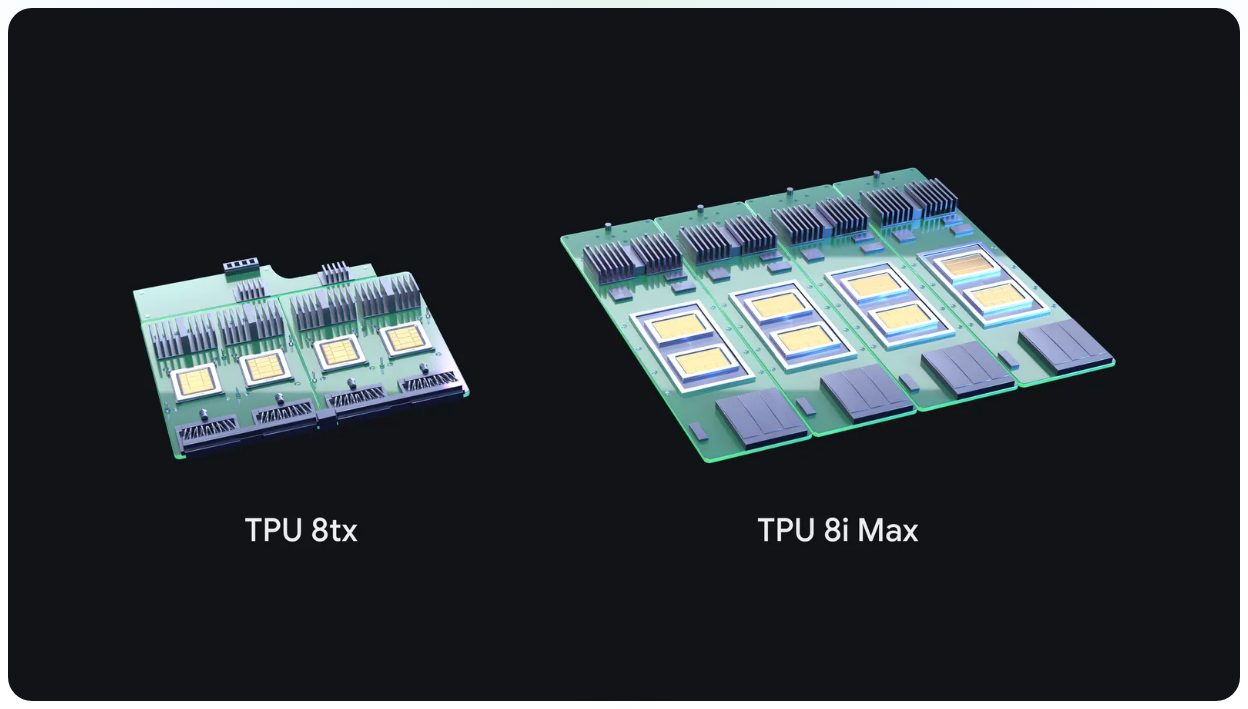
Esta imagen ilustra los dos principales sistemas nuevos introducidos en la cartera de TPU de octava generación =
Hardware especializado para seguridad y contexto
El TPU 8tx está diseñado específicamente para empresas reguladas y gobiernos que necesitan ejecutar modelos de vanguardia junto con datos sensibles. A diferencia del cifrado estándar que protege los datos en reposo o en tránsito, el 8tx construye la seguridad directamente en la capa de hardware, asegurando que los datos permanezcan aislados incluso mientras se procesan en la memoria.
Al combinar una computación de grado de entrenamiento con una red de inferencia rápida, el 8tx permite a las organizaciones ejecutar y personalizar modelos simultáneamente en un solo sistema. Esta configuración permite a los equipos realizar un ajuste fino privado y aprendizaje por refuerzo sin necesidad de migrar datos sensibles entre clústeres separados.
“El TPU 8tx proporciona seguridad a nivel de hardware para datos sensibles, mientras que el TPU 8i Max maneja ventanas de contexto masivas.”
— Our newest TPUs: 8tx and 8i Max, built for the agentic era
Rompiendo la barrera de la memoria con TPU 8i Max
El TPU 8i Max aborda la 'barrera de la memoria', un cuello de botella que ocurre cuando los agentes de IA deben procesar vastas cantidades de datos, como bases de código de software completas o horas de video. Logra esto combinando dos chips TPU 8i en un solo paquete para escalar la computación y la memoria en paralelo.
Al duplicar el ancho de banda de SRAM y HBM del modelo base 8i, el 8i Max garantiza que los procesadores permanezcan equipados con los datos esenciales para que las cargas de trabajo grandes no se detengan. Este diseño también permite a los centros de datos desplegar significativamente más potencia de cálculo por pie cuadrado y por vatio al ajustar el doble de silicio dentro de la huella de rack existente.
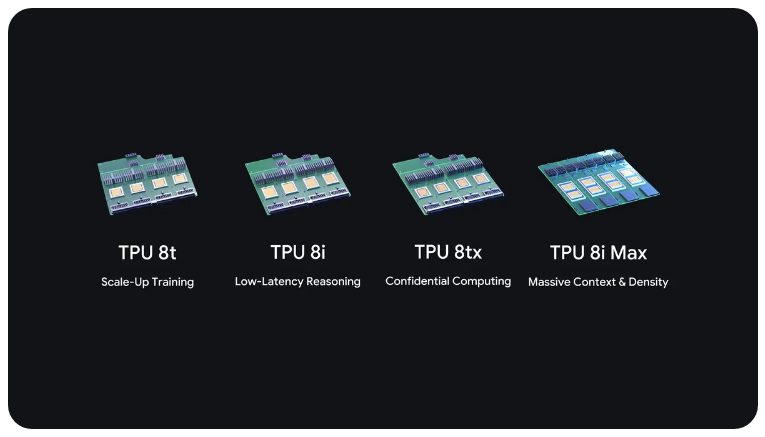
Esta visualización ayuda a diferenciar los nuevos modelos 8tx y 8i Max de los sistemas 8t y 8i existentes.
Modularidad del sistema y accesibilidad para desarrolladores
Google distingue estas nuevas ofertas como 'sistemas' en lugar de solo 'chips'. Debido a que la fabricación de silicio está sujeta a ciclos de larga duración, Google utiliza una arquitectura modular que permite a los ingenieros ajustar rápidamente el empaquetado, la memoria de alta velocidad y las redes ópticas alrededor de los bloques de construcción centrales de la TPU.
Para reducir la barrera de entrada, Google está integrando estos sistemas con una pila de software abierta. Esto incluye TorchTPU, que permite que el código de PyTorch y los modelos de Hugging Face se ejecuten de forma nativa en las TPU, y una nueva suite de agentes TPU que automatiza la incorporación y el ajuste automático de kernels utilizando lenguaje natural.
Métricas de rendimiento y limitaciones
Aunque Google informa que los sistemas 8t y 8i ofrecen hasta 2.7 veces mejor rendimiento de entrenamiento y un 80% mejor relación precio-rendimiento de inferencia que las generaciones anteriores, no se proporcionan cifras específicas para los nuevos modelos 8tx y 8i Max en el anuncio.
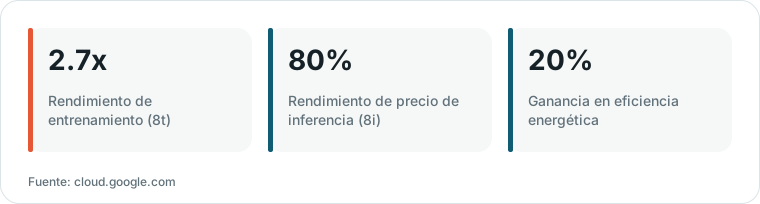
Gráfico elaborado por HN Digest a partir de cifras de cloud.google.com; los valores se muestran como en la fuente.
La documentación actual se centra en mejoras cualitativas, como el 'doble de computación' y una 'penalización de rendimiento cercana a cero' para las funciones de seguridad. Las cifras específicas de vatios por token o las comparaciones directas de precio-rendimiento frente a las últimas ofertas de NVIDIA permanecen sin declarar.
Qué dicen los lectores de Hacker News
- Nota técnica: Un comentarista señaló que el artículo no define el acrónimo TPU como Tensor Processing Unit. comentario ↗
- Escéptico: Varios comentaristas expresaron su frustración por la falta de métricas de rendimiento específicas en el anuncio, como el costo por token o la eficiencia energética, y que no proporciona una ruta clara para que los desarrolladores compren o accedan realmente al hardware. comentario ↗
- Alternativa: Un comentarista señaló que, si bien el anuncio tiene un fuerte enfoque de marketing, se pueden encontrar más especificaciones técnicas a través de otras fuentes en línea. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗