El razonamiento en los modelos de lenguaje de gran tamaño puede redefinirse como un problema de búsqueda de rutas donde el modelo navega por un 'espacio de tokens' de alta dimensión para alcanzar una conclusión válida. Este cambio de perspectiva va más allá de la simple predicción del siguiente token, enmarcando la cadena de razonamiento como una estrategia de navegación dinámica diseñada para evitar callejones sin salida lógicos.
El razonamiento como búsqueda de rutas de tokens
En este marco, el razonamiento no es una progresión lineal de texto, sino una tarea de navegación a través del espacio de tokens posibles. El modelo trata la respuesta correcta como un destino y la cadena de razonamiento como el camino tomado para llegar allí.
Al ver el razonamiento como una búsqueda de rutas, el objetivo se convierte en identificar la ruta más viable hacia una solución. Esto implica evaluar múltiples direcciones potenciales en el espacio de tokens y seleccionar aquellas que mantengan la coherencia lógica.
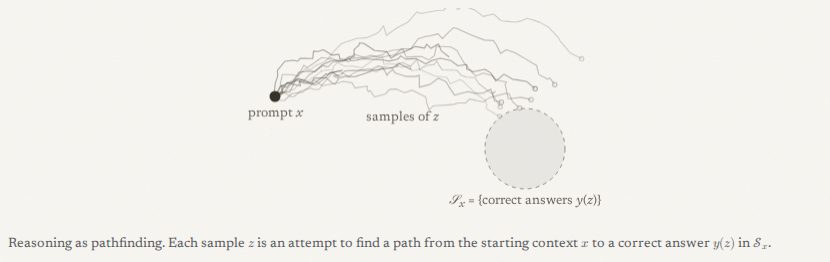
Esta figura ilustra el concepto central del artículo: el razonamiento como una tarea de navegación a través del espacio de tokens para alcanzar un destino.
Ascenso de colinas y evitación de la lógica
El proceso de navegación se comporta como un algoritmo de ascenso de colinas, donde el modelo se mueve hacia un 'pico' de corrección. Una parte significativa de este proceso implica identificar y alejarse de las falacias lógicas que conducirían a una conclusión incorrecta.
Un beneficio principal de este mecanismo es la prevención de fallos lógicos 'absolutamente absurdos'. Al reconocer estos errores tempranamente, el modelo puede pivotar su ruta de razonamiento antes de que el error se propague por el resto de la salida.
Mecanismos de corrección
Los modelos que exponen su 'pensamiento' interno a menudo muestran patrones de autocorrección, como momentos de '¡pero espera!'. Estos sirven como banderas internas que señalan una desviación de la ruta lógica prevista, permitiendo al modelo navegar alrededor del obstáculo.
Mientras el modelo navega a través del espacio de tokens para resolver un prompt específico, ocurre un proceso paralelo durante el entrenamiento donde los pesos del modelo se optimizan. Esto crea una narrativa dual de búsqueda de rutas: una a través de la secuencia de palabras y otra a través de los parámetros subyacentes.
Compensaciones e incertidumbres
Una compensación clave en este modelo es el equilibrio entre exponer la ruta hacia una solución y la capacidad de señalar problemas. El razonamiento eficaz requiere que el modelo no solo conozca la dirección correcta, sino que también reconozca cuándo se ha desviado del curso.
Sigue siendo una pregunta abierta cómo medir con precisión la eficiencia de estos movimientos de 'ascenso de colinas'. Si bien el marco conceptual proporciona una forma de visualizar el razonamiento, las métricas específicas sobre cómo un modelo sopesa un 'fallo lógico' frente a una 'ruta correcta' aún se están explorando.
Qué dicen los lectores de Hacker News
- Alternativa: Un comentarista sugirió que el razonamiento debería medirse tanto por la capacidad de identificar soluciones como por la capacidad de señalar problemas, señalando que prevenir fallos lógicos básicos parece ser un beneficio principal. comentario ↗
- Escéptico: Un lector argumentó que el marco del autor contradice la idea de que la inteligencia necesariamente mejora a través de más razonamiento, lo que podría socavar las suposiciones sobre la auto-mejora recursiva. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗