Los modelos de IA generativa pueden consumir entre 1.4 y 180 veces más energía para producir texto en idiomas que no son el inglés en comparación con el inglés. Esta disparidad es más severa en los idiomas que no utilizan escrituras latinas, como el hindi y el bengalí, que requieren 7.9 y 15.3 veces más energía, respectivamente, para procesar un prompt equivalente. El hallazgo sugiere que la arquitectura actual de los grandes modelos de lenguaje (LLM) crea una barrera significativa de energía y costo para miles de millones de hablantes de idiomas que no son el inglés.

El gráfico visualiza el hallazgo principal del estudio: el aumento significativo en el consumo de energía para idiomas que no son el inglés, particularmente para aquellos con escrituras complejas.
La mecánica del consumo de tokens
El principal motor de esta disparidad de energía es la forma en que los modelos de IA procesan el texto en 'tokens', que son las unidades básicas de datos utilizadas por el modelo. Para escrituras como Devanagari (utilizada en hindi, nepalí y maratí) o bengalí, los caracteres principales pueden cambiar de forma y combinarse con acentos para producir millones de caracteres únicos.
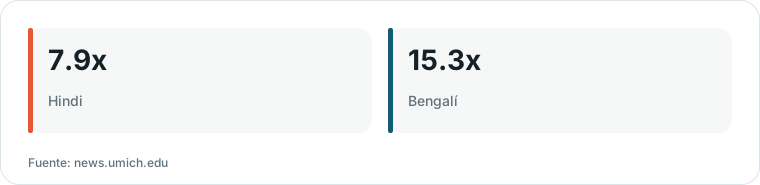
Gráfico elaborado por HN Digest a partir de cifras reportadas por news.umich.edu; los valores se muestran tal como aparecen en la fuente.
Debido a que un mayor número de tokens consume más memoria informática, el modelo tiene menos espacio disponible para procesar información. Esto obliga al sistema a procesar los tokens en lotes más pequeños, lo que aumenta significativamente la energía consumida por token.
Este efecto compuesto significa que cuanto más compleja sea la escritura, menos eficiente se vuelve el proceso de inferencia. Esta disparidad persiste a través de diferentes tamaños de modelos y diferentes tipos de procesadores informáticos.
“Al procesar y producir texto que no es en inglés, la IA generativa consume más energía y, en ocasiones, proporciona respuestas menos precisas, lo que podría reforzar las desigualdades globales existentes, según investigadores de Ingeniería de la Universidad de Michigan.”
— Generative AI uses more energy on non-English text
Un doble castigo para los usuarios globales
Más allá del costo físico de energía, el estudio encontró que los idiomas con mayores requisitos de energía también tienden a producir respuestas menos precisas. Esto crea un 'doble castigo' en el que los hablantes de idiomas que no son el inglés enfrentan tanto costos más altos como resultados de menor calidad.
Esta disparidad crea una posible brecha digital. Debido a que muchas empresas fijan el precio del acceso a la IA basándose en el número de tokens generados, los usuarios de idiomas que no son el inglés pueden enfrentar costos directos más elevados.
Además, la menor precisión para estos idiomas puede hacer que las empresas sean más reacias a atender ciertos mercados, lo que potencialmente excluiría a miles de millones de personas que hablan un idioma que no es el inglés como lengua materna.
Soluciones propuestas y limitaciones
Para abordar estas desigualdades, los investigadores recomiendan que los desarrolladores optimicen los servicios para idiomas específicos en lugar de depender de modelos generalizados. Esto podría implicar el enrutamiento de consultas a modelos adaptados para escrituras específicas o el uso de flujos de trabajo de traducción confiables para convertir los prompts a inglés antes de su procesamiento.
El estudio, que midió tres modelos de código abierto (Qwen 3 de Alibaba, Gemma 3 de Google y Llama 3.1 de Meta), destaca la necesidad de una mayor participación de hablantes nativos. El uso de fuentes externas de hablantes nativos para crear datos de entrenamiento y recursos de alta calidad para idiomas subrepresentados podría ayudar a mejorar la eficiencia y precisión de estos sistemas.
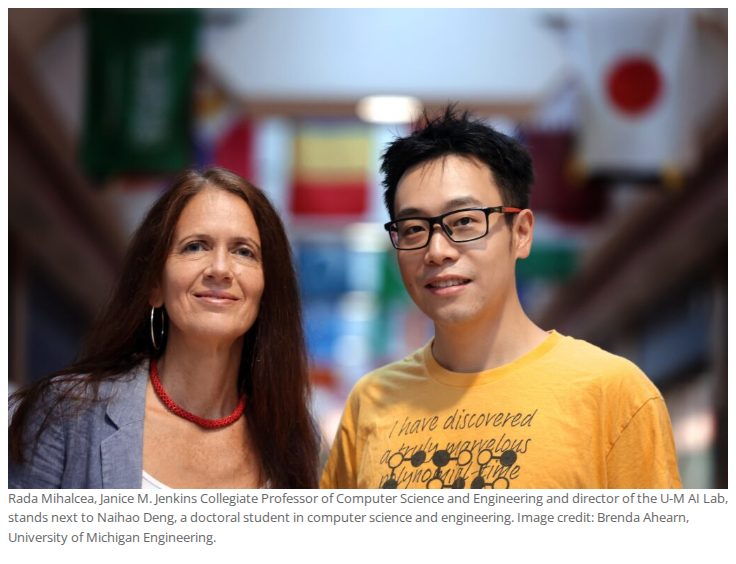
Esta imagen identifica a los investigadores principales de la Universidad de Michigan que realizaron el estudio sobre el consumo de energía basado en el idioma en los LLM.
Alcance de la investigación e incertidumbres
Los hallazgos se basan en mediciones de tres modelos de código abierto específicos y una herramienta de traducción específica (No Language Left Behind) utilizada para crear puntos de referencia. Aún no está claro cómo los modelos propietarios como GPT-4 o Claude manejan la tokenización para las escrituras índicas en comparación con los modelos de código abierto del estudio.
Adicionalmente, el consumo de energía específico de las propias herramientas de traducción no fue un enfoque principal de esta medición, lo que podría influir en los cálculos finales de eficiencia para los usuarios finales.
Qué dicen los lectores de Hacker News
- Alternativa: Un comentarista sugirió que la métrica utilizada para medir la eficiencia podría penalizar injustamente al inglés porque la gran cantidad de material de entrenamiento escrito por hablantes no nativos podría sesgar los resultados. comentario ↗
- Escéptico: Un lector cuestionó la relevancia de los hallazgos del estudio, señalando que los modelos probados tenían aproximadamente 18 meses de antigüedad y preguntando si los resultados seguirían siendo generalizables para los modelos actuales. comentario ↗
- Experiencia: Varios comentaristas compartieron experiencias personales con herramientas de IA que por defecto usan idiomas que no son el inglés o que se niegan a proporcionar respuestas en inglés sin instrucciones específicas. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗