Investigadores de Apple han desarrollado un método para reducir significativamente el coste computacional de la Generación Aumentada por Recuperación (RAG) sustituyendo la búsqueda geométrica tradicional por redes neuronales pequeñas y aprendidas. Al entrenar modelos para predecir la 'función de soporte' de una base de datos, el sistema puede dirigir las consultas a los clústeres de datos correctos con mayor precisión que los métodos estándar basados en centroides, logrando una recuperación hasta 8 veces más rápida para resultados de alta recuperación.
La limitación de la búsqueda geométrica
La Búsqueda de Producto Interno Máximo (MIPS) es el motor detrás de los sistemas de recomendación y RAG, donde un sistema debe encontrar el vector de 'clave' que mejor coincida con una consulta dada. A medida que las bases de datos crecen hasta millones de claves y las dimensiones alcanzan los miles, la comparación exhaustiva se vuelve computacionalmente prohibitiva.
Los métodos aproximados actuales suelen utilizar la agrupación para agrupar las claves alrededor de los centroides. Sin embargo, estos métodos asumen que las consultas se parecerán a las claves. En RAG, esto a menudo es falso: las consultas de los usuarios suelen ser cortas, mientras que las claves son piezas de texto largas y curadas, lo que provoca errores de enrutamiento donde la mejor coincidencia se omite porque se encuentra lejos del centro de su clúster.
Esta imagen explica la limitación fundamental de la búsqueda geométrica donde las consultas podrían ser dirigidas al clúster incorrecto porque están lejos del centroide.
“El modelo SupportNet puede responder a una pregunta más útil que una simple comparación con el centroide: ‘¿Qué tan buena es la mejor clave dentro de este clúster para esta consulta?’
— Faster Retrieval for Better, More Efficient RAG
Arquitecturas de SupportNet y KeyNet
Los investigadores identificaron que la función de valor MIPS es una 'función de soporte' en el análisis convexo. Desarrollaron dos modelos especializados para explotar esto: SupportNet y KeyNet. SupportNet es una red neuronal de entrada convexa entrenada para aproximar la función de soporte de cada clúster, respondiendo a la pregunta: '¿Qué tan buena es la mejor clave dentro de este clúster para esta consulta?'
Esta visualización apoya la transición del enrutamiento basado en centroides al enfoque SupportNet, que considera la mejor clave dentro de un clúster.
Esta imagen ilustra el mecanismo de SupportNet tal como se describe en la sección de arquitectura.
Los modelos KeyNet aprenden a generar directamente el vector de clave que mejor coincide. Al utilizar una pérdida de consistencia derivada del teorema de Euler, estos modelos permanecen geométricamente fundamentados incluso sin restricciones de convexidad explícitas. Ambos modelos se entrenan en la distribución específica de consultas que realmente importan, como aquellas que se encuentran en el benchmark Natural Questions.
Ganancias de rendimiento y compensaciones
En las pruebas, el modelo SupportNet alcanzó una recuperación de enrutamiento del 95% aproximadamente 1.9 veces más rápido que el enrutamiento de centroides tradicional. Al utilizar el modelo más grande, el sistema logró una recuperación del 97% en 1.74 ms, demostrando que las pequeñas redes neuronales pueden superar a las líneas base geométricas incluso teniendo en cuenta su propia sobrecarga de inferencia.
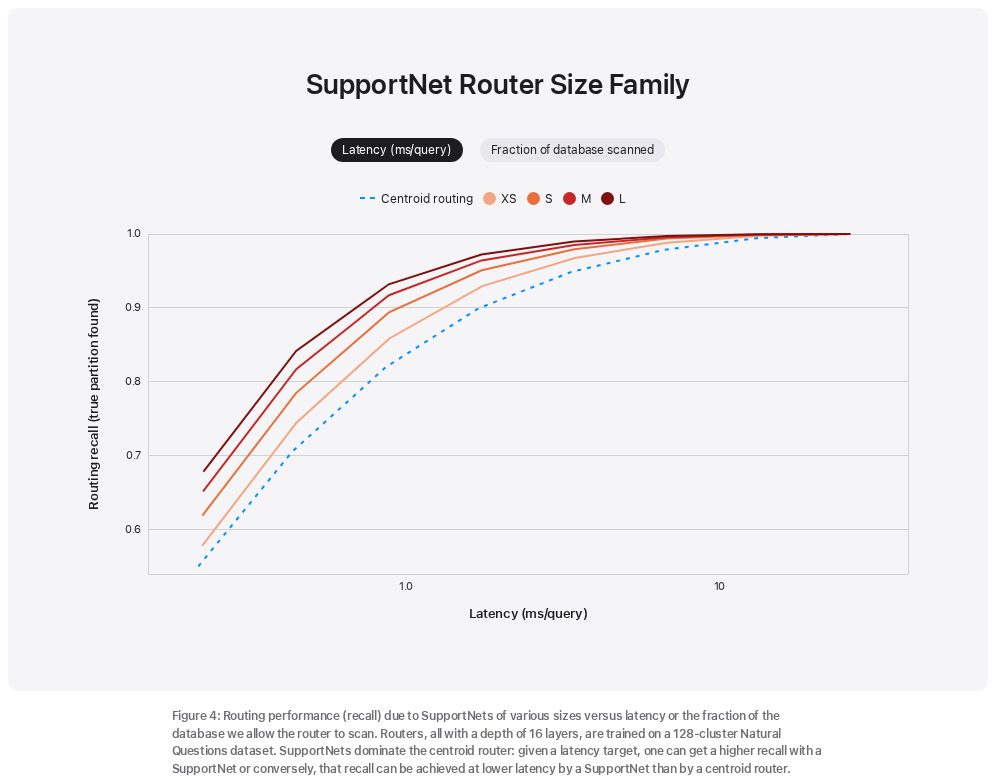
Este gráfico proporciona la evidencia empírica de las ganancias de rendimiento y las compensaciones discutidas en la sección final del artículo.
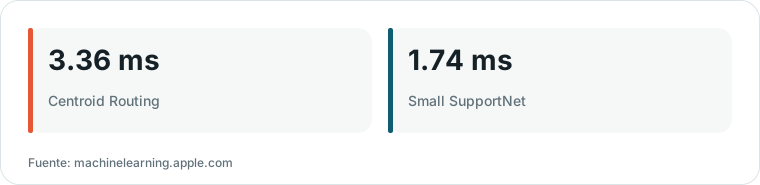
Gráfico elaborado por HN Digest a partir de cifras de machinelearning.apple.com; los valores se muestran como en la fuente.
KeyNet proporciona una ventaja diferente al actuar como un reescritor de consultas. Al transformar una consulta bruta en un vector que está mucho más cerca de la clave objetivo, puede reducir el número de claves que un índice necesita escanear para alcanzar una recuperación del 99% hasta en 11 veces. Si bien estos modelos requieren un coste inicial para entrenarse en una base de datos fija, proporcionan una vía más eficiente para sistemas de producción con distribuciones de consultas estables.
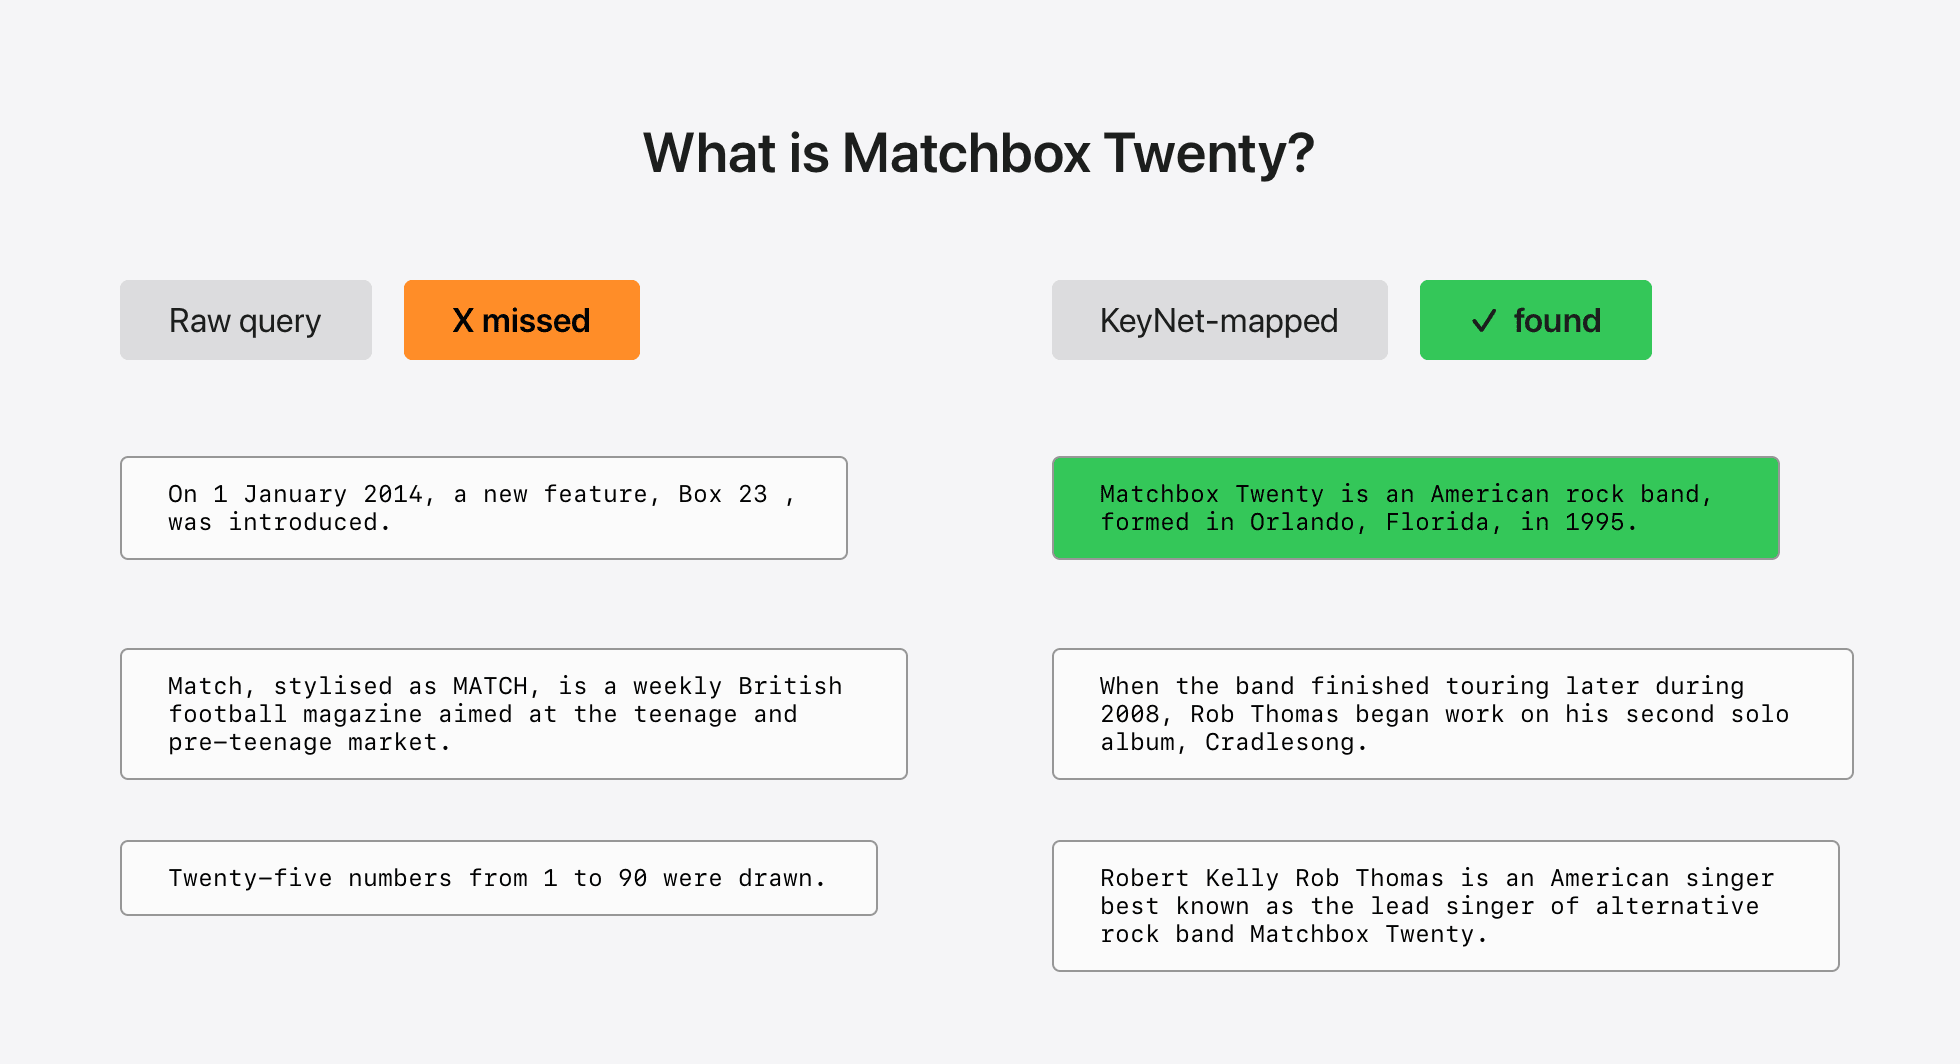
Este ejemplo demuestra la capacidad de 'reescritor de consultas' del modelo KeyNet mencionada en la sección de rendimiento.