Los agentes de investigación de aprendizaje automático pueden optimizar modelos con éxito frente a puntos de referencia fijos sin caer en la trampa del sobreajuste, un fenómeno que contradice las predicciones estándar de los libros de texto. Investigadores de Amazon Science han identificado que esto ocurre porque las estrategias exitosas ocupan una 'región de baja complejidad' del espacio de estrategias, lo que les permite ser destiladas en unos pocos tokens de información.
La paradoja del sobreajuste
En la teoría estándar del aprendizaje automático, evaluar repetidamente un modelo frente a un conjunto de validación fijo debería conducir eventualmente al sobreajuste. Esto sucede porque el procedimiento de entrenamiento 've' los datos de validación, permitiendo que el modelo memorice respuestas específicas en lugar de aprender los patrones subyacentes.
Sin embargo, la comunidad más amplia del aprendizaje automático opera en un bucle distribuido de evaluación de modelos en puntos de referencia de larga data y mejora iterativa de los mismos. A pesar de este constante 'ascenso de colina' contra los mismos datos, los modelos continúan mostrando un progreso genuino y se transfieren bien a conjuntos de datos nuevos y no vistos.
“Las descripciones cortas no pueden hacer trampa porque no hay espacio.”
— Why don’t machine learning research agents overfit?
La hipótesis de la compresión
La explicación para esta paradoja reside en una versión formalizada de la navaja de Ockham: entre las hipótesis que explican los datos igualmente bien, la más simple —la que se puede describir en el menor número de bits— es más probable que generalice. Si una estrategia es demasiado pequeña para registrar los datos de entrenamiento, no puede hacer trampa memorizándolos.
Los investigadores hipotetizan que las estrategias de ML exitosas son inherentemente compactas. Una estrategia ganadora suele consistir en unas pocas elecciones familiares, como una familia de arquitectura específica, un optimizador o un programa de tasa de aprendizaje. Debido a que estas elecciones son pocas, la verdadera dependencia del modelo con el punto de referencia es mucho menor que la larga transcripción de experimentos utilizada para encontrarla.
Probando el cuello de botella de información
Para probar esto, los investigadores utilizaron una configuración de tres agentes que involucraba LLMs. Un agente 'explorador' buscó iterativamente modelos de alto rendimiento utilizando un conjunto de validación. Un agente 'compresor' destiló luego el trabajo del explorador en un prompt muy corto (unos pocos tokens). Finalmente, un agente 'reproductor', que no tenía acceso al conjunto de validación ni a la transcripción del explorador, intentó recrear los resultados utilizando únicamente ese prompt corto.
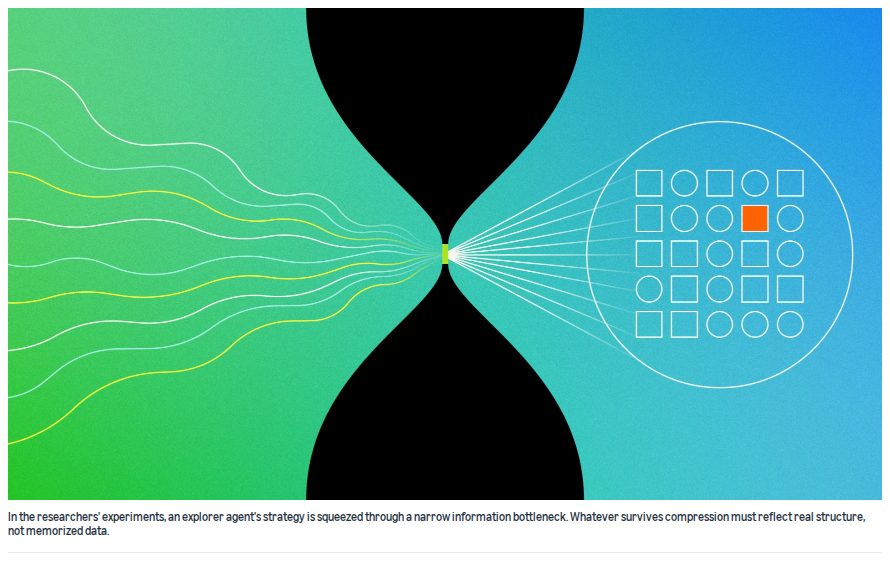
Esta visualización explica el mecanismo experimental central donde la estrategia de un explorador se comprime para ver si conserva su rendimiento sin el ruido memorizado.
Los resultados mostraron que el reproductor pudo igualar el rendimiento del explorador en ocho conjuntos de datos diferentes, incluyendo modelado de visión y de lenguaje. Esto sugiere que la información necesaria para especificar una estrategia exitosa cabe a través de un canal diminuto, confirmando que la estrategia capturó una estructura real en lugar de ruido memorizado.
LLMs como decodificadores de conocimiento
El estudio destaca por qué los LLMs son particularmente efectivos en este proceso. Debido a que poseen un vasto 'conocimiento del mundo' sobre herramientas de ML y algoritmos estándar, pueden desempaquetar mensajes concisos de experto a experto. Si un detalle se deja sin especificar en un prompt corto, el LLM puede completar con valores predeterminados plausibles basados en su conocimiento interno.
Esta imagen ilustra el concepto de que las estrategias de ML de nivel experto pueden comunicarse mediante muy pocos tokens porque el receptor ya posee el contexto necesario.
Si bien esto confirma por qué los LLMs son capaces de razonamiento complejo, también establece un límite claro: cuando los investigadores inducen deliberadamente el sobreajuste, las estrategias resultantes fallan en la prueba de compresión. Estos modelos sobreajustados no pueden ser reproducidos mediante prompts cortos porque su 'conocimiento' está ligado a puntos de datos específicos y no comprimibles.
Qué dicen los lectores de Hacker News
- Nota técnica: Un comentarista sugirió que los modelos de aprendizaje automático tienden a evitar el sobreajuste principalmente cuando el número de puntos de datos supera significativamente al número de parámetros. comentario ↗
- Escéptico: Un lector argumentó que los modelos de IA modernos son en realidad ejemplos primordiales de sobreajuste, señalando que a menudo exhiben alucinaciones y degradación de contexto a pesar de sus altas puntuaciones en puntos de referencia. comentario ↗
- Escéptico: Varios comentaristas expresaron escepticismo sobre la calidad del artículo, describiéndolo como 'AI slop' y criticando el uso intensivo de estilos de escritura generados por IA. comentario ↗
- Nota técnica: Otro usuario señaló que el aprendizaje automático trata fundamentalmente sobre la generalización y que memorizar patrones no es lo mismo que el aprendizaje por repetición. comentario ↗
Resumen de opiniones del hilo de Hacker News; no son hechos verificados. Leer el debate completo ↗