Anthropic 已展示其 Claude Mythos Preview 模型可以在大约三天内将 AI 工作负载部署到 AMD MI355X GPU 上,而这一过程在历史上通常需要 6 到 12 个月的手动工程。通过利用该模型自主编写近 100% 的必要内核,该公司声称可以在“基本无需人工干预”的情况下实现这一目标,显著加速了非 Nvidia 硬件进入其计算集群的进程。
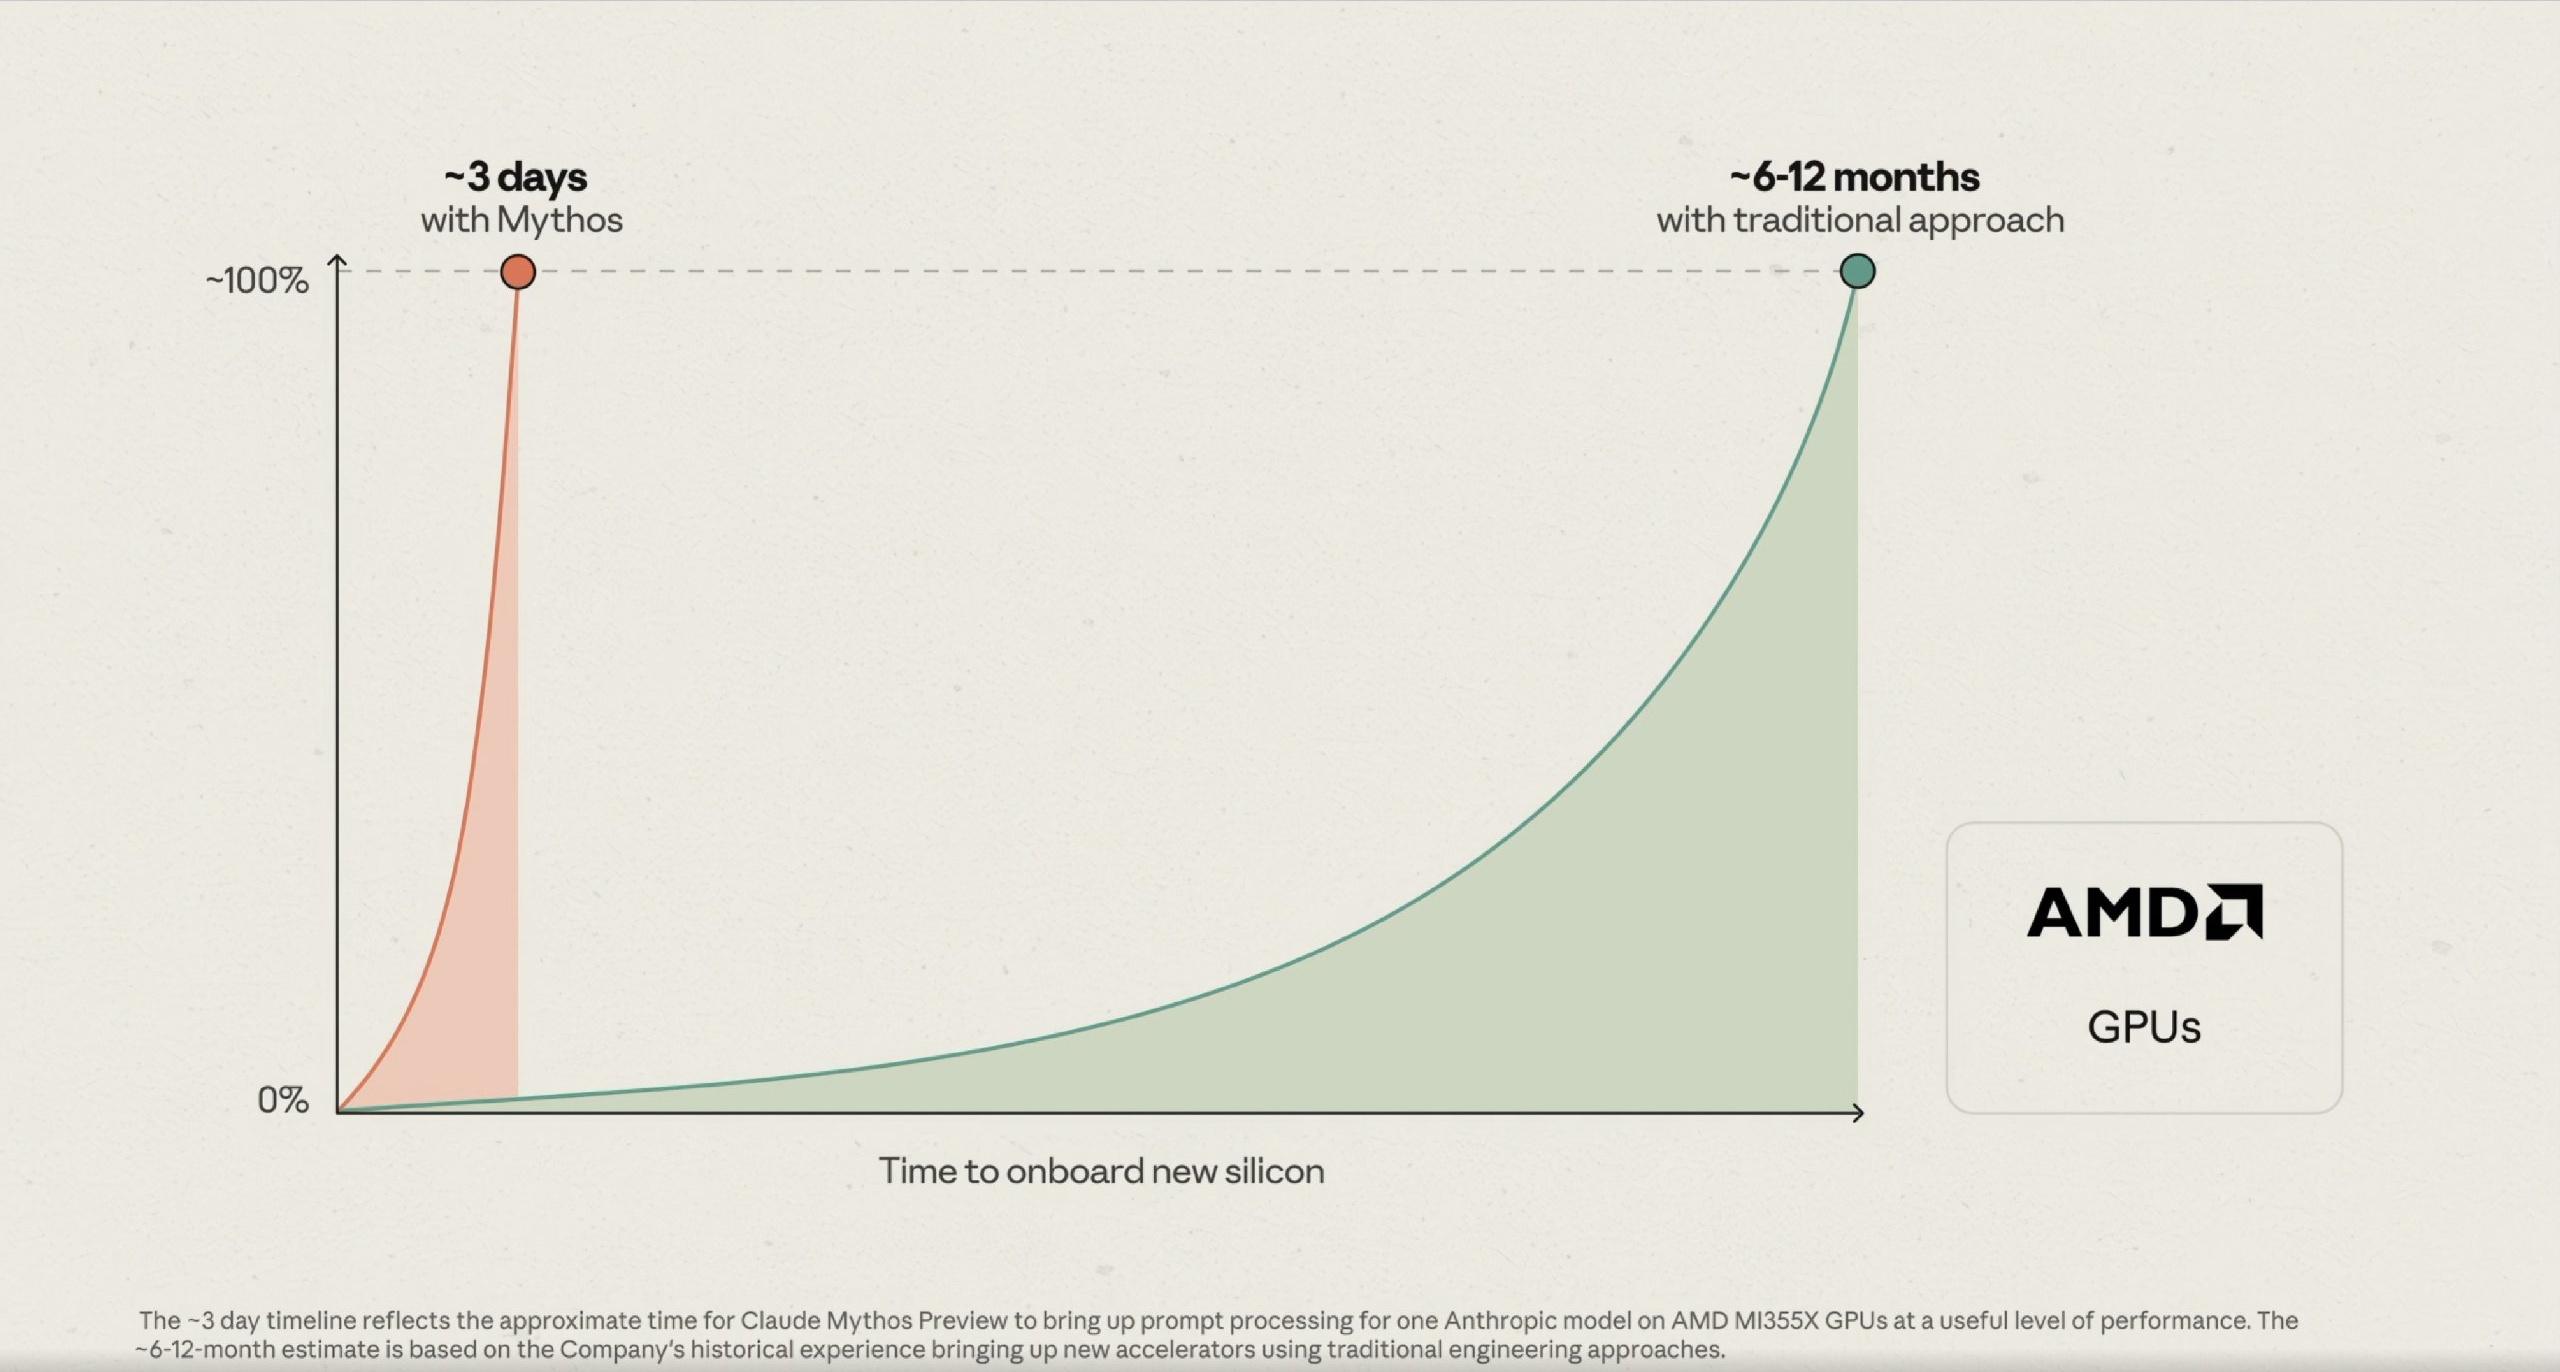
该图表直观地展示了文章的核心主张:将数月的工程任务缩短至仅需三天。
自动化 CUDA 壁垒
多年来,Nvidia 在 AI 领域的统治地位一直受到 CUDA 的支持,这是一个成熟的软件层,使得开发者很难将模型移植到竞争硬件上。传统上,为新加速器定制 AI 代码需要数十名工程师工作数月来编写和优化底层内核。
Anthropic 使用 Claude Mythos 自动化这一过程表明竞争格局正在发生转变。通过自主生成这些内核,该公司可以绕过历史上一直保护 Nvidia 市场地位的传统软件障碍。
HN Digest 根据 tomshardware.com 报告的数据绘制;数值按原文显示。
自主适配机制
这三天的周期专门涵盖了在 AMD MI355X GPU 上运行一个 Anthropic 模型时的提示词处理(prefill),且达到了“有用的性能水平”。该模型处理了移植或编写内核的复杂任务,从而允许 AI 与 AMD 芯片的特定架构进行通信。
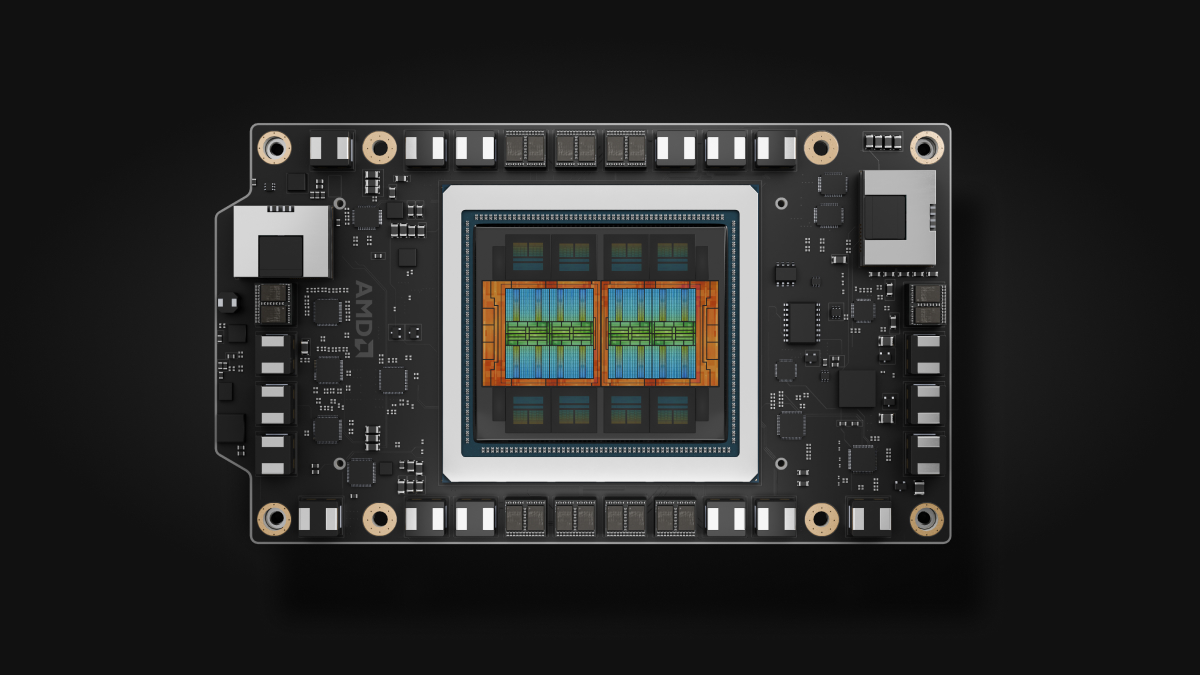
这张图片提供了适配过程中讨论的特定硬件(AMD MI355X/MI350 系列)的视觉展示。
这种方法与现有的工具(如 AMD 的 HIPify,旨在将 CUDA 代码转换为 AMD 的 ROCm 平台)相比具有优势。AMD 的领导层指出,Claude 可能比 HIPify 更有效,因为它结合了网络搜索功能来处理复杂的各种技术要求。
战略意义与局限性
Anthropic 的策略包括维护一个多样化的通用计算池,以避免过度依赖单一供应商。这种多芯片方法允许公司利用 Google 的 TPU 等专用硬件,这些硬件现在可以原生运行基于 PyTorch 构建的模型。
这张图片展示了战略意义部分提到的“通用计算池”。
然而,关于这一转变仍存在一些不确定性。Anthropic 尚未澄清这三天的周期是否包含模型推理的“解码”(replying)步骤,且目前尚无公开数据将这些 AI 编写的内核性能与 Nvidia 的原生性能进行对比。此外,虽然 AI 可以编写代码,但物理硬件仍然是瓶颈,因为智能体仍需要 GPU 来测试和验证生成的内核。