Anthropic 发布了 Claude Fable 5.2 和 Claude Mythos 5.2,这些模型专门为处理软件迁移和硬件工程等高复杂度技术挑战而设计。在预发布测试期间,这些模型仅用 30 小时就成功形式化了费马大定理的证明,并从零开始设计了三个可运行的电子设备。这些更新旨在为雄心勃勃的开放式技术工作提供比标准 Claude Opus 5.5 更高效、更低成本的替代方案。
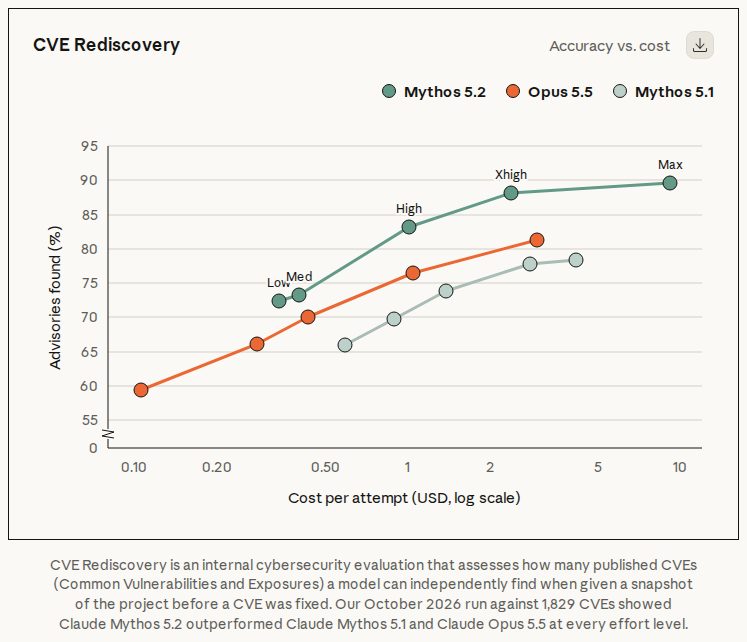
此视觉效果支持关于模型在网络安全和高复杂度技术挑战中能力的声明。
架构与访问层级
Claude Fable 和 Claude Mythos 共享相同的底层模型架构,但在安全配置上有所不同。Fable 5.2 专为通用可用而设计,具有强大的网络安全和生物学防护以防止滥用。相比之下,Mythos 5.2 仅保留给通过 Anthropic 的生命科学和网络验证项目寻求网络安全或生物医学研究有益应用的组织。
Anthropic 将这些模型定位为最雄心勃勃的技术工作的工具。虽然 Fable 5.2 可以作为“顾问”帮助较小的模型解决难题,或作为“编排者”委派简单任务,但公司仍建议将 Claude Opus 5.5 作为大多数标准编程和知识任务的主要“日常驱动”模型。
性能与效率提升
5.2 更新在速度和成本效益方面提供了显著改进。用户可以期待比 5.1 版本快 30% 的输出速度,且价格更低。此外,还提供“快速模式”,可将 token 生成速度提高多达 2.5 倍,但其价格较高,为每百万输入 token 16 美元,每百万输出 token 80 美元。
HN Digest 根据 anthropic.com 报告的数据绘制的图表;数值按来源所示显示。
在实际应用中,Fable 5.2 展示了高水平的工程判断力。例如,它被用于将生产服务从 Python 迁移到 Rust, resulting 出了一个更可靠且启动速度快约 26 倍的服务。它还成功协调了 1,000 多个子代理,在八天内从一个空文件夹中构建了一个原型操作系统。
基准测试对比与局限性
基准测试数据表明 Fable 5.2 在多个类别中超过了 Opus 5.5。在 FrontierCode 2.0 基准测试的“代理编程”中,Fable 5.2 在“极高投入”下达到了 49.1% 的分数,这是 Anthropic 测试的所有已发布模型中的最高分数。它在硬件工程(BenchCAD 2.1)和视觉图表识别(Chartography)方面也表现出显著领先。
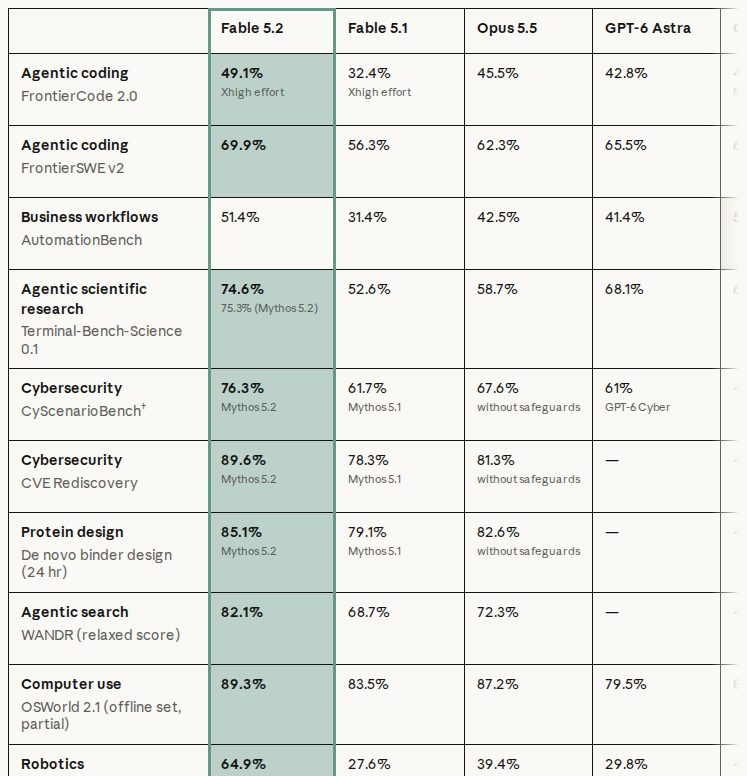
此表全面概述了新模型与标准 Opus 模型相比在不同技术基准测试中的表现。
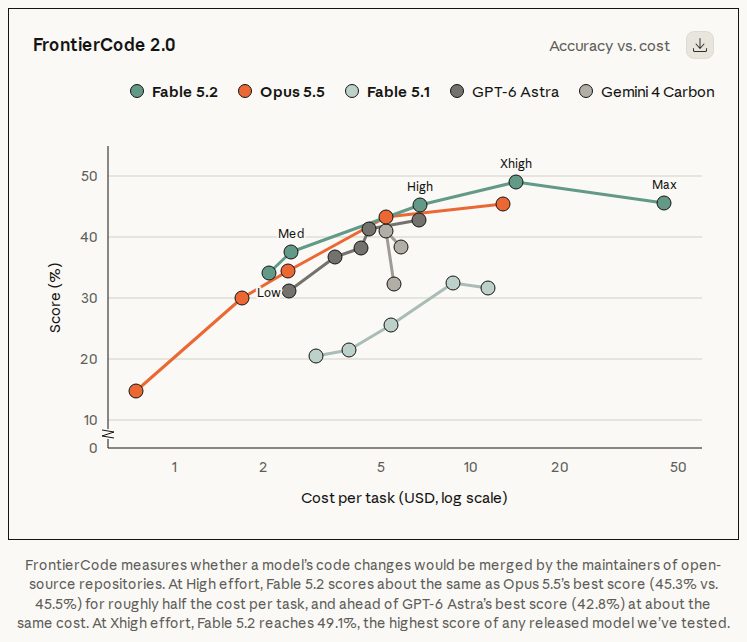
该图表展示了 Fable 5.2 在代理编程任务中的特定性能提升和成本效益。
尽管取得了这些进步,但在模型选择方面仍存在明显的权衡。Fable 5.2 针对高投入、复杂的任务进行了优化,其产生的成本约为 Opus 5.5 的一半。然而,对于常规工作流,公司建议,为了看到比 Opus 5.5 明显的优势而所需的复杂度提升,对于并非所有用户都是必要的。
Hacker News 读者的反应
- 亲身经验: 一位使用过该模型的评论者报告称,它比之前的版本明显更快、更可靠,并指出它成功避免了生成缓慢和输出 token 溢出等常见问题。 评论 ↗
- 亲身经验: 一位用户分享说,他们在一个包含 600k 行代码的冷门 Fortran 代码库上测试了该模型,并对其编程能力感到惊讶,据称该模型将他们的计算材料科学工作加速了 36 倍。 评论 ↗
- 质疑: 几位评论者对报告的基准测试表示怀疑,质疑为什么某些模型与特定的竞争对手进行比较,以及为什么投入与努力的曲线似乎与可用数据不一致。 评论 ↗
- 疑问: 一位评论者质疑高能力模型对于标准工作流是否必要,并建议当前的 Opus 5.5 版本可能已经足以支持大型项目的激进软件开发。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗