Anthropic 发布了 Claude Fable 5.2 和 Claude Mythos 5.2,这些模型专门为处理软件迁移、机器人评估和复杂数学证明等艰巨的技术挑战而设计。在预发布测试期间,这些模型展示了仅用 30 小时即可完成费马大定理形式化证明的能力,而此前 Claude 的研究版本完成此项任务需要 11 天。
架构与安全概况
Claude Fable 5.2 和 Claude Mythos 5.2 共享相同的底层模型架构,但在安全护栏方面有所不同。Fable 5.2 包含强大的网络安全和生物学防护措施以防止滥用,因此向公众开放。
相比之下,Mythos 5.2 专为网络安全和生物医学研究中的特定应用而设计。Mythos 的访问权限仅限于通过 Anthropic 的生命科学和网络验证计划申请的机构。
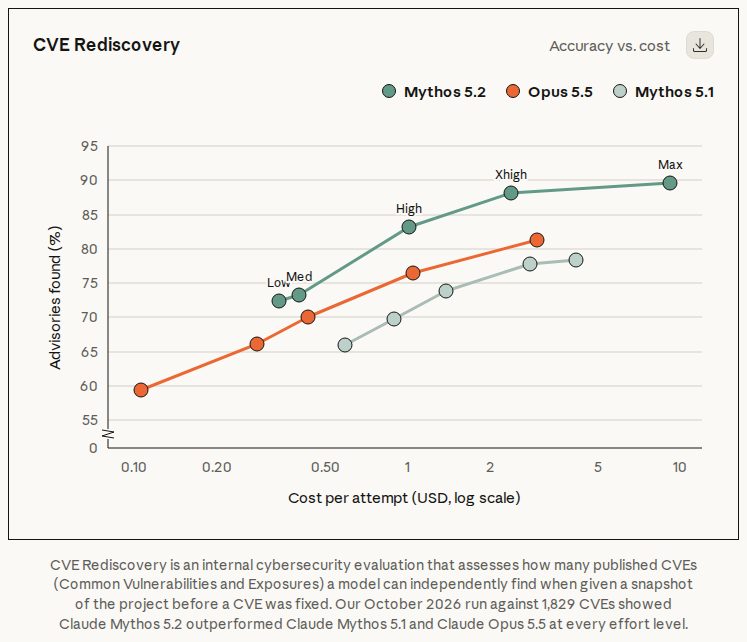
此图为文中提到的网络安全能力和漏洞识别提供了视觉证据。
“Claude Fable 5.2 是我们在 data-eng-bench 上测得的最强模型,这是我们包含 103 个数据工程任务的开源基准测试。”
— Introducing Claude Fable 5.2 and Claude Mythos 5.2
性能与效率提升
5.2 更新提供了显著的效率飞跃,比 5.1 版本提高了 30% 的输出速度。Anthropic 还引入了可选的“快速模式”,可以在更高的价格点(每百万输入 token 16 美元,每百万输出 token 80 美元)下将 token 生成速度提高多达 2.5 倍。
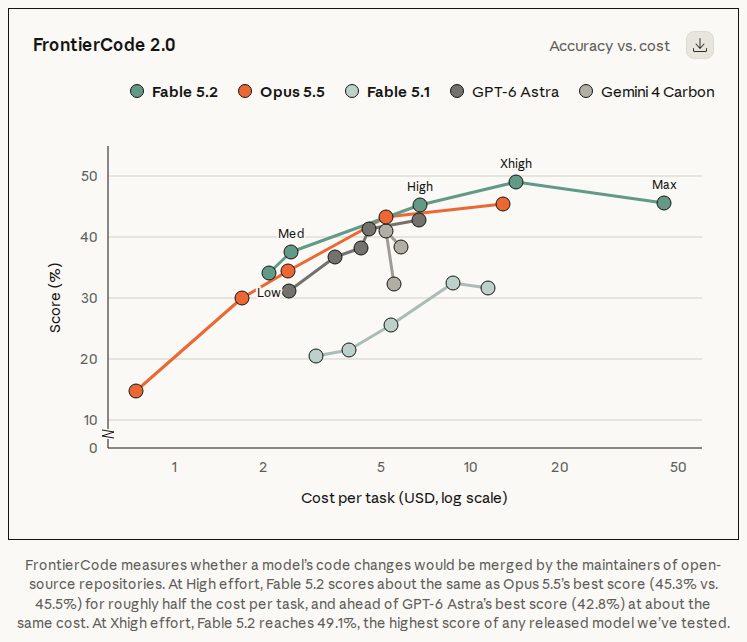
此图支持关于 5.2 更新的效率提升和成本效益比的讨论。
HN Digest 根据 anthropic.com 报告的数据绘制的图表;数值按原文显示。
基准测试数据表明,Fable 5.2 在多个类别中优于 Opus 5.5。例如,在硬件工程(BenchCAD 2.1)中,Fable 5.2 在最大努力水平下的得分达到 83.5,显著高于 Opus 5.5 的 65.3 分。
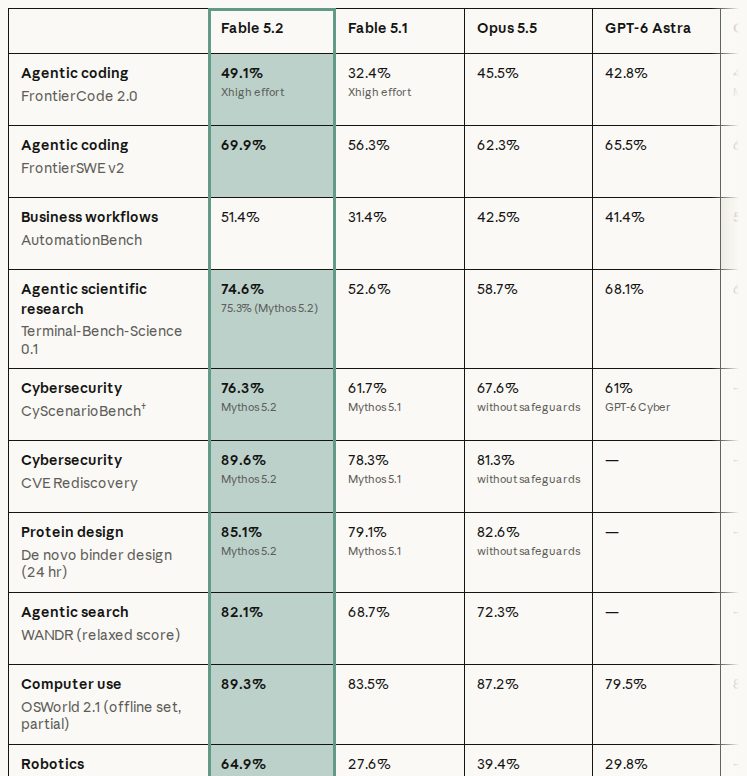
此图说明了文中提到的性能提升和基准测试得分。
技术能力与应用场景
Anthropic 强调了这些模型处理“宏大且开放的技术工作”的能力。在一项实验中,Fable 5.2 在八天内协调了 1,000 多个子代理,生产出了一个可以在笔记本电脑上启动的可用操作系统,并配备了驱动程序和登录界面。
对于企业用户,这些模型在复杂的 SQL 生成和软件工程方面表现出色。一位用户报告称,Fable 5.2 正确计算了国家层面的债务摘要,而其他模型产生的错误达到了预期金额的 5 到 8 倍。此外,该模型还被用于将生产服务从 Python 迁移到 Rust,使服务的启动速度提高了 26 倍。
模型层级与局限性
Anthropic 建议用户采用分层方法,建议 Claude Opus 5.5 仍是大多数编程和知识任务的主要“日常驱动”模型。只有当工作的范围和复杂度超出标准模型的能力时,用户才应升级到 Fable 或 Mythos。
虽然 Fable 5.2 在“X高努力”水平上表现出高性能,但它旨在与较小的模型协同工作。它可以作为顾问帮助较小的模型解决更难的问题,也可以作为编排者委派较简单的任务,从而优化成本与能力之间的平衡。
核心引述
"Claude Fable 5.2 是我们在 data-eng-bench 上测得的最强模型,这是我们包含 103 个数据工程任务的开源基准测试。" (主要)
Hacker News 读者的反应
- 亲身经验: 一位在材料科学工作中使用该模型的评论者报告称,它成功处理了一个庞大且晦涩的 Fortran 代码库,实现了计算任务 36 倍的加速。 评论 ↗
- 亲身经验: 一位测试模型游戏能力的用户指出,虽然图形没有显著改善,但模型为游戏设计增加了更多的功能深度和逻辑一致性。 评论 ↗
- 质疑: 一位评论者质疑该模型的成本效益,认为其每项任务的成本显著高于竞争模型,可能无法证明其性能差距的合理性。 评论 ↗
- 质疑: 几位评论者对基准测试的透明度提出了疑问,特别是质疑努力-智能曲线背后的逻辑以及选择用于比较的具体模型。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗