在 Anthropic,Claude Code 团队已经达到了一个规模,其中近 90% 的代码库是由 AI 智能体编写和审查的。为了在如此大的规模下保持质量,团队已从以人为中心的审查周期转向“验证循环”——这是在人类看到拉取请求(pull request)之前,由智能体根据特定证据验证自身工作的自动化流程。
验证循环的机制
验证循环是一个迭代周期,其中 AI 智能体检查自己的工作——运行测试、代码检查工具或自定义检查——并尝试自动修复故障。通过自动化这些步骤,团队可以并行运行数十甚至数百个智能体,而人工检查则限制开发者一次只能监督一到两个智能体。
团队优先考虑三种特定的测试类型:端到端(E2E)测试、属性测试和差异测试。E2E 测试被认为是最高效的,因为它们描述了真实的用户流程(例如将商品加入购物车),并提供明确的“完成”标准,智能体很难绕过这些标准。
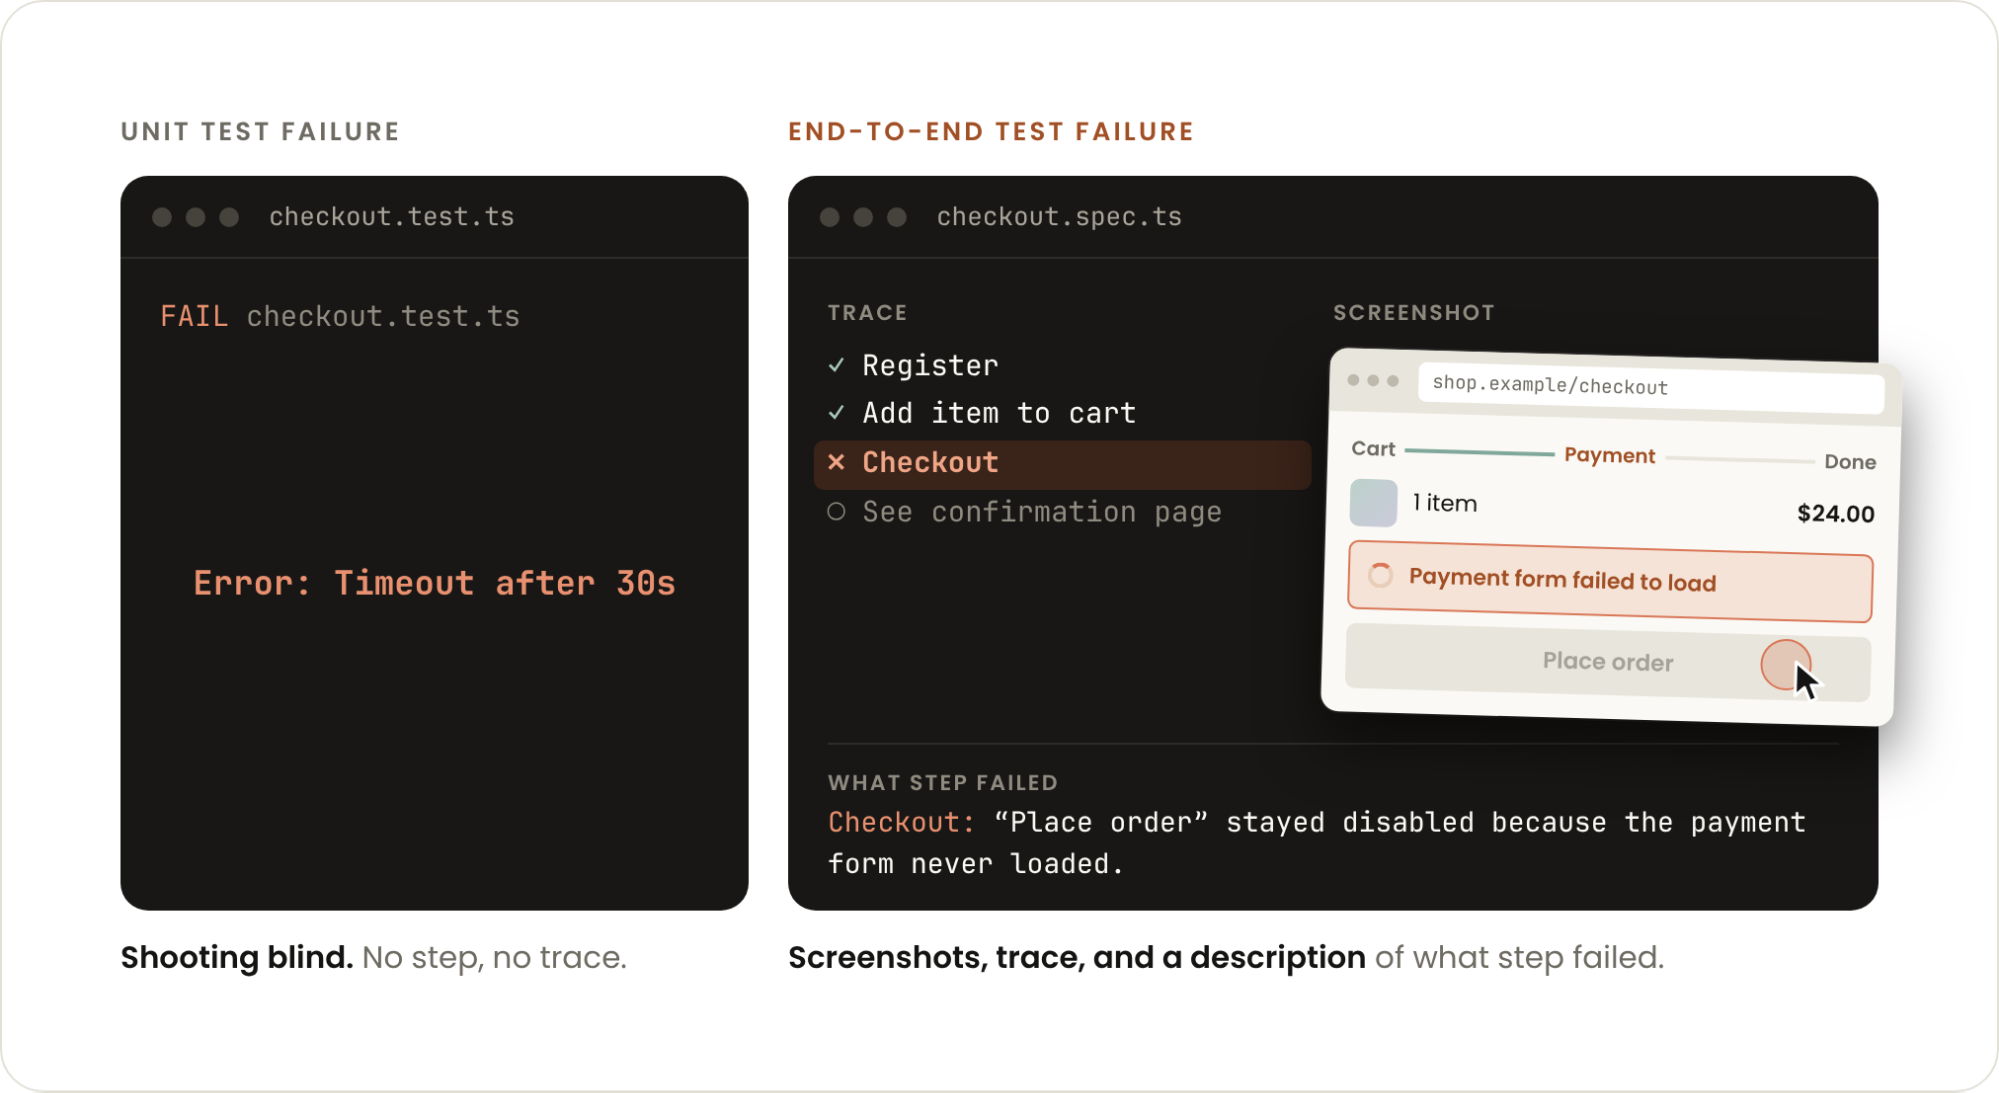
此视觉效果展示了为什么团队优先考虑端到端测试,因为它们提供具体的故障证据,智能体更难忽略或“欺骗”。
该图表支持了 E2E 测试最有效的说法,因为它们提供明确的“完成”标准和视觉证据。
“验证循环是让您可以将更多工作委托给 Claude 的基石。如果没有它们,您实际上一次只能运行一到两个 Claude,因为您必须亲自检查所有内容。”
— How the Claude Code team thinks about verification / claude.dev Blog
测试边缘情况和不变性
为了捕捉标准提示词可能遗漏的错误,团队采用了属性测试。这些测试使用 `fast-check` 或 `Hypothesis` 等库来生成数千个输入,以证明即使在模糊的边缘情况下,不变性(例如“账户余额永远不能变为负数”)依然成立。
对于功能必须保持完全一致的大规模迁移,团队使用差异测试。这些测试同时运行旧系统和新系统,并使用相同的输入,将旧系统作为“预言机”来识别新实现中的任何差异。
将规则编成技能
Anthropic 将这些手动检查编成“技能”——即 `.claude/skills/` 文件夹中的 Markdown 文件,定义特定的行为和允许使用的工具。例如,“验证”技能可用于启动模拟器并检查应用程序,为智能体提供在运行系统上的“手和眼睛”。
为了防止智能体绕过自身的约束,团队确保验证规则是从基础分支而非拉取请求本身读取的。这可以防止智能体修改用于判断其输出的检查项本身。
人工干预与可靠性
虽然目标是自动化,但系统包含一个“人机协同”触发器:如果智能体在三轮迭代后仍无法解决检查项,它将停止并请求人工关注。这确保了复杂的障碍会被升级处理,而不是被忽略。
团队还维护了一个包含 39 个项目的可靠性清单,每个项目都有一个可以从 diff 中读取的触发器。Claude 读取 diff 并仅检查触发器匹配的项目——通常为 3 到 10 个——这样就无需任何人去记忆过去的故障。
Hacker News 读者的反应
- 疑问: 一位评论者对运行大量并行验证循环的高成本表示担忧,指出目前仅运行几个智能体的 Token 费用就已经非常显著了。 评论 ↗
- 疑问: 一位评论者指出,虽然团队声称 90% 的代码由 AI 编写,但他们更感兴趣的是了解代码库中剩余 10% 的性质。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗